Erste Feinabstimmung und Iterationsschleife
Stimme vortrainierte YOLO26-Gewichte mit den Standardeinstellungen fein ab, ordne die Klassen nach AP und zähle dabei übersehene sowie verwechselte Objekte. Leite aus der schwächsten Klasse die nächste Korrektur am Datensatz ab.
Der Übungslauf in dieser Lektion erzielt einen mAP50 von 0,66, was nach einem Problem mit der Lernrate klingt. Eine Tabelle nach Klassen zeigt jedoch etwas anderes: cup enthält 14 annotierte Objekte in der Validierungsmenge, und das Modell erkennt kein einziges davon. Das ist ein Datenproblem, das sich mit keinem Hyperparameter beheben ließe. Betrachte den ersten Lauf als Diagnose, die dir zeigt, welche Klasse du als Nächstes korrigieren solltest.
Praxisnah
Mit vortrainierten Gewichten beginnen#
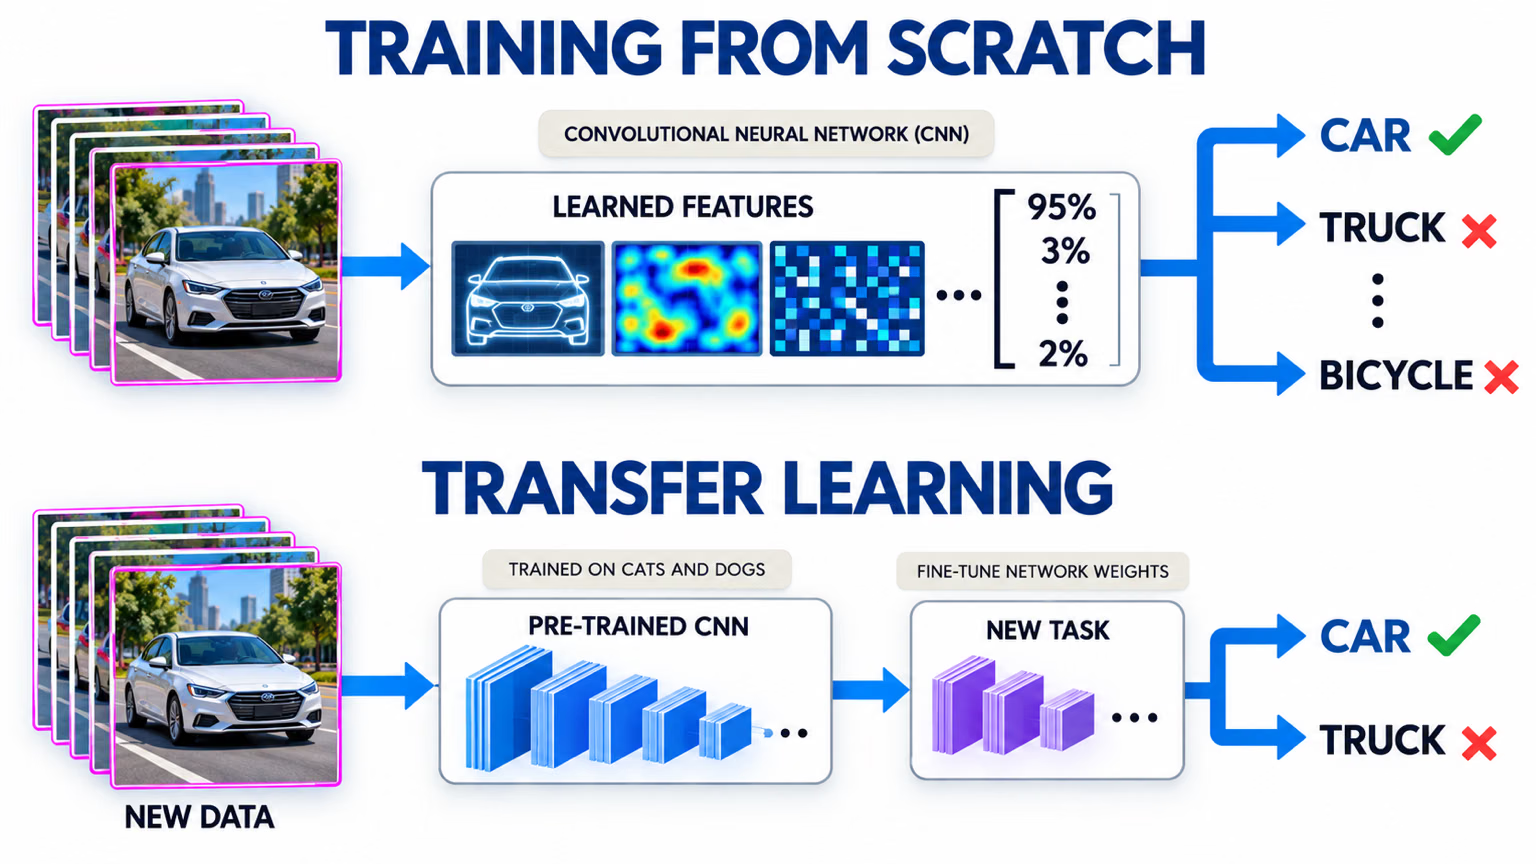
Bei der Feinabstimmung werden Gewichte verwendet, die bereits Kanten, Texturen und Formen erkennen. Dadurch konvergiert das Modell schneller und benötigt deutlich weniger Daten als beim Training mit zufälligen Gewichten. Wähle den zur Aufgabe passenden YOLO26-Checkpoint:
| Aufgabe | Vortrainierter Checkpoint | Vortrainiert auf |
|---|---|---|
| Erkennung | yolo26n.pt | COCO |
| Segmentierung | yolo26n-seg.pt | COCO |
| Semantisch | yolo26n-sem.pt | Cityscapes |
| Pose | yolo26n-pose.pt | COCO-Keypoints |
| OBB | yolo26n-obb.pt | DOTAv1 |
| Klassifizierung | yolo26n-cls.pt | ImageNet |
| Tiefe | yolo26n-depth.pt | Eine große Mischung aus Tiefendaten aus Innen- und Außenbereichen |
Das Backbone und der Neck werden unverändert übernommen; der Aufgaben-Head wird teilweise neu initialisiert, damit er zur Anzahl deiner Klassen passt. Training von Grund auf lohnt sich nur bei sehr großen Datensätzen aus äußerst ungewöhnlichen Anwendungsbereichen. Beginne mit dem Nano-Modell (n), um schnell eine Baseline zu erhalten, und wechsle erst zu größeren Modellen, wenn weitere Verbesserungen durch den Datenkreislauf ausbleiben. Der Leitfaden zur Feinabstimmung erklärt die internen Abläufe.
Baseline ausführen#
Trainiere mit den Standardeinstellungen; der erste Lauf soll eine Baseline liefern, keinen Rekord. Dabei wird auf der Aufteilung des Übungsdatensatzes aus Datensatz richtig aufteilen trainiert. Zuerst wird die YAML-Datei mit den Daten erstellt:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # # Der Übungsdatensatz behält die Klassennamen von COCO bei
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # # Auf COCO vortrainiert; verwende den Checkpoint für deine Aufgabe
model.train(data="practice.yaml", epochs=3, imgsz=320)  # # Ein echter Lauf: epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486Im Laufordner (runs/detect/train/) liegt jetzt weights/best.pt. Beim ersten Lauf sind nur drei Argumente einen Blick wert:
| Argument | Standard | Wann ändern? |
|---|---|---|
epochs | 100 | Weniger bei winzigen Datensätzen; 200–300 bei sehr großen Datensätzen |
imgsz | 640 | 1024 oder 1280, wenn viele Objekte im Bild klein sind |
batch | 16 | -1 für automatische Batch-Größe; bei Speichermangel verringern |
Dein erstes Modell trainieren erläutert den Trainingsaufruf und das Live-Protokoll ausführlich.
Klassen ordnen und übersehene Objekte untersuchen#
Der Gesamt-mAP verschleiert, wo das Problem liegt. Ordne die Klassen nach AP50-95 und verwende die Konfusionsmatrix, um die Fehler jeder Klasse in Objekte aufzuteilen, die das Modell vollständig übersehen hat, und Objekte, die es einer anderen Klasse zugeordnet hat:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classJede Fehlerart weist auf eine andere Korrektur am Datensatz hin:
- Zu wenige Instanzen in der Validierungsmenge (
fork,handbag,sink, jeweils 1): Der AP-Wert ist Zufall. Ziehe bei einer Klasse erst dann Schlüsse, wenn die Validierungsmenge mindestens einige Dutzend Instanzen enthält; sammle zuerst weitere Validierungsgruppen. - Übersehen (
car4 von 4,cup10 von 14): Das Modell erkennt überhaupt kein Objekt. Prüfe, ob dieses Szenario in den Trainingsdaten ausreichend abgedeckt ist, und suche mitsuspect_labels.pynach fehlenden Annotationen. - Andere Klasse vorhergesagt (
cup4 von 14): Die Klassendefinitionen überschneiden sich. Öffne die betreffenden Bilder, präzisiere die Definitionen und nenne das ähnliche Objekt im Leitfaden.
cup ist hier der konkrete Befund: 14 annotierte Instanzen, aber keine einzige erkannt.
Den Laufordner als Datenrückmeldung lesen#

Bei jedem Trainingslauf werden diese Dateien erstellt. Während des Cloud-Trainings stellt die Ultralytics Platform dieselben Kurven live dar:
| Datei | Was sie über die Daten aussagt |
|---|---|
confusion_matrix_normalized.png | Welche Klassen miteinander verwechselt oder fälschlich als Hintergrund eingestuft werden |
BoxPR_curve.png | Präzision und Trefferquote je Klasse; eine niedrige Kurve kennzeichnet eine schwache Klasse |
val_batch0_pred.jpg | Vorhersagen auf echten Validierungsbildern; achte auf systematisch übersehene Objekte |
labels.jpg | Klassenhäufigkeiten und Boxgrößen, mit denen das Modell trainiert wurde |
results.png | Verlust- und Metrikkurven; steigt der Validierungsverlust, während der Trainingsverlust sinkt, deutet das auf Überanpassung hin |
Validieren und diagnostizieren erklärt jedes Diagramm. Hier lautet die entscheidende Frage immer, welche Informationen in den Daten fehlen.
Der datenzentrierte Kreislauf#
Ein typischer Durchlauf: Wähle die schwächste Klasse mit ausreichend Instanzen in der Validierungsmenge aus, prüfe etwa 50 Bilder, die diese Klasse enthalten, korrigiere die Daten, trainiere mit denselben Einstellungen und derselben Aufteilung erneut und vergleiche den AP je Klasse. Gehe dann zur nächstschwächsten Klasse über.
Wenn du beim erneuten Training 300 Bilder hinzufügst und zugleich imgsz erhöhst, kannst du nicht erkennen, welche Änderung den Wert beeinflusst hat. Lass Einstellungen und Aufteilung gleich, während du die Daten schrittweise verbesserst, damit jeder Vergleich genau eine Datenänderung abbildet.
Wann Hyperparameter angepasst werden sollten#
Nach zwei oder drei Dateniterationen kann die Feinabstimmung noch die letzten Prozentpunkte bringen, sofern sich die verbleibenden schwachen Klassen nicht mehr auf fehlende Abdeckung, Annotationen oder Definitionen zurückführen lassen. Der Leitfaden zur Feinabstimmung behandelt das Einfrieren von Schichten, Lernraten und die Wahl des Optimierers. Wenn du jedoch abstimmst, bevor die Daten in Ordnung sind, verbringst du Wochen damit, ein Modell für den falschen Datensatz zu optimieren.
Sobald ein Modell acceptance_test.py auf dem unveränderten Testdatensatz besteht, behandelt Ultralytics YOLO in der Produktion den Export und die Bereitstellung. Zustand und Genauigkeit überwachen und Schleife für erneutes Training automatisieren in Mit Ultralytics Platform entwickeln behandeln den Kreislauf für erneutes Training.
Lösung anzeigen
Aus dem Probelauf geht hervor, dass cup die Klasse ist, um die es geht: 14 in val gelabelt, 0 gefunden, 10 übersehen, 4 einer anderen Klasse zugeordnet. Ein Plan mit konkreten Mengen:
| Befund | Datensatzmaßnahme | Umfang |
|---|---|---|
| 10 von 14 Tassen übersehen | Prüfe die Abdeckung im Training: Zähle die Trainingsbilder mit Tassen nach Kameratag und sammle Tassen in den Gruppen, in denen keine vorkommen. | 40 neue Bilder mit Tassen, verteilt auf 4 Kameratage |
| 4 von 14 einer anderen Klasse zugeordnet | Öffne sie in val_batch0_pred.jpg und die Konfusionsmatrix; wenn sie als wine glass oder bowl eingestuft werden, nimm beide ähnlich aussehenden Objekte in die Definition von cup auf. | Etwa 30 Trainingsbilder nach der neuen Regel neu labeln |
| Klassen mit 1 Instanz | Warte erst einmal; füge Validierungsgruppen hinzu, in denen sie vorkommen. | Nächste Sammelrunde |
Trainiere dann mit epochs, imgsz und unveränderter Aufteilung erneut, führe rank_classes.py noch einmal aus und vergleiche den AP-Wert von cup davor und danach. Steigt er, waren die Daten der Engpass; bleibt er gleich, prüfe die nächsten 50 Bilder, bevor du einen Hyperparameter anfasst.