Den Datensatz korrekt aufteilen
Miss, wie stark zufällige Aufteilungen zu Datenlecks führen, teile mit einem Skript ganze Gruppen wie Clips, Kameras oder Tage auf, prüfe die Klassenabdeckung und sperre den Testsatz.
Eine nachlässige Aufteilung liefert eine Kennzahl, der du vertraust, die aber nicht stimmt. Wenn benachbarte Videobilder sowohl im Trainings- als auch im Validierungssatz landen, misst die mAP der Validierung auswendig gelernte Inhalte statt Generalisierungsfähigkeit; die Abweichung zeigt sich erst im Produktivbetrieb. Jede Modellkennzahl, die du angibst, hängt von dieser Aufteilung ab. Wähle sie daher bewusst und behalte sie bei.
Praxisnah
Drei Teilmengen, drei Aufgaben#
| Teilmenge | Typischer Anteil | Aufgabe |
|---|---|---|
| Training | 70% | Das Modell lernt daraus seine Gewichte |
| Validierung | 15% | Beste Epoche auswählen, Läufe vergleichen, Einstellungen abstimmen |
| Test | 15% | Eine abschließende Go-or-No-Go-Entscheidung anhand des Abnahmetests |
Die Ultralytics-Anleitungen empfehlen 70–80 % für das Training und jeweils 10–20 % für Validierung und Test: Schritte eines CV-Projekts empfehlen jeweils 10–15 %, und der Leitfaden zur Vorverarbeitung verwendet 70/20/10. Zähle die Anteile sowohl bei den Objekten als auch bei den Bildern, denn ein dicht belegtes Bild kann mehr Labels enthalten als zehn spärlich belegte Bilder. Die genaue Prozentverteilung ist viel weniger wichtig als die Verwendung der einzelnen Teilmengen.
Zufällige Aufteilungen führen bei korrelierten Daten zu Datenlecks#
Die Bilder 124 und 125 desselben Clips sind nahezu identisch. Wenn eines im Trainingssatz und das andere im Validierungssatz landet, wird das Modell anhand von Bildern bewertet, die es im Grunde schon gesehen hat. Miss das anhand des Übungssatzes aus Hochwertige, repräsentative Daten sammeln, dessen Dateinamen mit einem Gruppenschlüssel aus Kamera und Tag beginnen:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainJede Kombination aus Kamera und Tag im Validierungssatz kommt auch im Trainingssatz vor. Bei echten Aufnahmen bedeutet das, dass Validierungsbilder Beleuchtung, Hintergrund und oft sogar dieselben Objekte wie Trainingsbilder aufweisen. Dadurch sieht die mAP der Validierung hervorragend aus, die mAP im Produktivbetrieb jedoch nicht.
Die Einheit für die Aufteilung wählen#
Wähle die Gruppe, die der für den Einsatz erforderlichen Generalisierung entspricht:
Wenn du unsicher bist, teile nach der allgemeinsten Einheit auf, die du dir leisten kannst: So erhältst du die aussagekräftigste Kennzahl. Zufällige Aufteilungen nach einzelnen Bildern sind nur dann sicher, wenn jedes Bild eine unabhängige Aufnahme ist, etwa bei Produktfotos, die im Abstand von Wochen aufgenommen wurden.
Mit Code nach Gruppen aufteilen#
Dieses Skript ordnet ganze Gruppen Teilmengen zu, bis jede ihren Anteil von 70/15/15 erreicht hat, schreibt die Dateilisten in einem Format, das eine Daten-YAML-Datei akzeptiert, und gibt die Klassenabdeckung aus:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingSo liest du die Ergebnisse:
- Keine Gruppe überschreitet eine Aufteilungsgrenze – das ist durch die Konstruktion sichergestellt. Damit ist dieses Datenleck behoben.
- Die Validierung enthält 2 Gruppen und lässt 36 Klassen aus, daher kann ihre AP nicht gemessen werden. Bei 71 Klassen in 128 Bildern kann keine Startzahl das beheben; die wirkliche Lösung sind mehr Gruppen (mehr Kameras oder Tage), wie sie ein Produktionsdatensatz mit mehr als 1.500 Bildern pro Klasse bietet.
- Im Trainingssatz fehlen 5 Klassen, die nur in der Validierung oder im Test vorkommen. Das Modell kann sie mit dieser Aufteilung niemals lernen.
Die Entscheidungsregel lautet: Wenn eine Klasse in einer Teilmenge fehlt, füge ganze Gruppen hinzu oder verschiebe sie, sofern sie die Klasse enthalten – niemals einzelne Bilder, denn dadurch würde das Datenleck erneut entstehen. Verweise in der Daten-YAML-Datei mit den Schlüsseln train, val und test auf die drei Dateien .txt; Eine Daten-YAML-Datei schreiben behandelt den Rest der Datei.
Klassen über die Teilmengen hinweg ausgleichen#
Für Klassifizierungsaufgaben hält train_test_split(..., stratify=labels) von scikit-learn die Klassenanteile mit einem einzigen Argument in allen Teilmengen gleich. Bilder für die Objekterkennung enthalten mehrere Klassen gleichzeitig. Gleiche die Verteilung daher auf Gruppenebene aus: Vergleiche nach group_split.py die Anzahl der einzelnen Klassen in den Teilmengen und tausche ganze Gruppen aus, bis jede Klasse innerhalb von etwa ±20 % ihres erwarteten Anteils liegt.

Auf der Ultralytics Platform verteilt Aufteilungen neu verteilen Bilder zufällig neu, und Automatisch legt die empfohlene Aufteilung von 80/20 für Training und Validierung fest (Dokumentation zur Aufteilung). Dabei werden exakt doppelte Bilder entfernt, Gruppen sind dem Tool jedoch nicht bekannt. Verwende es daher für unabhängige Aufnahmen und lade bei Video- oder Mehrkameradaten nach Gruppen aufgeteilte Daten hoch.
Zwei Validierungssätze getrennt verfolgen#
Oft benötigst du zwei Validierungssätze: eine stabile, kuratierte Regressionssuite und einen realitätsnahen Satz für den Produktivbetrieb, der mit neu gesammelten Bildern regelmäßig aktualisiert wird. Die Daten-YAML-Datei akzeptiert eine Liste von Validierungsordnern, fasst sie aber zu einem einzigen Validierungssatz mit einer einzigen Kennzahl zusammen:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Um die einzelnen Kennzahlen zu sehen, verwende für jeden Validierungssatz eine eigene Daten-YAML-Datei (dieselben Schlüssel train und names, aber ein anderer Schlüssel val) und validiere die trainierten Gewichte mit jedem Satz:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Ein Rückgang beim kuratierten Satz ist eine Regression; ein Rückgang beim Satz für den Produktivbetrieb ist eine Verschiebung der Domäne.
Den Testsatz sperren#
Der teuerste Fehler bei der Aufteilung ist, zehn Modellvarianten anhand des Testsatzes zu vergleichen. Sobald der Testsatz eine Entscheidung beeinflusst hat, ist der Endwert zu optimistisch. Nimm alle Abstimmungen und Vergleiche anhand des Validierungssatzes vor und führe den Abnahmetest genau einmal am Ende auf dem Testsatz durch.
Jede veröffentlichte Kennzahl hängt von dieser Aufteilung ab. Eine spätere neue zufällige Aufteilung verändert alle Werte und macht alte und neue Modellläufe unvergleichbar. Bewahre zusammen mit dem Datensatz die Einheit der Aufteilung, den Seed und die drei Dateilisten auf.
K-fache Kreuzvalidierung für kleine Datensätze#
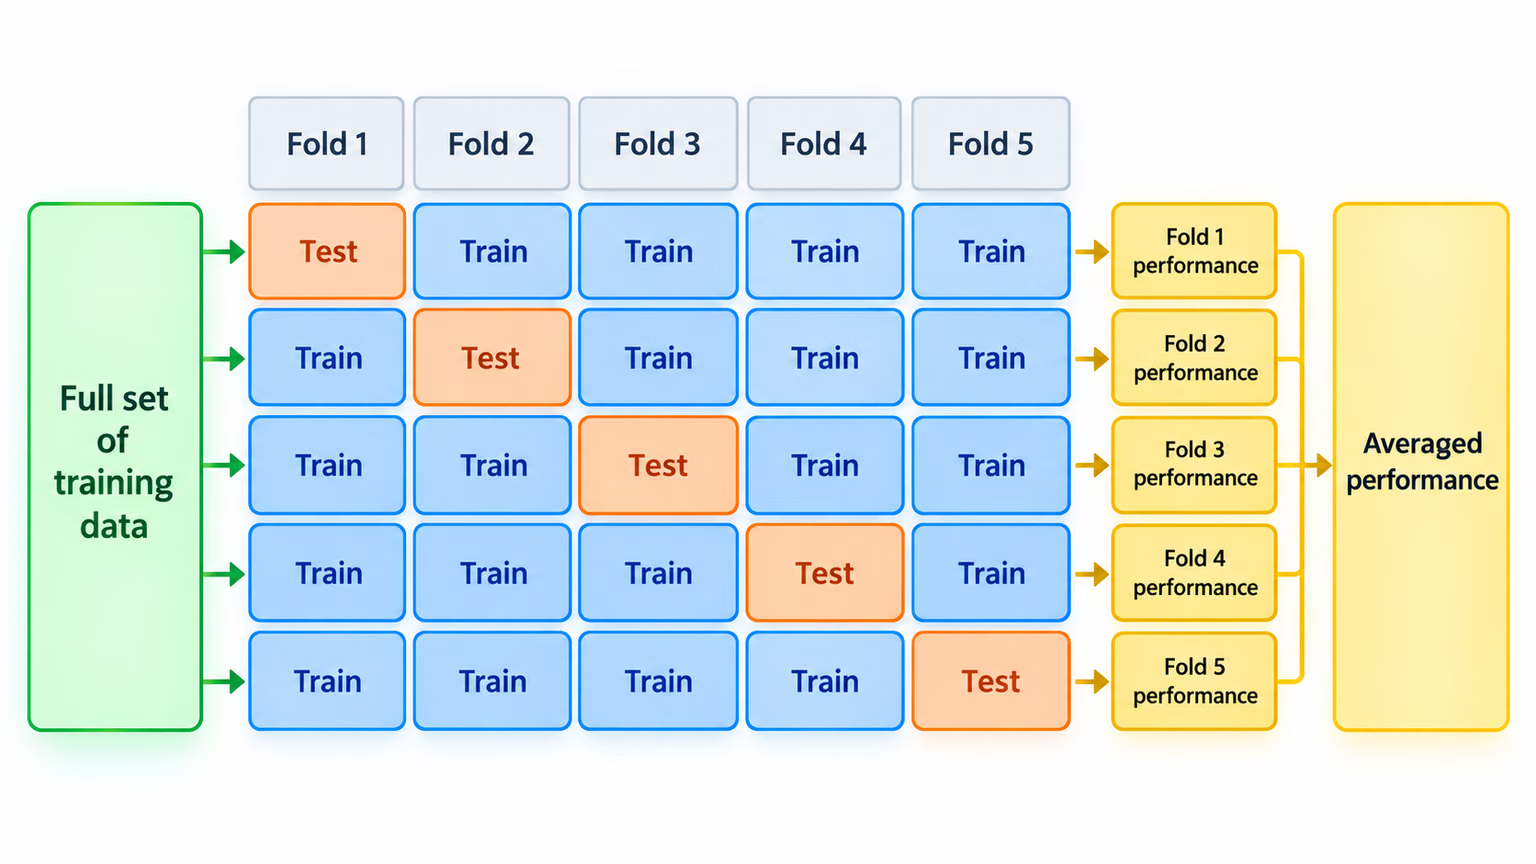
Wenn der Datensatz klein ist (weniger als etwa 500 Bilder pro Klasse) und eine einzelne Aufteilung statistisch wenig aussagekräftig erscheint, trainiert die K-fache Kreuzvalidierung k Modelle mit rotierenden Aufteilungen und mittelt die Ergebnisse: Das erfordert k-mal so viel Rechenleistung, liefert aber eine deutlich stabilere Schätzung. Erstelle die Folds auf dieselbe Weise aus Gruppen, sonst kommt es in jedem Fold zu Datenlecks.
Lösung anzeigen
Bei festen Lagerkameras, die auch an neuen Tagen zuverlässig funktionieren müssen, teile nach Kamera und Tag auf: cam2_2026-05-01. Prüfe nach group_split.py, dass keine Gruppe eine Aufteilungsgrenze überschreitet:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneDie Testaufteilung besteht die Prüfung auf Datenlecks, scheitert aber an der Abdeckungsprüfung: In der Validierung fehlen 36 von 71 Klassen. Die Lösung ist ein Plan zur Datenerfassung, keine neue Aufteilung. Erfasse mindestens zwei weitere Kamera-Tage für die Validierung und den Test, die jeweils die wichtigsten Klassen der Spezifikation abdecken, und führe beide Skripte erneut aus.