Beginne mit dem Geschäftsziel
Wandle ein Geschäftsziel in eine Computer-Vision-Aufgabe, festgelegte Klassen und einen Abnahmetest um, den du als Code ausführen kannst – bevor auch nur ein einziges Bild erfasst wird.
Ein Lagerteam fotografiert einen Monat lang alles und erfährt dann, dass die Sicherheitsleitung nur Personen in der Nähe fahrender Gabelstapler erfassen möchte. Die Hälfte der Beschriftungen muss deshalb erneuert werden. Eine einseitige Zielsetzung, auf die man sich vor dem ersten Foto einigt, verhindert das. Sie dauert einen Nachmittag und bestimmt alle späteren Entscheidungen in diesem Kurs: was erfasst und beschriftet wird und wann das Modell gut genug für den Einsatz ist.
Praxisnah
Die einseitige Zielsetzung#

Fünf Zeilen beantworten die Fragen, von denen alle späteren Schritte abhängen. Der Leitfaden zum Festlegen von Projektzielen behandelt dieselben Themen ausführlicher. Hier ist ein ausgefülltes Beispiel aus einem Lager, auf dem dieser Kurs aufbaut:
| Zeile | Beantwortete Frage | Beispiel aus dem Lager |
|---|---|---|
| Geschäftsziel | Was ändert sich für das Unternehmen, und bis wann? | Die Zahl der Beinaheunfälle an den Lagertoren innerhalb von sechs Monaten um 30 % senken. |
| Computer-Vision-Aufgabe | Was gibt das Modell aus? | Objekterkennung: Boxen um Gabelstapler und Personen. |
| Klassen | Was genau erhält eine Beschriftung? | forklift, person, pallet; alles andere ist Hintergrund. |
| Abnahmetest | Welcher Wert bedeutet „bereit für den Einsatz“? | Recall für person ≥ 0.95 bei einer Präzision ≥ 0.85 auf 500 Frames von Kameras, die nicht fürs Training verwendet wurden. |
| Nicht im Umfang | Was verspricht Version 1 nicht? | Stockdunkle Laderampen, vollständig hinter Regalen verborgene Personen, manuelle Hubwagen. |
Hänge die Seite dort auf, wo das ganze Team sie sehen kann. Wenn später jemand aus dem Kreis der Beteiligten eine Zeile infrage stellt, ändere zuerst die Seite und erst danach den Datensatz.
Wähle die einfachste Aufgabe, die die Frage beantwortet#
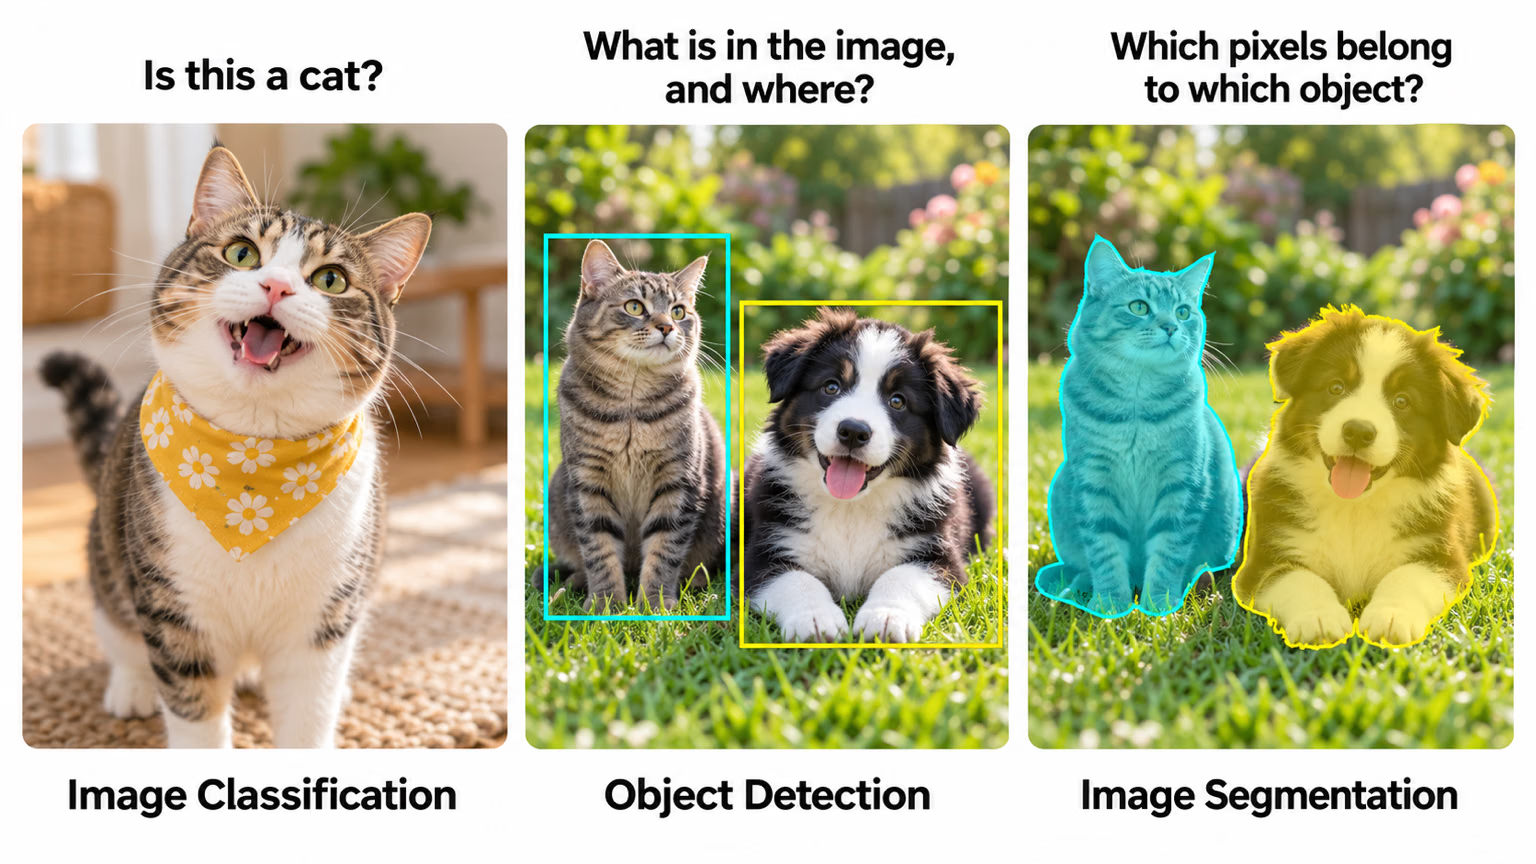
Die Aufgabe bestimmt, was Annotatoren einzeichnen müssen, und davon hängt der Großteil des Beschriftungsaufwands ab. Gehe diesen Entscheidungsbaum durch und höre bei der ersten Aufgabe auf, die die Geschäftsfrage beantwortet:
Ultralytics YOLO unterstützt sieben Aufgaben. Bei der Planung des Datensatzes kommt es darauf an, wie viel Aufwand die Beschriftung jeder Aufgabe erfordert; Grundlagen der Computer Vision vergleicht sie ausführlich in der Lektion zu Computer-Vision-Aufgaben.
| Aufgabe | Was Annotatoren erstellen | Beschriftungsaufwand | Wähle diese Aufgabe, wenn … |
|---|---|---|---|
| Klassifizierung | Eine Beschriftung pro Bild | Am geringsten | Eine Antwort pro Bild ausreicht |
| Objekterkennung | Klasse + achsenparallele Box pro Objekt | Gering | Du Objekte zählen oder lokalisieren musst |
| OBB | Klasse + gedrehte Box pro Objekt | Mittel | Objekte lang und schmal sind oder von oben aufgenommen werden |
| Pose | Klasse + benannte Keypoints pro Objekt | Hoch | Positionen von Gelenken oder Teilen sind wichtig |
| Instanzsegmentierung | Klasse + Polygon pro Objekt | Hoch | Die Umrisse jedes Objekts sind wichtig |
| Semantische Segmentierung | Eine Klasse für jedes Pixel | Am höchsten | Du brauchst Bereiche, keine zählbaren Objekte |
| Tiefenschätzung | Nichts eingezeichnet: eine Tiefenkarte pro Bild, normalerweise von einem Tiefensensor | Hängt von der Aufnahmehardware ab | Du brauchst die Entfernung für jedes Pixel |
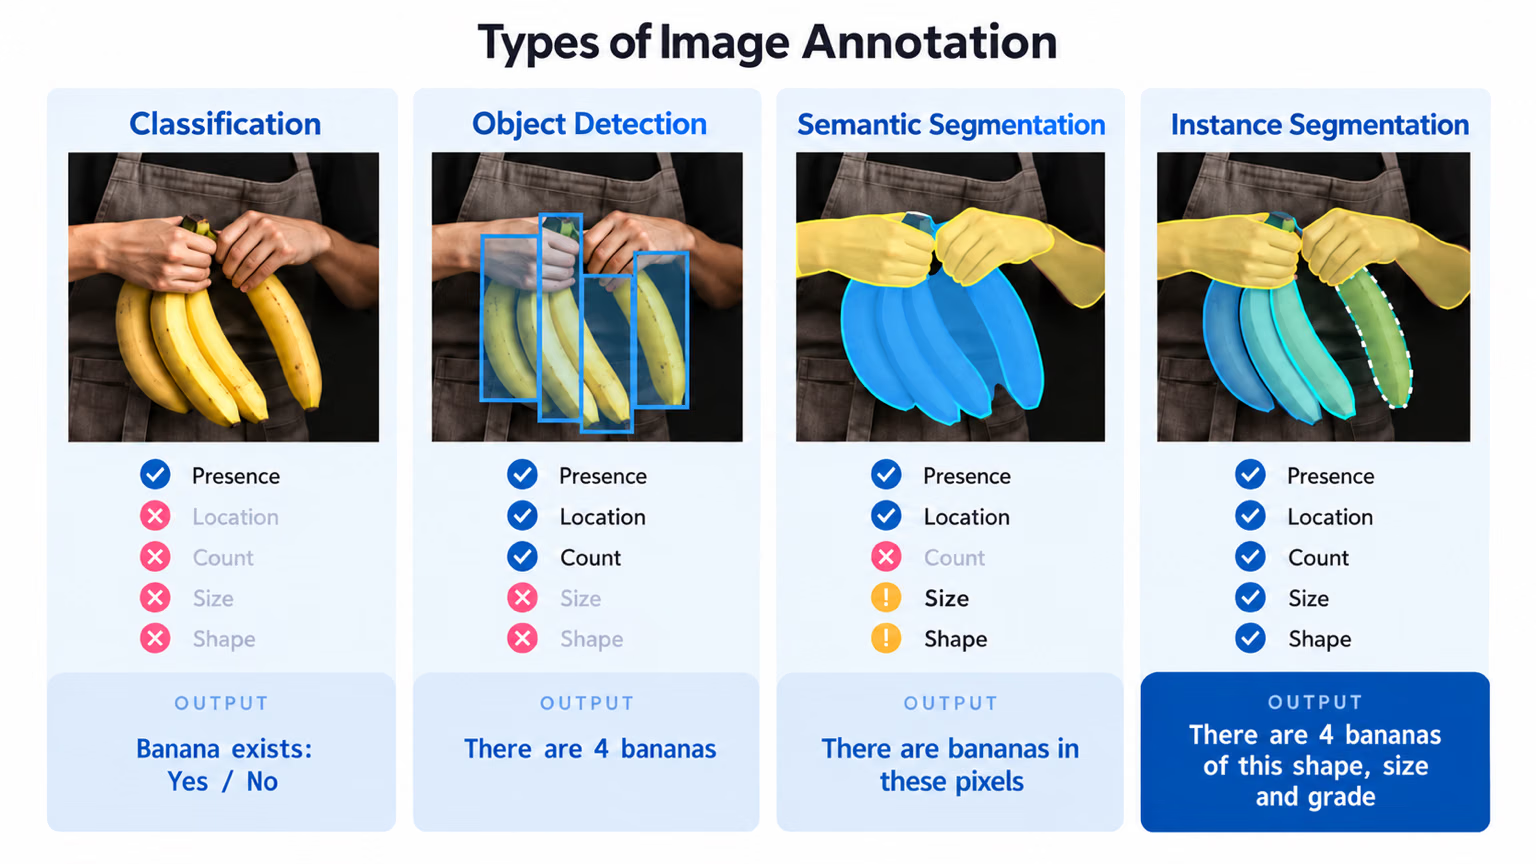
Lies die Bananenübersicht wie eine Preisliste: Die Objekterkennung liefert bereits Vorhandensein, Position und Anzahl; nur die beiden Segmentierungsfelder ergänzen Größe und Form – bei deutlich höheren Annotationskosten. Wenn das Unternehmen nur wissen muss, „wie viele Bananen“ es gibt, ist die Objekterkennung die richtige Wahl, und Polygone sind verschwendetes Budget.
Teams greifen oft zur Segmentierung, weil sie präziser wirkt, und haben dann ihr Kennzeichnungsbudget aufgebraucht, bevor der Datensatz Nachtschichten, Regen oder den zweiten Standort abdeckt. Polygone kosten pro Objekt ein Mehrfaches von Boxen. Entscheide dich nur dann für Segmentierung, wenn ein Ziel ausdrücklich die Umrisslinie erfordert, etwa zum Flächenmessen oder Ausschneiden einer Maske.
Formuliere Klassen, die Annotatoren zuordnen können#
Eine Klasse ist nur dann nützlich, wenn zwei Annotatoren dasselbe Objekt gleich kennzeichnen. Schreibe für jede Klasse eine Definition in einem Satz, die ein ähnlich aussehendes Objekt nennt, das sie ausschließt:
forklift: ein motorisierter Gabelstapler einschließlich Gabeln und Hubmast. Handhubwagen sind ausgeschlossen.person: jeder Mensch, auch wenn er teilweise sichtbar oder sitzend ist oder sich in einer Fahrzeugkabine befindet. Spiegelungen und Poster sind ausgeschlossen.pallet: eine hölzerne oder Kunststoffpalette für den Versand, beladen oder leer. Gestapelte Kisten ohne Palettenunterbau sind ausgeschlossen.
Wähle anschließend bewusst den Detaillierungsgrad. Grobe Klassen („Fahrzeug“) sind günstiger und lassen sich schneller vereinheitlichen; feinere Klassen („Limousine“, „Pick-up“) sind für nachgelagerte Anwendungen nützlicher, aber schwerer konsistent zu halten. Beginne mit dem, was das Unternehmen braucht. Feine Kennzeichnungen lassen sich später mit einer Codezeile zu groben Klassen zusammenfassen; grobe Kennzeichnungen lassen sich jedoch nur durch erneute Annotation aufteilen.
„Alles, was gefährlich aussieht“ oder „Zeug, das den Gang blockiert“ ist keine Klasse. Damit muss jede annotierende Person selbst urteilen, und ein Modell, das anhand uneinheitlicher Urteile trainiert wurde, lernt diese Uneinheitlichkeit. Formuliere eine vage Klasse so lange um, bis eine neue annotierende Person sie allein anhand der Definition anwenden kann, oder mache daraus eine Regel, die nach der Erkennung angewendet wird (zum Beispiel „jedes pallet innerhalb des Gangpolygons“).
Mach aus der Metrik einen ausführbaren Abnahmetest#
Wähle die Metrik passend zu den Kosten eines Fehlers:
- Ein übersehenes Objekt ist teuer (Sicherheit, Defekte): Lege für diese Klasse eine Recall-Schwelle fest.
- Ein Fehlalarm ist teuer (automatisches Aussortieren von Teilen, Alarmierung von Mitarbeitenden): Lege eine Precision-Schwelle fest.
- Jede Klasse ist gleich wichtig (Zählung, Lagerbestand): Lege eine Schwelle für die AP pro Klasse fest, damit keine Klasse hinter dem Durchschnitt verschwindet.
Der Leitfaden zu YOLO-Leistungsmetriken erklärt jede davon. Schreibe den Test anschließend als Code, damit „Ist das gut genug?“ nicht mehr zur Diskussion steht. Dieses Skript läuft heute mit einem vortrainierten Modell auf dem Demosatz COCO8 und später mit deinem eigenen Checkpoint und Holdout:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # later: your fine-tuned runs/detect/train/weights/best.pt
metrics = model.val(data="coco8.yaml", classes=[0], verbose=False)  # 0 = person; later: your holdout YAML

precision, recall = metrics.box.mp, metrics.box.mr
print(f"person: precision={precision:.2f} recall={recall:.2f}")
print("PASS" if recall >= 0.95 and precision >= 0.85 else "FAIL: below the acceptance test")
all 4 10 0.939 0.8 0.848 0.387
person: precision=0.94 recall=0.80
FAIL: below the acceptance testWas dir die einzelnen Zeilen sagen:
classes=[0]bewertet nurperson, sodass andere Klassen das Ergebnis nicht aufbessern können. Verwende die ID deiner eigenen Sicherheitsklasse.- Die Zeile des Validators zeigt 4 Bilder mit 10 gekennzeichneten Personen.
mpundmrsind Precision und Recall an der Konfidenzschwelle, bei der beide am besten ausgeglichen sind (maximaler F1-Wert). - Ein vortrainiertes COCO-Modell erkennt 8 der 10 Personen, der Recall beträgt also 0.80: präzise, aber nicht sicher genug. Dass der Test FEHLGESCHLAGEN ist, zeigt, dass er funktioniert. In diesem Kurs führt ein FEHLGESCHLAGEN zurück zu den Daten, nicht zu den Hyperparametern.
Ein Testsatz aus denselben Kameras und Tagen wie der Trainingssatz misst das Erinnerungsvermögen, nicht die Einsatzbereitschaft. Benenne den Testsatz im Ziel („Kameras, die nicht fürs Training verwendet wurden“, „die letzten zwei Wochen an Aufnahmen“) und erstelle ihn mit Datensatz korrekt aufteilen.
Halte fest, was Version 1 nicht leisten wird#
Kein Modell ist perfekt. Benenne daher vorab die akzeptablen Fehler: Bedingungen, für die du keine Leistung versprichst (dichter Nebel, völlige Dunkelheit), ähnlich aussehende Objekte, die das Modell verwechseln darf, und seltene Klassen, die auf Version 2 verschoben werden. Diese Zeile verhindert, dass ein Modell, das sein Ziel erreicht, an einer nicht festgehaltenen 100-%-Vorgabe gemessen wird. Außerdem zeigt sie dem Datenerfassungsteam, wo sich zusätzlicher Aufwand vorerst nicht lohnt.
Lösung anzeigen
Ein ausgearbeitetes Ziel für ein anderes Projekt: eine Lebensmittelkette erkennt leere Regalplätze.
| Zeile | Antwort |
|---|---|
| Geschäftsziel | Die Ausverkaufsdauer bei den 200 umsatzstärksten Produkten innerhalb eines Quartals um 25 % senken. |
| Computer-Vision-Aufgabe | Objekterkennung. Der Markt braucht die Position jeder Lücke, nicht ihren Umriss. Daher sind Begrenzungsrahmen besser als Polygone. |
| Klassen | gap: ein leerer Regalplatz, der mindestens so breit wie ein Produkt ist; Plätze, die von Kundschaft oder Einkaufswagen verdeckt werden, sind ausgeschlossen. price_tag: ein Regalkantenetikett; Werbeaufkleber sind ausgeschlossen. |
| Abnahmetest | Recall für gap ≥ 0.90 bei einer Precision ≥ 0.80 auf 400 Bildern aus 5 Filialen, die nicht für das Training verwendet wurden. |
| Nicht im Umfang | Glastüren von Tiefkühlgeräten mit Spiegelungen, Stirnregale und die Obst- und Gemüseabteilung. |
Recall hat Vorrang, weil eine übersehene Lücke einen Verkauf kostet, während ein Fehlalarm für eine mitarbeitende Person nur einen kurzen Weg bedeutet. acceptance_test.py ändert sich an genau drei Stellen: data="holdout_stores.yaml" (die fünf unbekannten Filialen), classes=[0] (0 ist jetzt gap) und den Schwellenwerten recall >= 0.90 and precision >= 0.80.