Augmentierung mit Bedacht einsetzen
Teste jede Augmentierung mit der Einsatzkamera, erstelle ein begründetes Profil, trainiere damit und prüfe das Ergebnis in den Trainingschargen.
Stell dir eine Sortieranlage vor, die rote Kapseln von orangefarbenen trennt und mit der standardmäßigen Farbtonvariation trainiert wird. In jeder Epoche sieht das Modell rote Kapseln, die orange eingefärbt sind. So lernt es, dass die Farbe keine Rolle spielt – obwohl genau das entscheidend war. Augmentierung macht ein Modell nur dann robuster, wenn jede Transformation tatsächlich von der Einsatzkamera erzeugt werden könnte. In dieser Lektion erfährst du, wie du entscheidest, welche Transformationen du beibehältst.
Praxisnah
Was Augmentierung bewirkt#
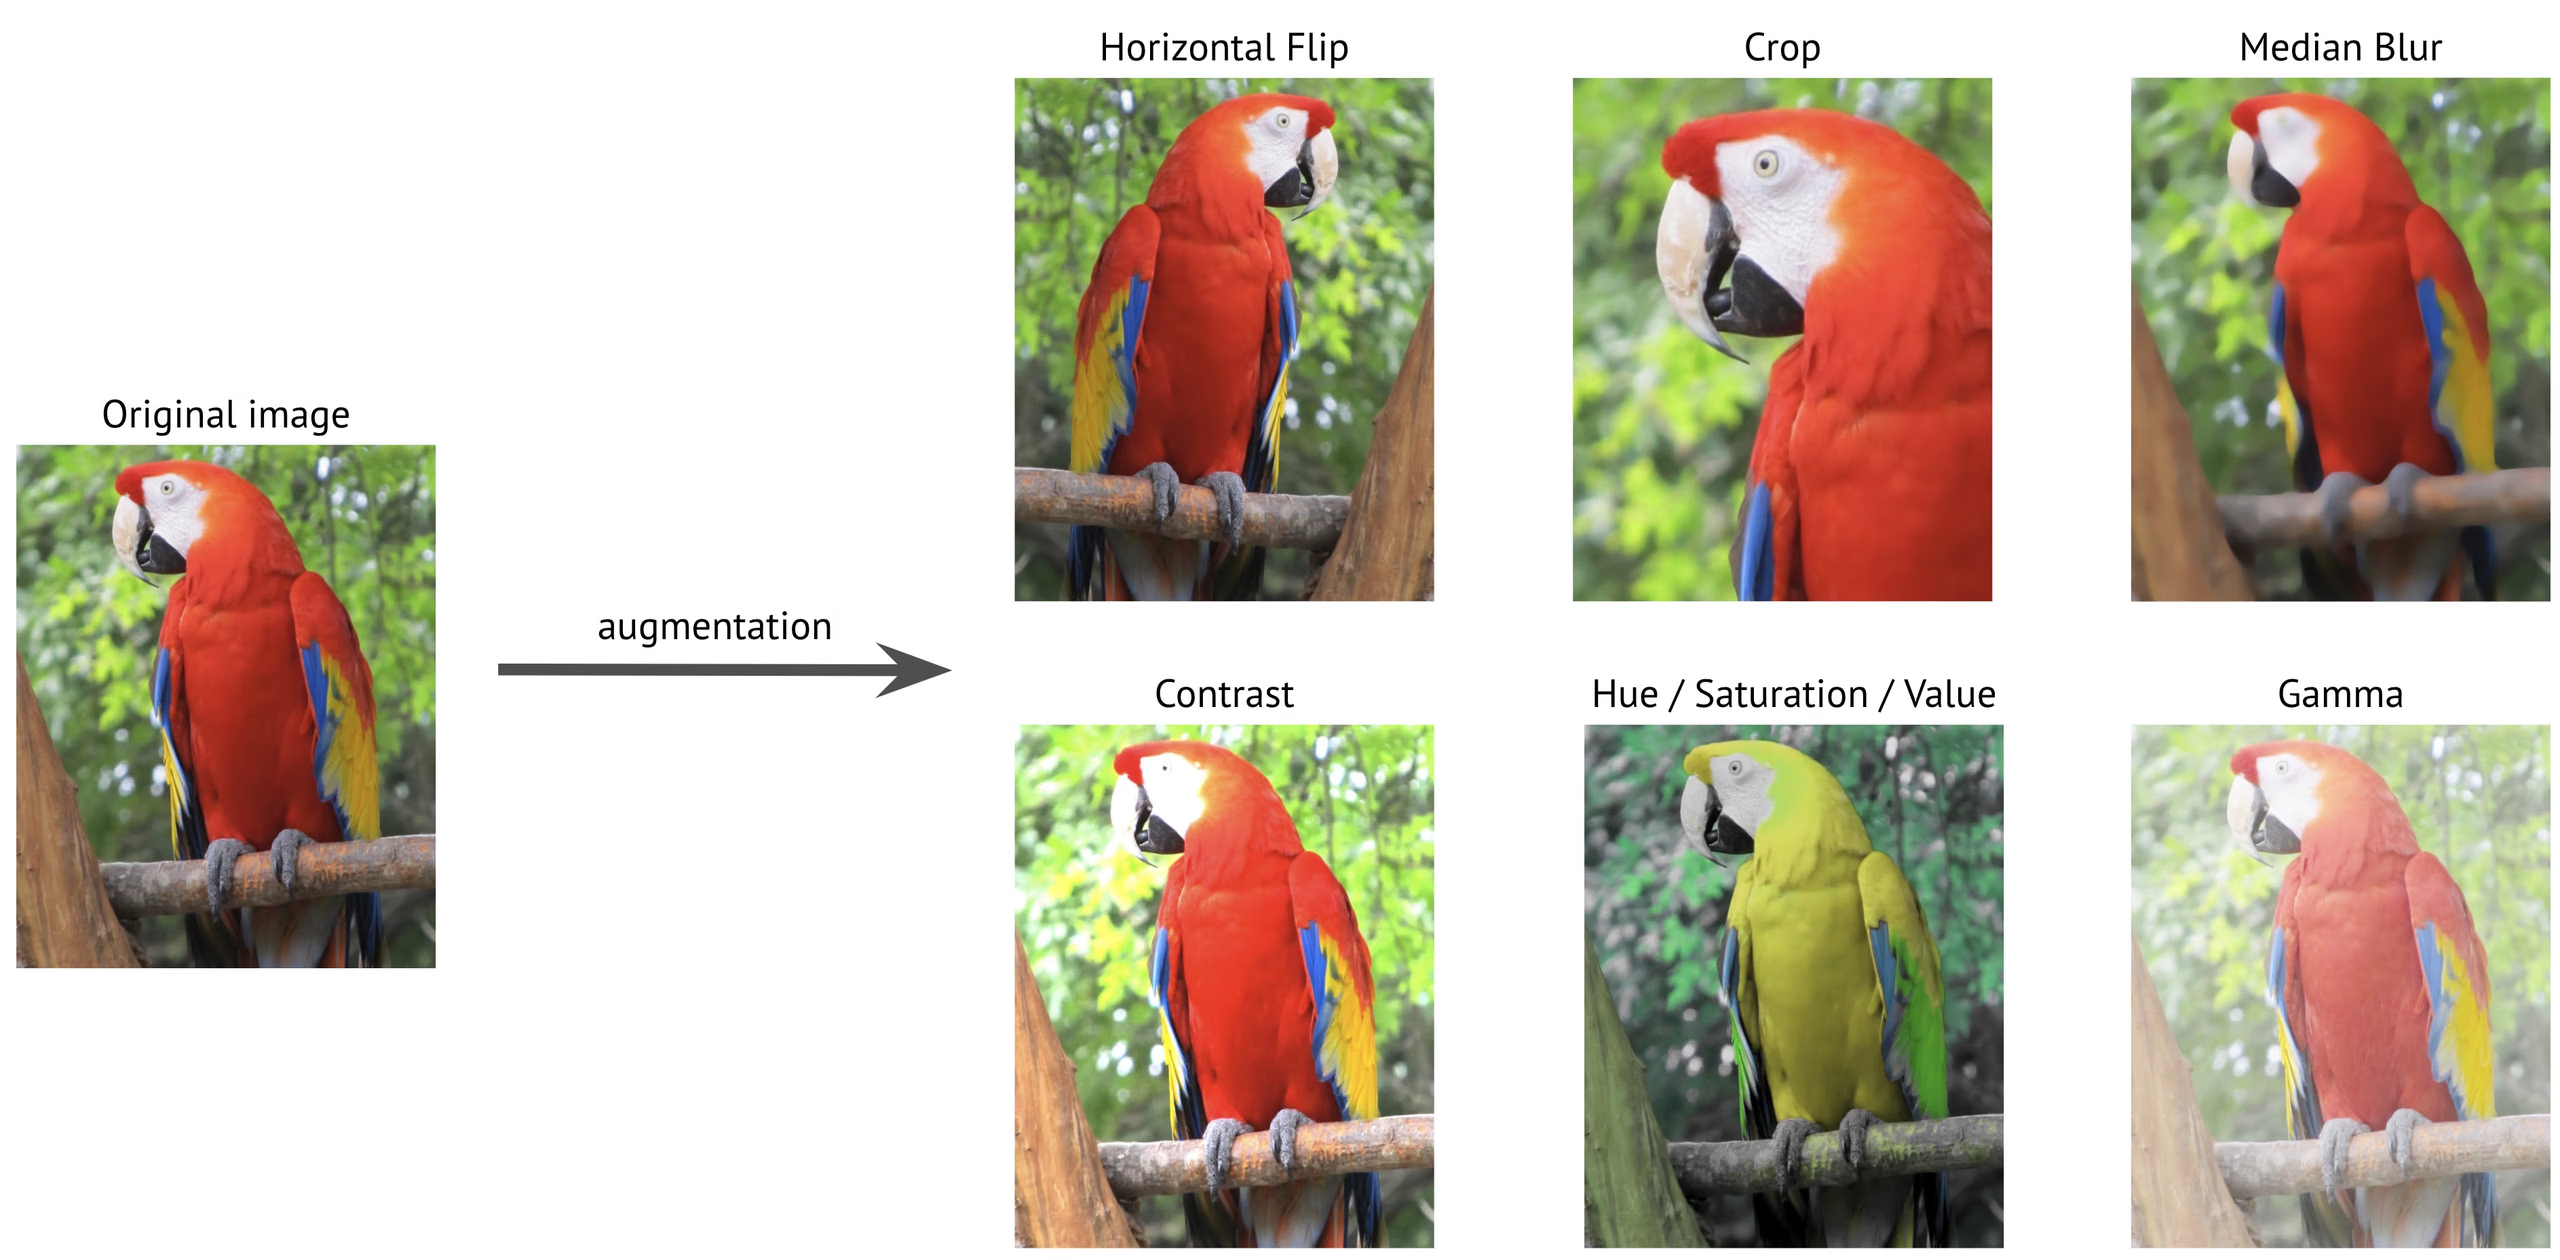
Datenaugmentierung verändert Trainingsbilder während des Trainings, sodass das Modell in jeder Epoche eine leicht veränderte Version jedes Bildes sieht. Richtig eingesetzt verbessert sie die Robustheit gegenüber Beleuchtung, Maßstab und Ausrichtung und verringert Overfitting, weil das Modell sich verändernde Bilder nicht auswendig lernen kann. Falsch eingesetzt vermittelt sie physikalisch unmögliche Szenen und verdeckt Lücken im Datensatz, die du eigentlich beheben solltest.
Sieh dir oben das Farbtonfeld an: Der rote Ara wird gelb. Für die Unterscheidung „Ara oder kein Ara“ ist das unproblematisch, aber schädlich, wenn die Farbe zwei deiner Klassen voneinander unterscheidet.
Wichtige Standardeinstellungen#
Dies sind die Standardeinstellungen in Ultralytics 8.4; die Referenz zu den Augmentierungseinstellungen führt alle Argumente auf:
| Argument | Standard | Funktion | Ändern, wenn |
|---|---|---|---|
hsv_h | 0.015 | Farbtonvariation | Auf 0 setzen, wenn die Farbe eine Klasse definiert |
hsv_s / hsv_v | 0.7 / 0.4 | Variation von Sättigung und Helligkeit | Verringern, wenn die Beleuchtung fest und kontrolliert ist |
degrees | 0.0 | Zufällige Drehung (± Grad) | Erhöhen, wenn Objekte in beliebigen Winkeln auftreten |
translate / scale | 0.1 / 0.5 | Verschiebung und Zoom | Verringern, wenn durch Zuschnitte klassenbestimmende Teile abgeschnitten werden können |
fliplr | 0.5 | Wahrscheinlichkeit für horizontales Spiegeln | Auf 0 setzen, wenn links und rechts eine Rolle spielen, etwa bei Text |
flipud | 0.0 | Wahrscheinlichkeit für vertikales Spiegeln | Für Aufnahmen von oben, Luftbilder oder Mikroskopbilder erhöhen |
mosaic | 1.0 | Setzt vier Bilder zu einem zusammen | Nur selten; siehe close_mosaic |
close_mosaic | 10 | Deaktiviert Mosaic in den letzten N Epochen | Bei sehr kurzen Läufen verringern |
mixup / cutmix | 0.0 / 0.0 | Mischt zwei Bilder oder fügt einen Ausschnitt des einen in das andere ein | Nach einer Ausgangsmessung bei kleinen Datensätzen ausprobieren |
copy_paste | 0.0 | Fügt Objektinstanzen aus anderen Bildern ein | Segmentierungsdatensätze, semantische Segmentierungsdatensätze und OBB-Datensätze mit seltenen Klassen |
Tiefendatensätze sind die Ausnahme: mosaic, mixup, cutmix und copy_paste würden ungültige zugeordnete Tiefenkarten erzeugen; daher setzt der Tiefen-Loader sie automatisch auf 0.
Der Einsatztest#
Jede aktivierte Transformation muss zuerst eine Frage und dann eine zweite bestehen:
| Transformation | Realistisch? | Ergebnis |
|---|---|---|
| Helligkeit ±30 % bei einer Außenkamera | Ja: Tageszeit | Beibehalten |
| Horizontales Spiegeln bei einer Überwachungskamera | Ja: Personen gehen in beide Richtungen | Beibehalten |
| Vertikales Spiegeln bei einer wandmontierten Kamera | Nein: Der Boden bleibt unten | Deaktivieren |
| Vertikale Spiegelung bei einer nach unten gerichteten Förderbandkamera | Ja: Im Bild gibt es kein „oben“ | Aktivieren |
| Drehung um 90° bei einer fest installierten Straßenkamera | Nein: Die Kamera dreht sich nie | Deaktivieren |
| Farbtonverschiebung, wenn sich rote und grüne Teile in ihrer Klasse unterscheiden | Nein: Zerstört das Signal | Deaktivieren |
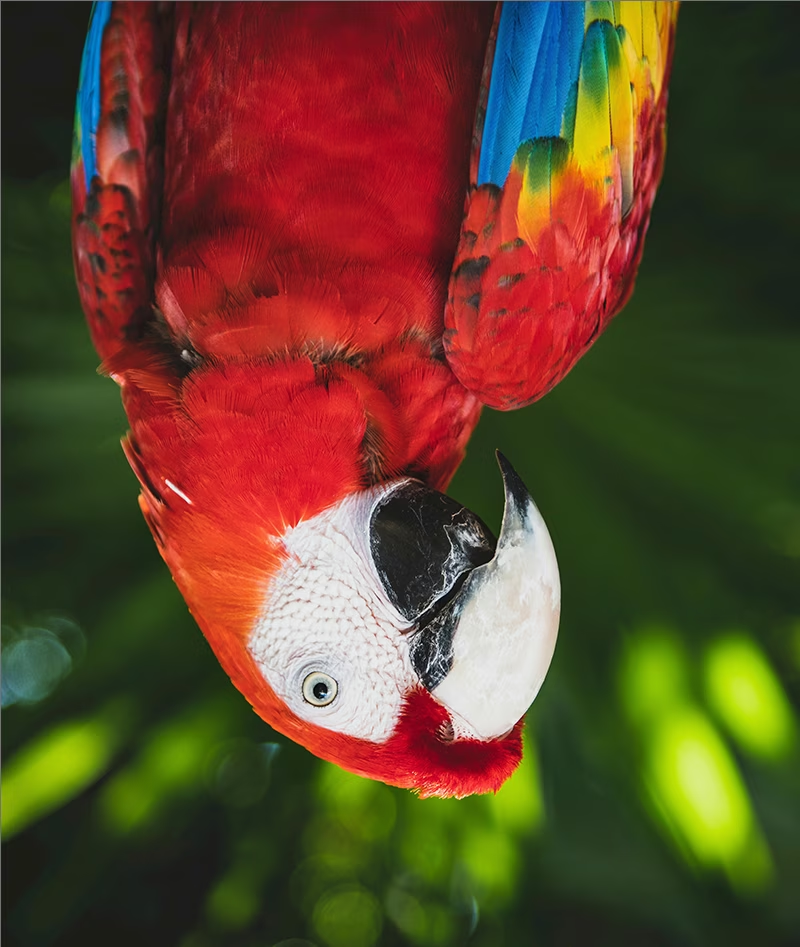
Ein kopfüber fliegender Ara ist ein gutes Trainingsbild für eine Drohne, die gerade nach unten schaut, und ein verschwendetes Bild für eine an der Wand montierte Kamera. Transformationen, die diesen Test nicht bestehen, erzeugen ein negatives Trainingssignal: Das Modell lernt, Bilder zu erkennen, die es niemals sehen wird, und hat dadurch weniger Kapazität für Bilder, die es tatsächlich sehen wird.
Ein ausgearbeitetes Profil#
Eine nach unten gerichtete Kamera über einem Förderband sortiert Teile, deren Klassen sich nur durch die Farbe unterscheiden. Farbtonschwankungen müssen wegfallen, während vertikale Spiegelungen und kleine Drehungen realistisch werden. Dies läuft wie gezeigt auf dem COCO8-Demosatz; ersetze die YAML-Datei durch die deiner Daten und gib eine realistische Anzahl an Epochen an:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(
    data="coco8.yaml",
    epochs=1,
    imgsz=320,
    hsv_h=0.0,  # Farbe ist das Klassensignal: Farbtöne unverfälscht lassen
    flipud=0.5,  # Draufsicht: Im Bild gibt es kein „oben“
    degrees=10.0,  # Teile liegen in jedem beliebigen kleinen Winkel
)
Öffne train_batch0.jpg im Ausführungsordner und überprüfe drei Dinge: Die Boxen bleiben nach der Transformation eng an den Objekten, klassendefinierende Merkmale (Farbe, Form, Text) bleiben erhalten und nichts wirkt physikalisch unmöglich. Reduziere jede Transformation, die eines dieser Kriterien verletzt. Train Your First Model behandelt den Trainingslauf selbst.
Mosaic und close_mosaic#
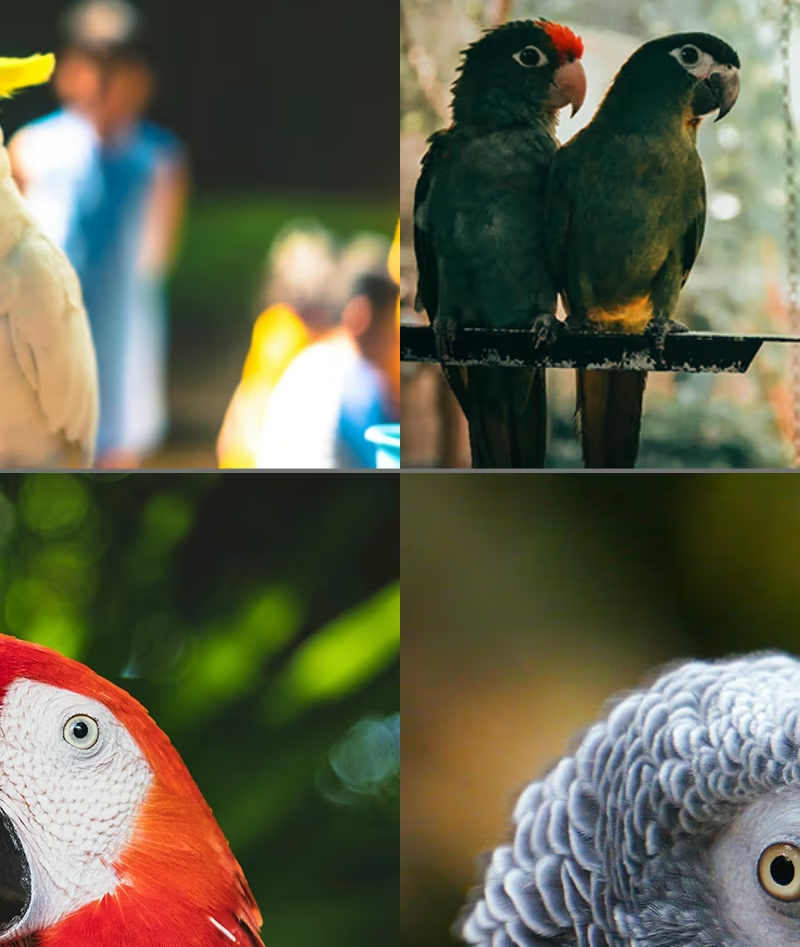
Mosaic fügt vier Bilder zu einem zusammen und ist standardmäßig aktiviert. Es ist die wirkungsvollste Datenaugmentation für die Objekterkennung: Jedes Trainingsbild enthält mehrere Szenen, Größen und Objektkontexte. Der Nachteil: Mosaic-Bilder sehen nicht wie Bilder im Einsatz aus. Deshalb deaktiviert close_mosaic=10 Mosaic während der letzten 10 Epochen, damit das Modell mit realistischen Eingaben fertig trainiert wird. Wenn Mosaic beendet wird, werden auch mixup, cutmix und copy_paste deaktiviert; Spiegelungen, HSV und geometrische Transformationen laufen weiter.
Bei Trainingsläufen mit höchstens close_mosaic Epochen ist Mosaic bereits ab der ersten Epoche deaktiviert, auch beim oben gezeigten Profil mit einer Epoche. Beurteile Mosaic anhand von train_batch0.jpg eines vollständigen Trainingslaufs, nicht anhand eines kurzen Tests.
Was Datenaugmentation nicht beheben kann#
Datenaugmentation verstärkt, was bereits vorhanden ist. Wenn der Datensatz keine Nachtbilder enthält, kann keine Einstellung Nacht erzeugen: Sie erzeugt lediglich hellere und dunklere Varianten von Tagesbildern. Wenn eine Klasse nur mit starker Datenaugmentation funktioniert, gibt es zu wenige Beispiele dieser Klasse. Kehre zu Collect High-Quality, Representative Data zurück.
Bei einem kleinen Datensatz führt jede Augmentierung auf Maximum dazu, dass immer weiter vom Einsatz entfernte Bilder zum Training verwendet werden, und der mAP auf der Validierung sinkt oft. Ändere jeweils nur ein Argument und nur mit gutem Grund und vergleiche es mit der Standardkonfiguration auf derselben Aufteilung.
Wird eine Klasse durch einen kleinen Teil des Objekts definiert, etwa das Ecksymbol einer Spielkarte, können mosaic, translate und scale diesen Teil abschneiden und so ein Trainingsbild erzeugen, das genau wie eine andere Klasse aussieht. Setze diese Werte für den Datensatz herab und bestätige die Korrektur in train_batch0.jpg.
Lösung anzeigen
Eine Drohne überfliegt einen Hafen direkt von oben und erkennt Schiffe mit orientierten Boxen. Aus dieser Perspektive gibt es kein „oben“, Schiffe zeigen in alle Richtungen und die Farbe bestimmt nicht die Klasse:
| Argument | Auswahl | Begründung |
|---|---|---|
flipud | 0.5 | Eine Ansicht von oben sieht nach einer vertikalen Spiegelung unverändert aus |
degrees | 180 | Schiffe erscheinen in jeder Ausrichtung |
hsv_h | Standardwert | Die Rumpffarbe variiert und ist kein Klassenmerkmal |
mosaic | Standardwert | Viele kleine Objekte pro Bild; Mosaic hilft |
Auf dem Luftbild-Demosatz DOTA8:
yolo obb train data=dota8.yaml model=yolo26n-obb.pt epochs=1 imgsz=320 flipud=0.5 degrees=180Bei einer fest installierten Straßenkamera würden dieselben beiden Änderungen den Einsatztest nicht bestehen: Autos stehen in einer an der Wand montierten Kameraaufnahme niemals auf dem Kopf.