Erkennen, wann der Datensatz bereit ist
Mache den ersten Trainingslauf von acht bestandenen oder nicht bestandenen Prüfungen abhängig, automatisiere die drei Prüfungen, die sich per Skript verifizieren lassen, und finde heraus, welche Korrektur bei jedem Fehlschlag nötig ist.
Bei jedem Projekt kommt der Moment, in dem das Team trainieren möchte. Manchmal ist der Datensatz bereit; manchmal enthält er noch eine undichte Aufteilung oder eine unterbeschriftete Klasse, was eine Woche GPU-Zeit verschwendet und einen Wert liefert, dem niemand vertrauen sollte. Acht Prüfungen, die jeweils mit Ja, Nein oder einer dokumentierten Ausnahme bewertet werden, machen diese Entscheidung objektiv statt von der Stimmung abhängig.
Praxisnah
Die acht Prüfungen#
| # | Prüfung | Bestehenskriterien | Bei einem Fehlschlag zurück zu |
|---|---|---|---|
| 1 | Klares Ziel | Ziel, Aufgabe, Klassen und Abnahmetest sind schriftlich festgehalten und abgestimmt | Beginne mit dem Geschäftsziel |
| 2 | Definierte Klassen | Für jede Klasse gibt es eine Definition und ein benanntes ähnliches Objekt, das nicht dazugehört | Ziel und Beschriftungsleitfaden |
| 3 | Repräsentative Bilder | Jedes Szenario der Spezifikation erfüllt seine Quote; die meisten Bilder stammen aus dem Produktiveinsatz | Erfasse hochwertige, repräsentative Daten |
| 4 | Ausreichender Umfang | ≥ 1.500 Bilder und ≥ 10.000 Instanzen pro Klasse oder eine dokumentierte Ausnahme | Spezifikation und Datenerfassung |
| 5 | Einheitliche Beschriftungen | Leitfaden verfasst, Kalibrierungsrunde abgeschlossen, Übereinstimmung ≥ 90 % | Bewährte Verfahren für die Annotation |
| 6 | Qualitätskontrolle abgeschlossen | Prüfskript ohne Beanstandungen, Verdachtsfälle überprüft, QC-Notizen verfasst | Qualitätskontrolle des Datensatzes |
| 7 | Saubere Aufteilungen | Gruppenbasierte Aufteilung, keine Gruppe in zwei Aufteilungen, jede Klasse in jeder Aufteilung | Teile den Datensatz richtig auf |
| 8 | Hintergrundbilder | 0–10 % der Bilder sind leere, also ohne Objekte beschriftete Einzelbilder | Spezifikation und Datenerfassung |
Die Checkliste prüft dieselben Entscheidungen, die der Leitfaden zur Datenerfassung und Annotation einzeln behandelt; hier werden sie zu einer einzigen Freigabeentscheidung zusammengeführt.
Zählbare Prüfungen automatisieren#
Die Prüfungen 4, 7 und 8 sind reine Berechnungen, daher bewertet ein Skript sie jedes Mal auf dieselbe Weise. Dieses Skript liest den Übungsdatensatz und die Aufteilungslisten ein, die group_split.py in der vorherigen Lektion erstellt hat:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesDie gruppenbasierte Aufteilung hat die Datenüberschneidung beseitigt, aber der Übungsdatensatz ist noch lange nicht bereit: Die schwächste Klasse (30, skis) hat nur eine beschriftete Instanz, und die Validierung kann die Hälfte der Klassen nicht bewerten. Das ist das zu erwartende Urteil für 128 Demobilder und genau das Urteil, das diese Prüfung vor einer Trainingswoche liefern soll.
Das Skript deckt ab, was sich zählen lässt. Für die Prüfungen 1, 2, 3, 5 und 6 braucht es einen Menschen: ein vereinbartes Ziel, schriftliche Definitionen, die Abdeckung der Spezifikation, einen gemessenen Übereinstimmungswert und QC-Notizen. Bewerte sie manuell und halte jeweils einen Beleg fest.
Entscheide: trainieren, mit einer Lücke freigeben oder korrigieren#
Wenn eine Prüfung fehlschlägt, ist der verlockende nächste Schritt fast immer etwas anderes, als die Daten zu korrigieren:
| Verlockende Abkürzung | Warum sie nicht funktioniert |
|---|---|
| „Versuch es mit einem größeren Modell.“ | Ein größeres Modell lernt Beschriftungsfehler genauso zuverlässig. |
| „Stimme die Lernrate ab.“ | Keine Optimierereinstellung ergänzt eine fehlende Klasse oder ein fehlendes Szenario. |
| „Trainiere mit mehr Epochen.“ | Mit mehr Epochen auf wenig vielfältigen Daten kommt es schneller zu Überanpassung. |
| „Füge mehr Datenaugmentation hinzu.“ | Datenaugmentation kann keine Szenarien erzeugen, die im Datensatz nie enthalten waren. |
Drei Fälle, in denen der Datensatz fast bereit ist#
| Muster | Nicht bestandene Prüfung | Woran es zu erkennen ist | Lösung |
|---|---|---|---|
| Umfang ohne Vielfalt | 3 | 5.000 Bilder, eine Kamera, keine Grenzfälle | Erfasse vor dem Training Bilder von mehr Kameras, Standorten und Zeitpunkten |
| Vielfalt ohne Einheitlichkeit | 5 | Annotatoren sind sich über Boxausdehnung und Verdeckung uneinig | Vervollständige den Leitfaden, kalibriere die Annotationen und beschrifte die betroffenen Beispiele neu |
| Unbemerkte Datenüberschneidung | 7 | Zufällige Aufteilung einzelner Videobilder | Erneut nach Clip, Kamera oder Tag aufteilen; rechne mit einem niedrigeren mAP auf dem Validierungsdatensatz, denn dieser Rückgang entspricht der Realität |
Mit einer bekannten Lücke ausliefern#
Oft ist ein gezieltes erstes Modell die richtige Entscheidung, bevor alle Prüfungen bestanden sind: ein Pilotprojekt, ein Prototyp oder eine erste Version für einen Teil der Kameras. Ein Modell im Produktivbetrieb zeigt schneller, was tatsächlich nicht stimmt, als wenn du den Datensatz im Dunkeln weiter optimierst. Wenn du mit einer Lücke auslieferst, halte drei Dinge fest:
- Welche Prüfung fehlgeschlagen ist.
- Die erwarteten Auswirkungen, zum Beispiel „keine Nachtdaten; rechne nach Einbruch der Dunkelheit mit geringerer Trefferquote“.
- Der Erfassungsplan, mit dem du die Lücke schließt, während Version 1 läuft.
„Umfang: Ausnahme“ sagt der nächsten Person nichts. „Umfang: pallet mit 700 Instanzen; geringere Erkennungsrate bei Paletten in vollen Lagerbuchten zu erwarten; bis Juni 2.000 weitere gekennzeichnet“ beschreibt ein gesteuertes Risiko. Für jede Ausnahme müssen die erwarteten Auswirkungen auf den Abnahmetest angegeben werden.
Vor jedem erneuten Training erneut prüfen#
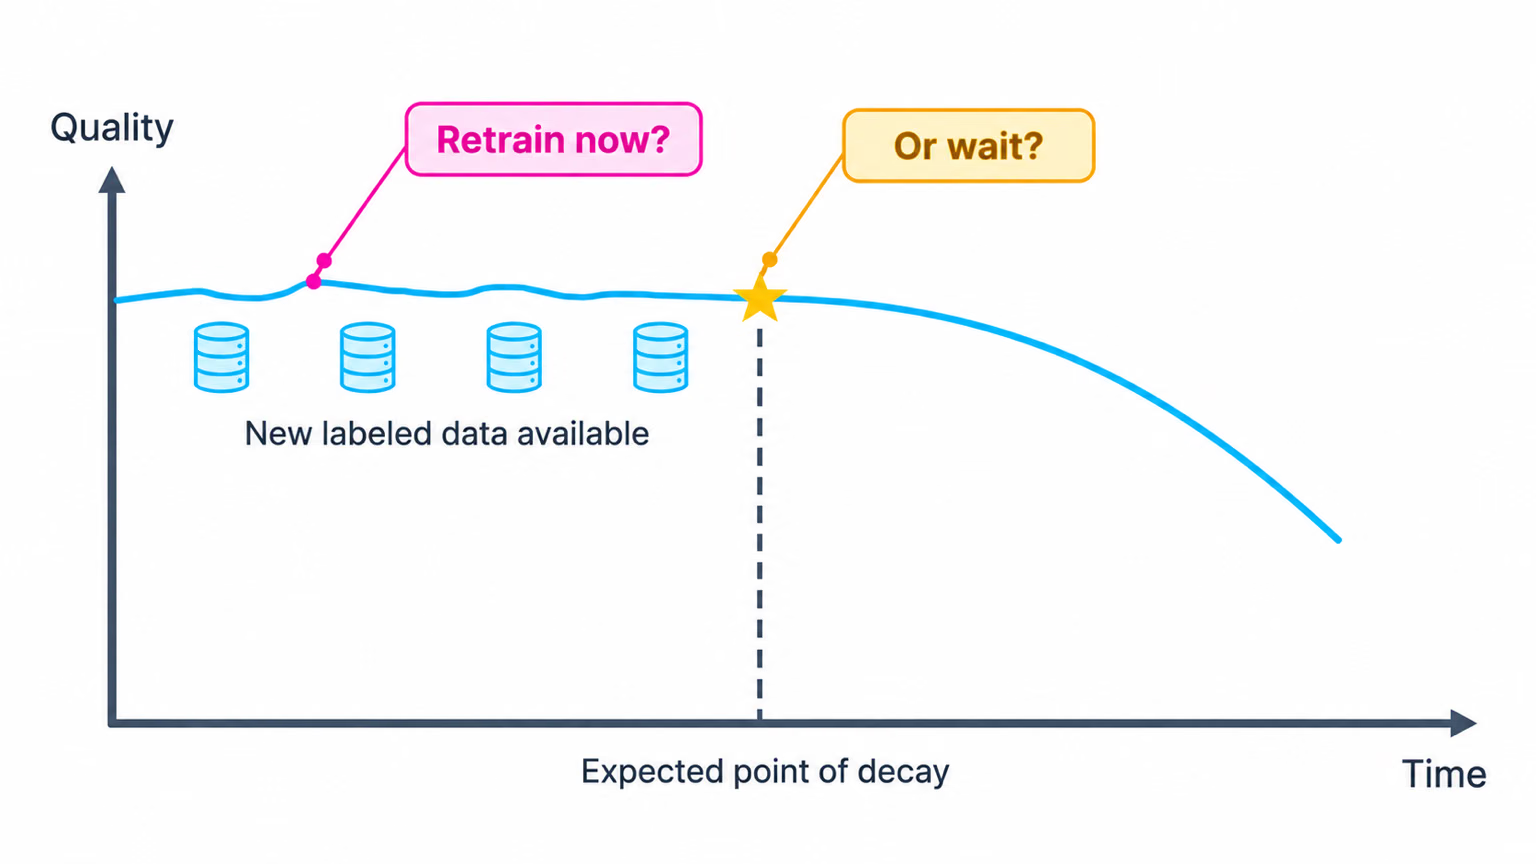
Ein Datensatz, der für Version 1 bereit war, ist nicht automatisch auch für Version 3 geeignet. Neue Klassen, neue Quellen und neue Annotatoren können jeweils eine Prüfung zum Scheitern bringen, die zuvor bestanden wurde. Außerdem verändern sich die Produktionsdaten, während immer mehr neue Annotationen hinzukommen. Führe vor jedem erneuten Training readiness.py erneut aus und bewerte die manuellen Prüfungen noch einmal; das dauert nur wenige Minuten. Wenn du darauf verzichtest, kann dich das eine Woche Training mit einem fehlerhaften Datensatz kosten.
Lösung anzeigen
Eine bewertete Checkliste für den Übungsdatensatz:
| # | Prüfung | Bewertung | Beleg |
|---|---|---|---|
| 1 | Klares Ziel | ja | objective.md und acceptance_test.py aus Lektion 1 |
| 2 | Definierte Klassen | nein | Für die 80 Klassen von COCO gibt es weder schriftliche Definitionen noch Angaben zu auszuschließenden ähnlichen Objekten |
| 3 | Repräsentative Bilder | nein | coverage.py: cam2–cam4 liegen unter der Mindestanzahl |
| 4 | Ausreichender Umfang | nein | readiness.py: Die schwächste Klasse hat 1 Bild |
| 5 | Einheitliche Annotationen | nein | Übereinstimmung von 47 % in der Kalibrierungsrunde |
| 6 | QC abgeschlossen | teilweise | Prüfung durchgeführt; Verdachtsfälle in 000000000438.jpg noch offen |
| 7 | Saubere Aufteilungen | nein | Keine gemeinsamen Gruppen, aber im Validierungsdatensatz fehlen 36 von 71 Klassen |
| 8 | Hintergrundbilder | ja | 1.6% |
Entscheidung: zuerst korrigieren. Nach Risiko für den Abnahmetest geordnet: (1) die Klassenliste auf die für das Ziel benötigten Klassen beschränken; damit werden die Prüfungen 2, 4 und 7 zugleich vereinfacht; (2) mehr Gruppen für diese Klassen sammeln; (3) die Regel im Leitfaden zu Personen in der Ferne fertigstellen und die Annotationen korrigieren. Bei einem Demodatensatz fällt diese Prüfung zu Recht durch.