Qualité des annotations
Comprends le contenu d’une étiquette YOLO, vérifie les fichiers d’étiquettes pour repérer les lignes incorrectes et assure la cohérence des annotateurs avec des consignes et une session de calibration mesurée.
Un modèle entraîné sur des étiquettes incohérentes apprend cette incohérence. Cinquante mille boîtes dessinées selon une règle claire valent mieux qu’un demi-million dessinées selon vingt interprétations personnelles, et réannoter coûte presque toujours moins cher que d’utiliser un modèle plus gros. Cette leçon te fournit un vérificateur d’étiquettes, des consignes d’une page et un indicateur de l’accord entre annotateurs.
Pratique
Ce qu’est réellement une étiquette#
Au format YOLO, chaque image possède un fichier .txt correspondant, avec une ligne par objet. Les coordonnées sont normalisées entre 0 et 1 en fonction de la largeur et de la hauteur de l’image, afin que les étiquettes restent valides après redimensionnement. La structure de la ligne dépend de la tâche :
| Tâche | Une étiquette | Remarques |
|---|---|---|
| Détection | class x_center y_center width height | Centre et dimensions de la boîte |
| Segmentation d’instance | class x1 y1 x2 y2 ... xn yn | Contour du polygone |
| Pose | class x y w h px1 py1 v1 ... pxn pyn vn | Boîte, puis points clés avec visibilité facultative |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Quatre sommets de la boîte orientée |
| Classification | Aucun fichier d’étiquettes | Images réparties dans un dossier par classe |
| Segmentation sémantique | Un masque PNG par image | Chaque valeur de pixel correspond à un indice de classe |
| Estimation de la profondeur | Un fichier PNG ou NPY de profondeur par image | Chaque valeur de pixel correspond à une distance |
Les indices de classe commencent à 0 et correspondent aux noms définis dans le YAML du jeu de données. Une image sans objet n’a pas besoin de fichier d’étiquettes — c’est ainsi que fonctionnent les images d’arrière-plan. Les pages sur les jeux de données au format de détection, la segmentation sémantique et la profondeur proposent des exemples fonctionnels.
Vérifie tes fichiers d’étiquettes#
Les lignes incorrectes peuvent passer inaperçues : une coordonnée supérieure à 1, un identifiant de classe non défini dans le YAML ou le même objet encadré deux fois deviennent autant de bruit que le modèle tente d’apprendre. Un petit vérificateur les repère avant l’entraînement :
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesL’exemple créé à la main illustre chaque erreur détectée par le vérificateur ; le vrai jeu de données ne présente aucun problème. Exécute-le après chaque lot d’annotations et avant chaque entraînement — cela ne prend que quelques secondes.
Pourquoi les étiquettes divergent#
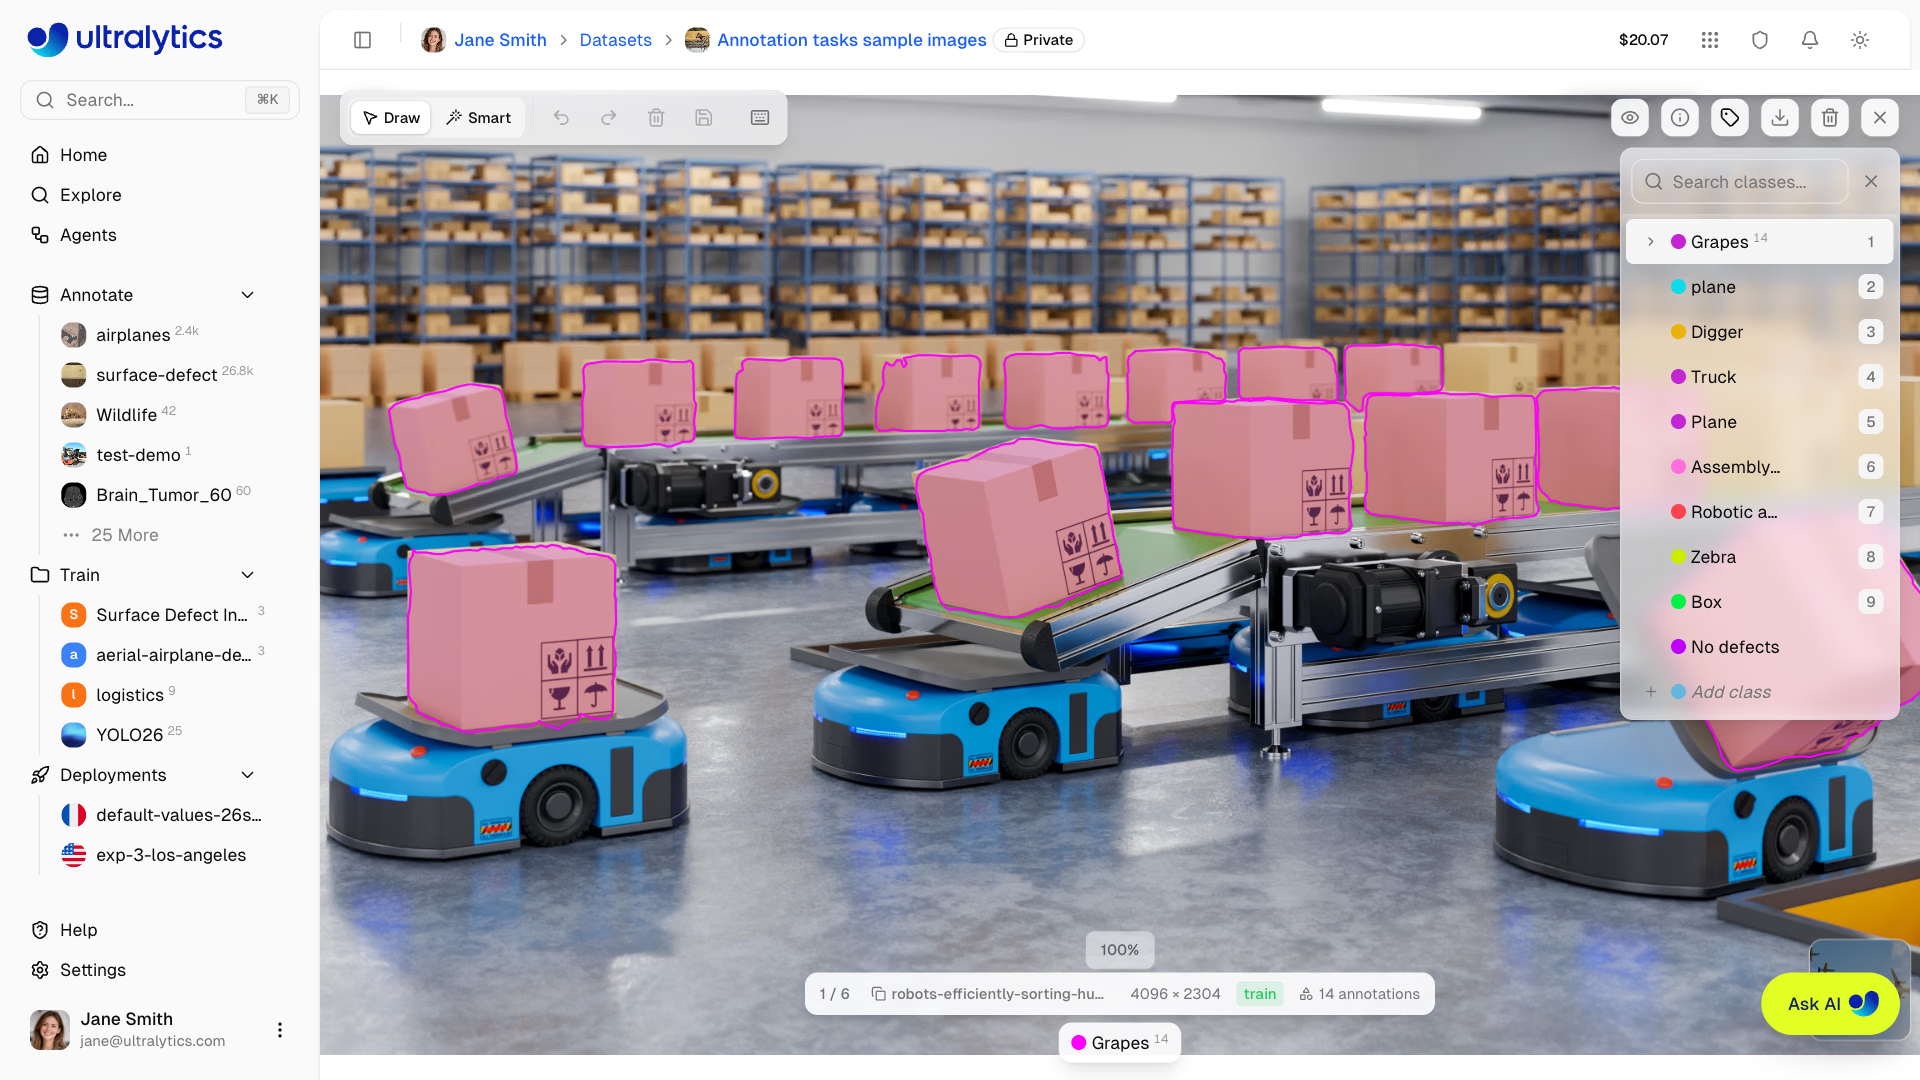
Observe le panneau des classes dans cet éditeur : les 14 polygones de cartons sont enregistrés sous Grapes, tandis qu’une classe Box apparaît plus bas dans la liste — et plane et Plane existent comme deux classes distinctes. Un vérificateur ne peut repérer aucun de ces problèmes, car chaque ligne est valide ; un réviseur qui compare les étiquettes aux consignes les repérerait tous les deux en quelques secondes. La plupart des erreurs d’étiquetage sont de ce type : des fichiers valides, mais des décisions incorrectes.
Les annotateurs produisent rarement de mauvaises annotations par négligence. Leurs annotations manquent de cohérence parce que les règles sont ambiguës et que chacun fait une supposition raisonnable, mais différente :
- Où la boîte doit-elle s’arrêter ? À l’ombre, au sac porté, à la charge sur les fourches du chariot élévateur ?
- Troncature. Une personne à moitié hors du cadre est-elle encore une
person? À partir de quelle fraction visible ? - Occultation. Faut-il annoter une voiture dont on ne voit qu’une roue ou l’ignorer ?
- Limites entre les classes. Un pick-up est-il une
carou unetruck? Un scooter est-il unebicycleou uneother? - Cas à ne pas annoter. Reflets, affiches et écrans représentant l’objet.
Chaque choix convient, à condition que tout le monde fasse le même.
Des consignes d’une page#
Elles tiennent sur une page, comportent une image d’exemple pour chaque règle et présentent d’abord les cas limites :
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Mesurer l’accord lors d’une session de calibration#
Avant de passer d’un à vingt annotateurs, tout le monde annote les mêmes 50 images et tu compares les résultats :
L’accord correspond à la proportion d’objets que les deux annotateurs ont délimités avec la même classe et un IoU d’au moins 0,5 — une mesure pratique de la fiabilité inter-évaluateurs :
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%Deux types de désaccord se cachent dans ces 67 %. La boîte du chariot élévateur de Bob commence 80 pixels plus haut — il a inclus le sommet du mât — mais correspond quand même à un IoU de 0,83 : cela compte donc comme un accord ; précise la règle de délimitation si ton produit mesure la hauteur. Le troisième objet révèle un véritable conflit : Alice indique person, Bob indique pallet_jack. Il faut une règle plus claire et une image d’exemple, puis refaire une session. Conserve les 50 images de calibration : elles serviront de test d’intégration pour chaque nouvel annotateur.
Un réviseur qui corrige discrètement les étiquettes supprime la boucle de rétroaction, et les annotateurs n’apprennent jamais ce qu’ils ont fait de travers. Rejette l’étiquette en indiquant la raison, et laisse l’annotateur la corriger. C’est plus lent pour les cent premières images, mais beaucoup plus rapide ensuite.
Éléments à suivre#
| Indicateur | Ce qu’il t’indique |
|---|---|
| Débit (objets par heure) | Capacité et coût |
| Taux de rejet | Évolution de la qualité |
| Accord sur un ensemble commun de recouvrements | Les annotateurs appliquent-ils toujours les mêmes règles ? |
Quand l’accord baisse, quelque chose a changé : un nouvel annotateur, une nouvelle caméra, un lot ambigu, la fatigue. Si le modèle échoue ensuite dans une condition précise, renvoie exactement ces images à l’annotation — c’est la boucle qu’automatise l’apprentissage actif, et la principale source de gains de précision dans le monde réel. Parcours et filtre les erreurs dans tes jeux de données sur Ultralytics Platform, et consulte Contrôle qualité des jeux de données et Bonnes pratiques d’annotation pour appliquer cette méthode à grande échelle.
Afficher la solution
Consignes pour la classe pill de medical-pills, rédigées après une session de calibration sur 10 images :
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
Comment interpréter le score d’accord : supposons que le premier tour obtienne 82 %. Trie les objets sans correspondance selon leur cause. Pour les blisters, les deux cas habituels sont les boîtes dessinées autour de la bulle en plastique au lieu du comprimé (corrigées par la première règle de délimitation, avec une image d’exemple) et les comprimés masqués par les reflets qu’un annotateur a ignorés (corrigés par la deuxième règle d’inclusion). Recommence sur 10 images nouvelles ; passe à l’échelle supérieure uniquement lorsque le score dépasse le seuil de 90 %.