Bonnes pratiques d’annotation
Rédige un guide d’annotation, choisis un outil, évite les dix erreurs qui nuisent discrètement à la précision et mesure l’accord entre annotateurs à l’aide d’un script avant de passer à l’échelle supérieure.
La qualité des annotations plafonne celle du modèle. Dix annotateurs qui interprètent chacun le terme « palette » légèrement différemment produisent un jeu de données qui apprend simultanément ces dix interprétations ; aucune quantité d’entraînement ne résout cette contradiction. Un guide écrit, une session de calibrage mesurée et une courte liste d’erreurs connues permettent de garder des annotations cohérentes, qu’une seule personne annote 500 images ou qu’une équipe en annote 50 000.
Pratique
Choisis l’outil d’annotation#
L’outil adapté dépend de la tâche, de l’équipe et de l’endroit où se déroule l’entraînement :
| Outil | Idéal pour | Remarques |
|---|---|---|
| Ultralytics Platform | Les sept tâches YOLO : un éditeur pour les boîtes, les polygones, les masques sémantiques, les points clés, les boîtes orientées et les classes d’image, ainsi que les cartes de profondeur téléversées ; annotation intelligente SAM | Annotations, graphiques du jeu de données et entraînement au même endroit ; aucune étape d’exportation |
| CVAT | Grandes équipes, vidéos et processus de révision complexes | Auto-hébergé ou dans le cloud |
| Label Studio | Projets multimodaux (image + texte + audio) | Configuration flexible, mais apprentissage plus difficile |
| Labelme | Annotation par polygones pour les petites équipes | Application de bureau simple |
| LabelImg | Prototypes rapides avec des boîtes uniquement | Léger ; le dépôt est archivé |
Sur Ultralytics Platform, l’annotation intelligente SAM 2.1, SAM 3 et SAM 3.1 fonctionne avec les jeux de données de détection, de segmentation, de segmentation sémantique et OBB. Quel que soit ton choix, vérifie que l’outil exporte le format YOLO adapté à ta tâche ; Préparer un jeu de données personnalisé explique le format des annotations et leur conversion.
Les sept types d’annotation#

| Type d’annotation | Ce que tu dessines | Tâche |
|---|---|---|
| Étiquette de classe | Une étiquette par image | Classification |
| Boîte englobante | Rectangle aligné sur les axes pour chaque objet | Détection |
| Polygone | Contour de chaque instance d’objet | Segmentation d’instance |
| Masque dense | Une classe pour chaque pixel | Segmentation sémantique |
| Points clés | Points nommés tels que les articulations | Pose |
| Boîte orientée | Rectangle pivoté pour chaque objet | OBB |
| Carte de profondeur | Rien : une carte des distances par pixel issue d’un capteur de profondeur, associée à chaque image | Estimation de profondeur |
Rédige d’abord le guide d’annotation#
Avant que quiconque ne dessine une boîte, rédige un guide composé de cinq sections :
- Définitions des classes : un paragraphe par classe, avec des exemples positifs, des objets ressemblants qui ne font pas partie de la classe et des cas limites.
- Règles de dessin : des boîtes ajustées à l’objet visible ; des polygones qui suivent son contour visible.
- Règles d’occlusion et de taille : un seuil pour les objets partiels (« annote si tu peux identifier la classe ») et un pour les objets minuscules (« annote les personnes de plus de 10 pixels »), appliqués partout.
- Journal des cas ambigus : chaque question du type « qu’en est-il de celui-ci ? », avec la réponse convenue et une capture d’écran.
- Éléments à ignorer : tout ce qu’il ne vaut pas la peine d’annoter pour cette tâche.
Une ou deux pages avec des captures d’écran suffisent largement. Le guide sert ensuite de base à une courte boucle de travail effectuée avant de passer à l’échelle supérieure pour l’annotation :
Étiquette tous les objets pertinents dans chaque image. Un chariot élévateur non étiqueté apprend au modèle que les chariots élévateurs font parfois partie de l’arrière-plan, et le modèle apprend donc à ne pas les détecter. Un jeu de données partiellement étiqueté semble identique à un jeu de données plus petit et entièrement étiqueté, jusqu’à ce que tu lances l’entraînement. Termine chaque image avant de passer à la suivante.
Dix erreurs qui nuisent à la précision#
Les erreurs que l’équipe d’annotation d’Ultralytics rencontre le plus souvent, illustrées par des images de chariots élévateurs, de personnes et de palettes (adaptées d’une présentation d’Alexis Schutzger). Utilise-les comme premières entrées de ton guide.
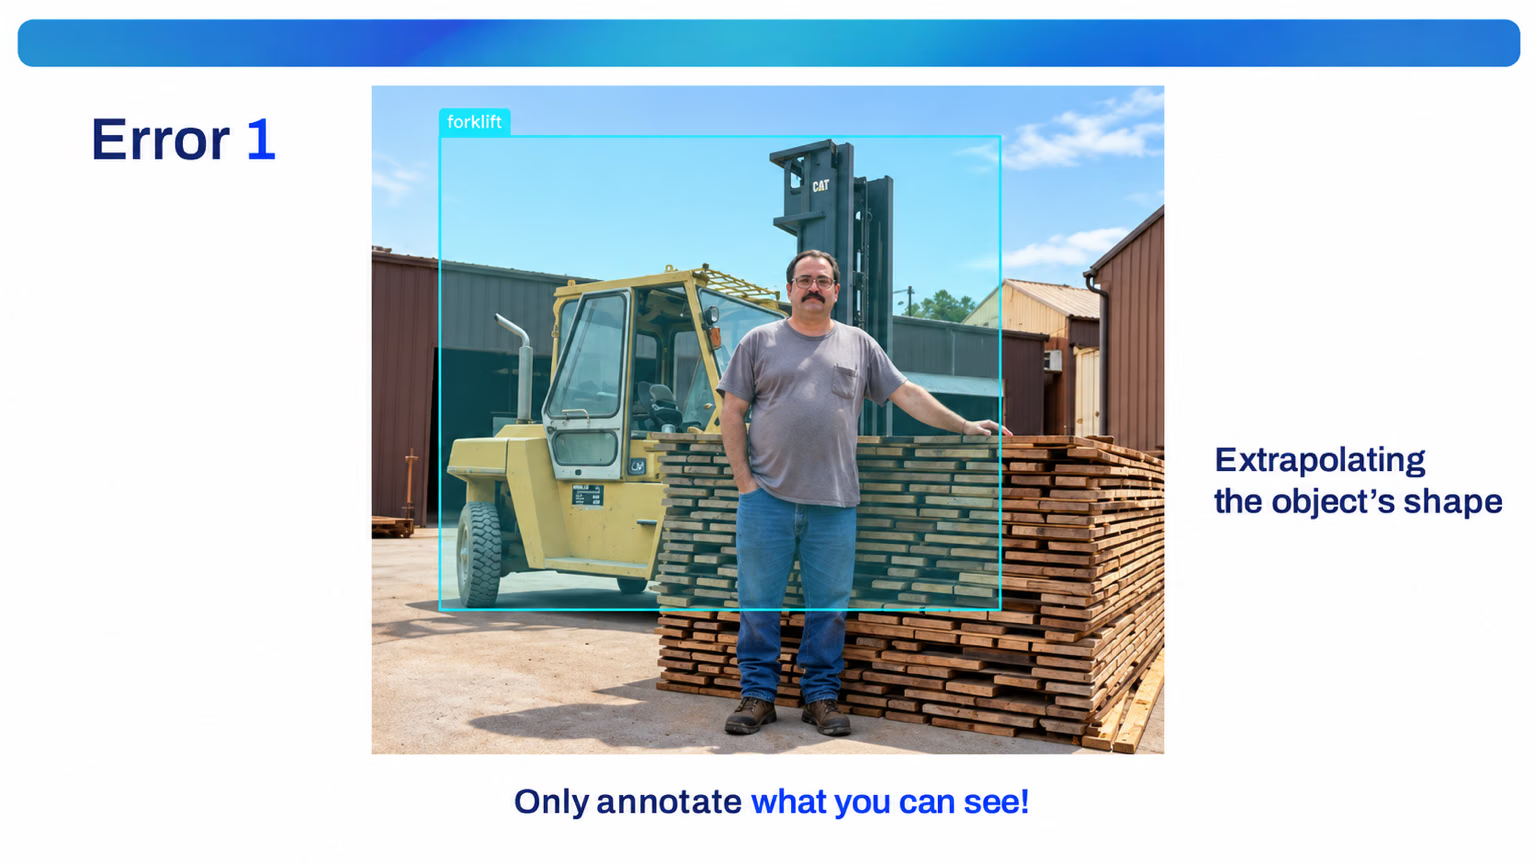
1. Extrapoler la forme de l’objet. Annote uniquement ce que tu peux voir. Ici, le chariot élévateur se trouve derrière une personne et une pile de bois, mais sa boîte englobe les deux, jusqu’à l’endroit où l’annotateur a imaginé le reste du véhicule. Encadre uniquement la partie visible.
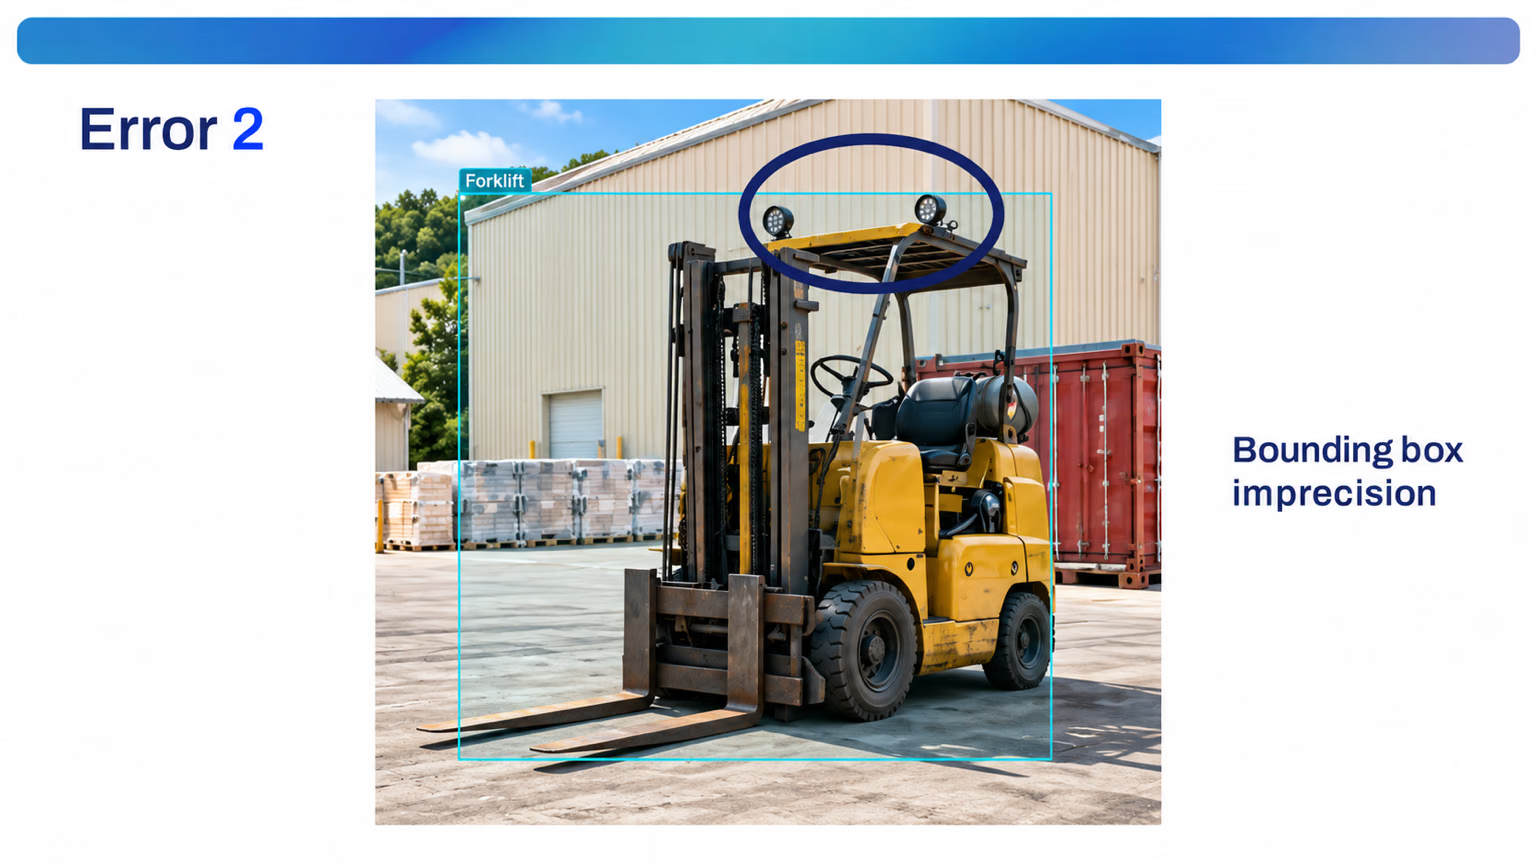
2. Boîtes imprécises. Les boîtes doivent épouser l’objet. Celle-ci coupe les lumières du toit de protection ; une boîte qui coupe une partie de l’objet ou laisse une marge de sol apprend au modèle une étendue incorrecte.
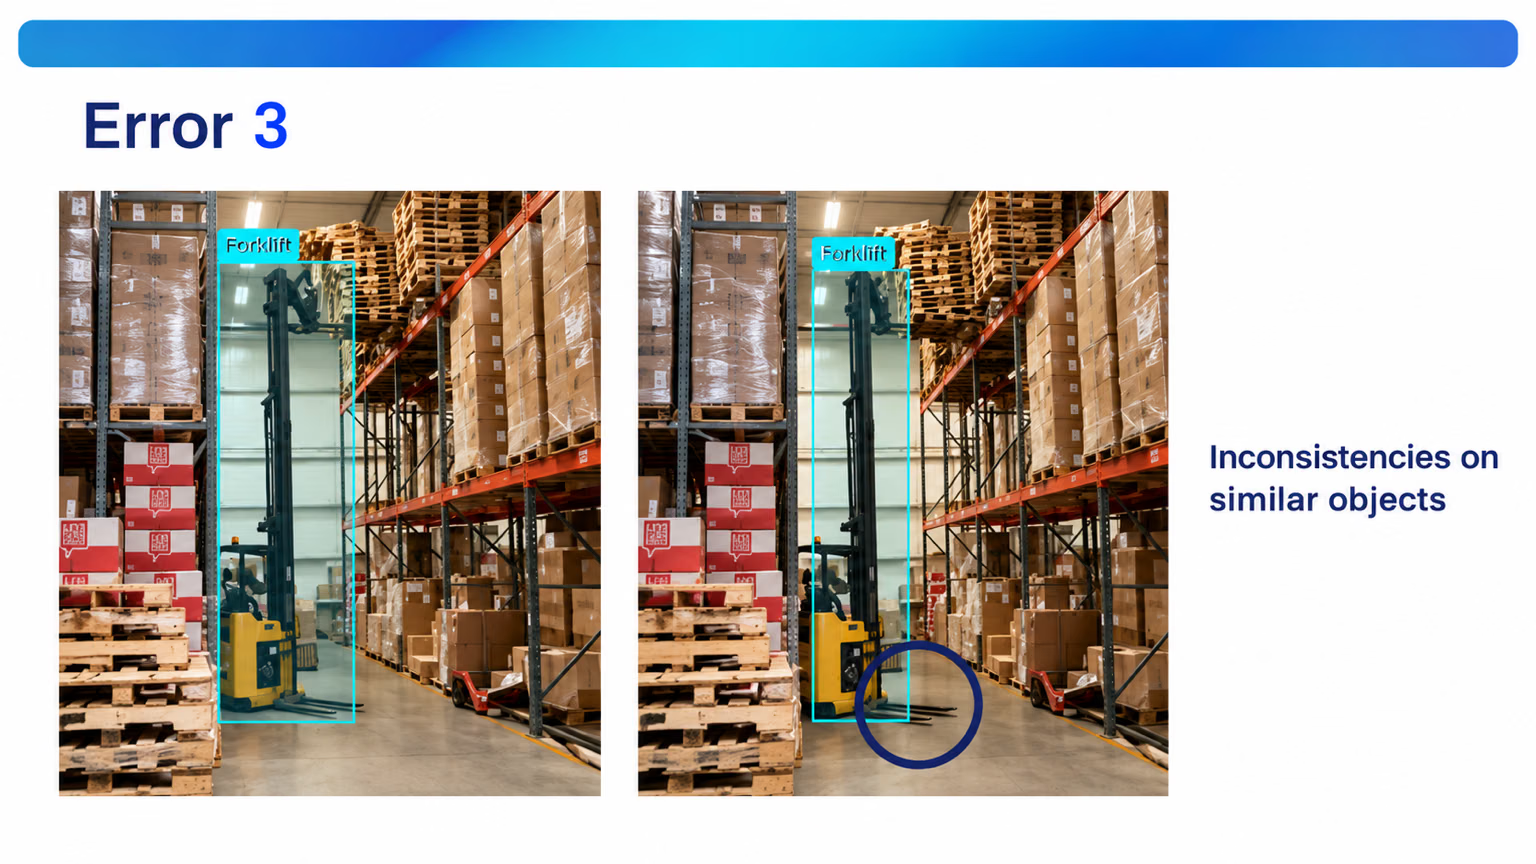
3. Conventions incohérentes pour des objets similaires. La boîte de gauche inclut les fourches ; celle de droite les exclut. Le modèle reçoit deux réponses à la même question : note donc la convention à suivre, fourches incluses ou exclues.
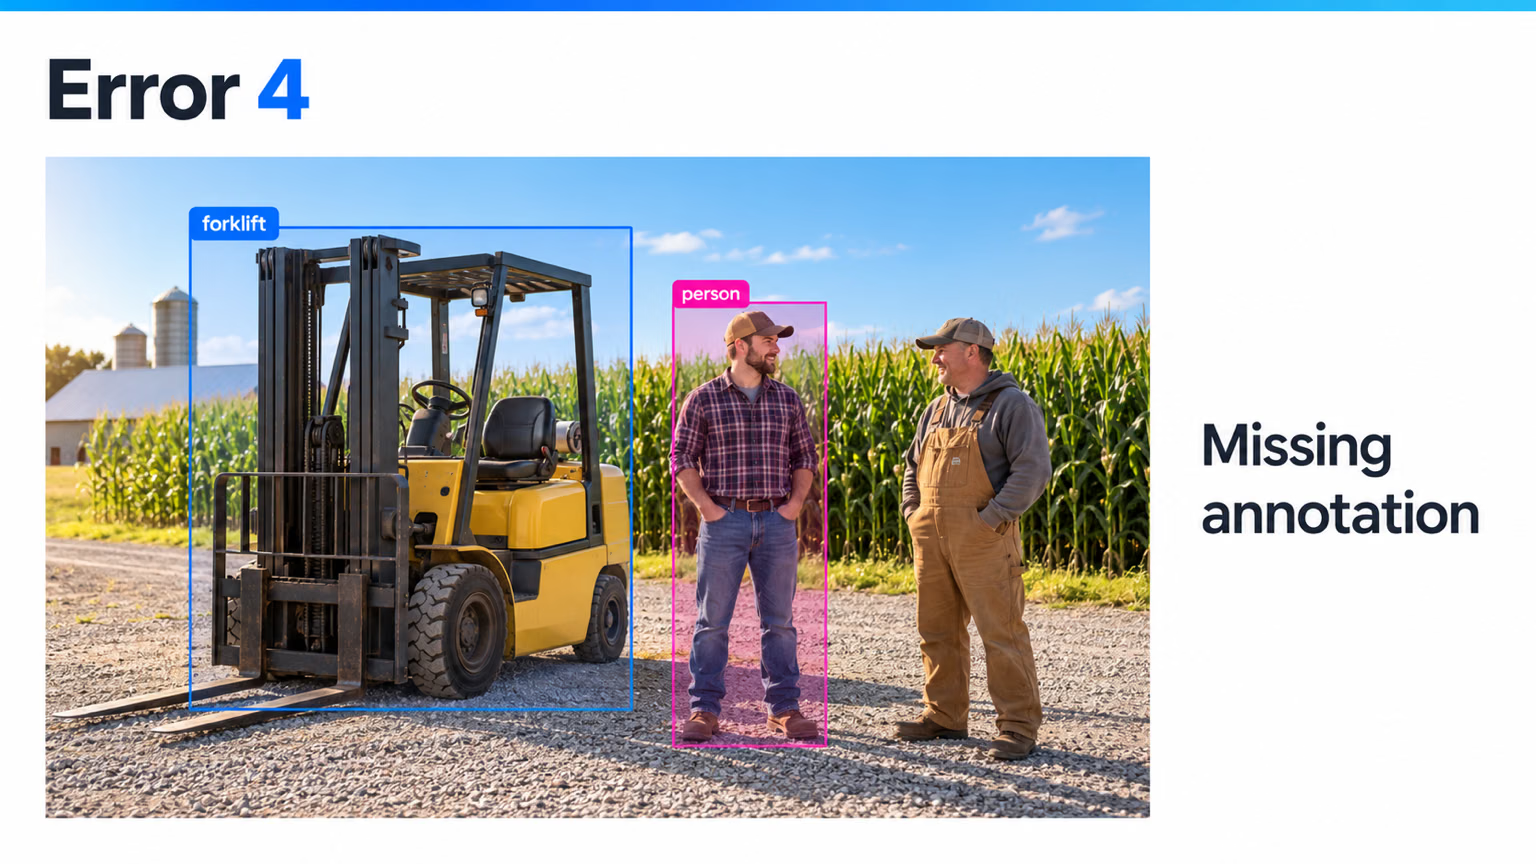
4. Annotations manquantes. Deux personnes se tiennent à côté du chariot élévateur, mais une seule est encadrée. La personne sans annotation apprend au modèle que « les personnes font partie de l’arrière-plan ».
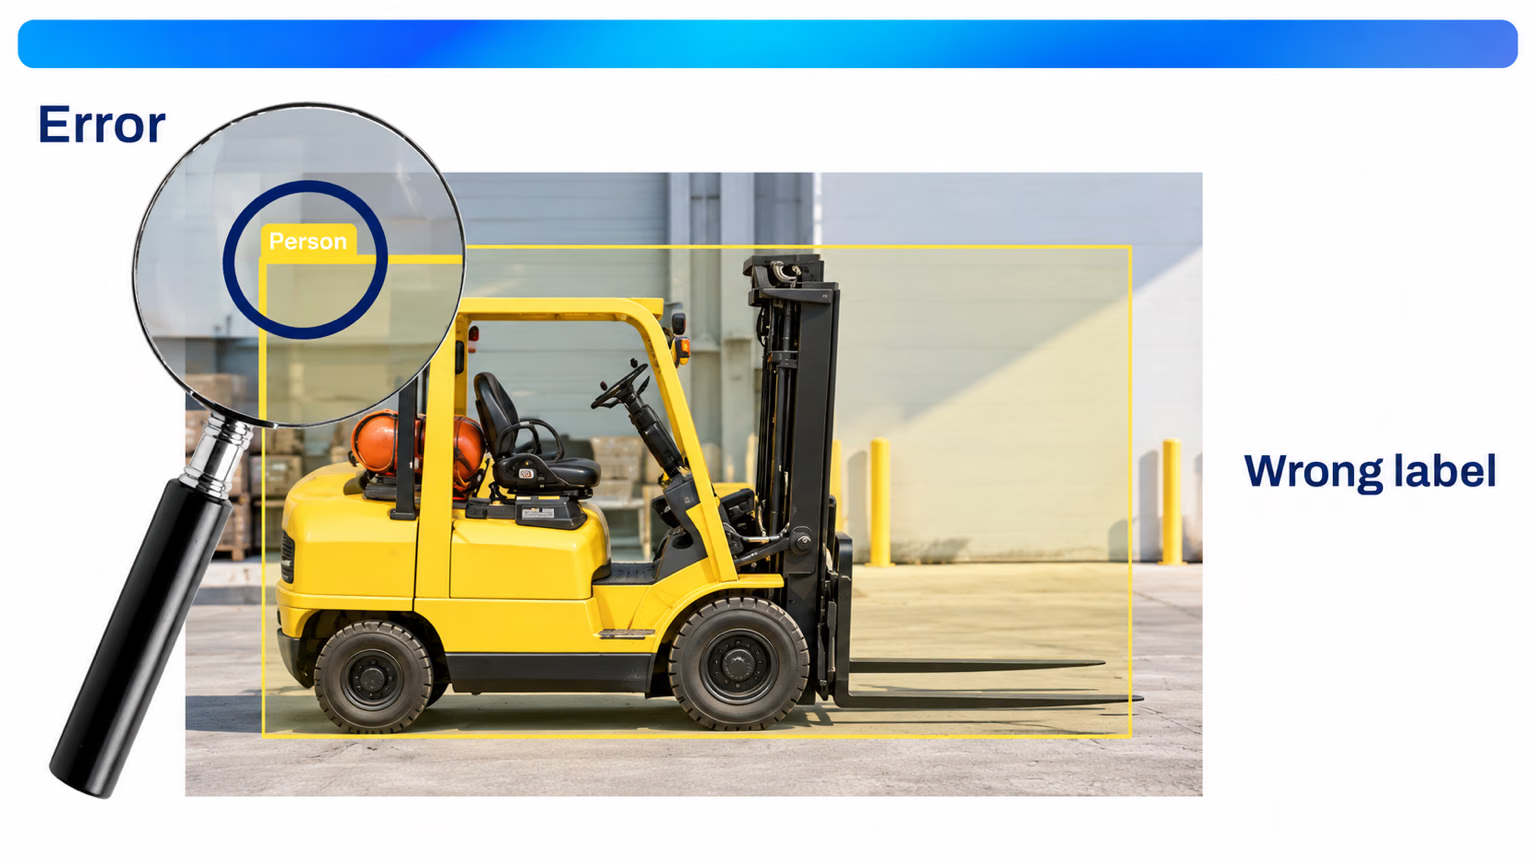
5. Mauvaise classe. Vérifie la classe, pas seulement la boîte. Une boîte correcte autour d’un chariot élévateur étiqueté person corrompt les deux classes, généralement à cause d’une erreur de raccourci clavier.
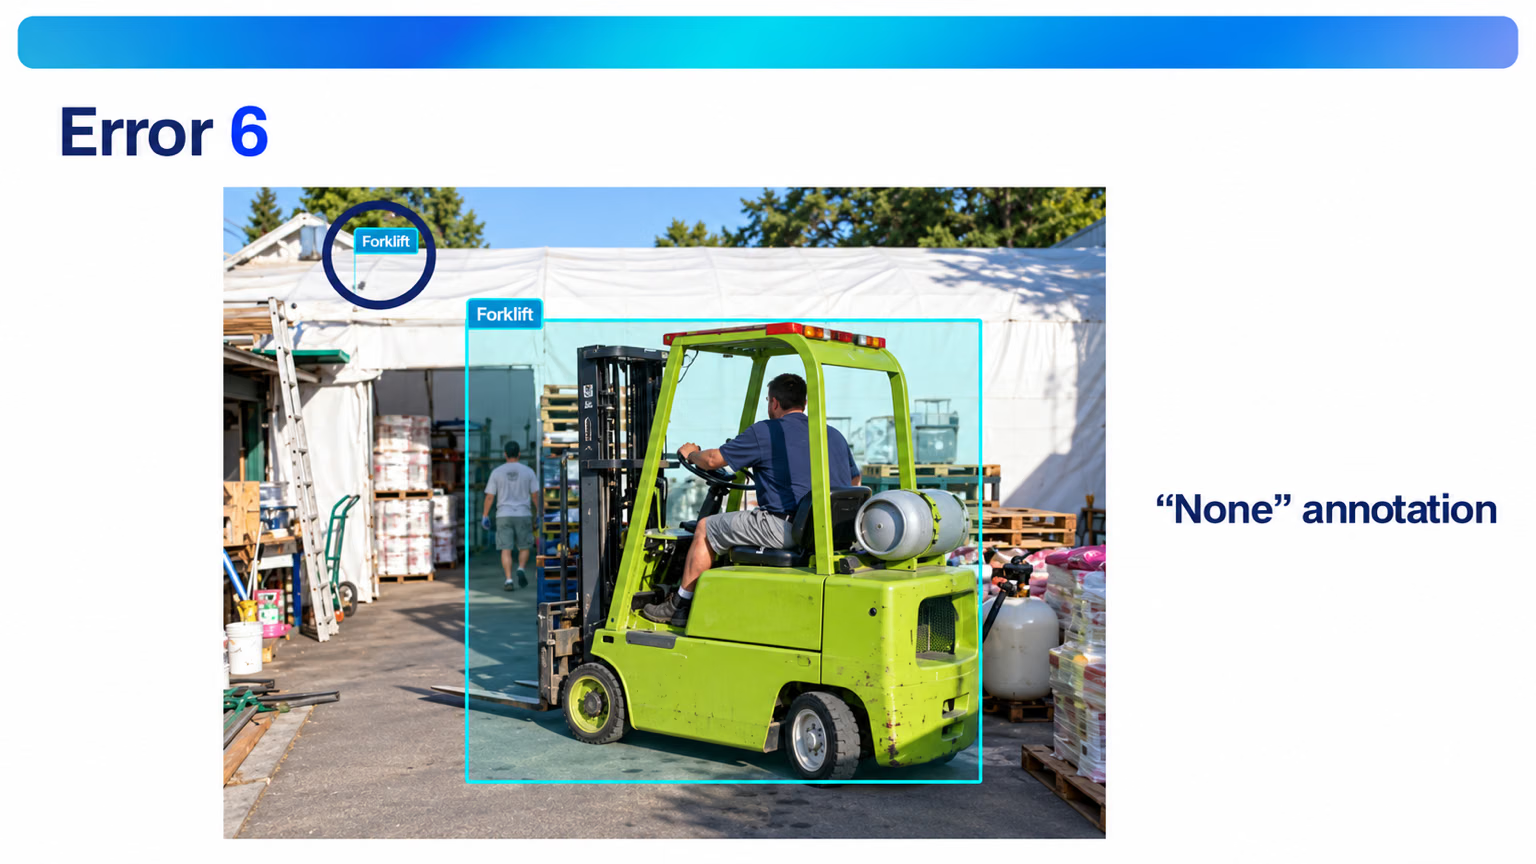
6. Annotations vides ou parasites. Chaque annotation doit correspondre à un véritable objet et à une véritable classe. Un clic parasite laisse une boîte presque vide comme celle dans le coin, et une boîte enregistrée sans classe peut être exportée sous None ou avec la classe 0. Corrige-les ou supprime-les.
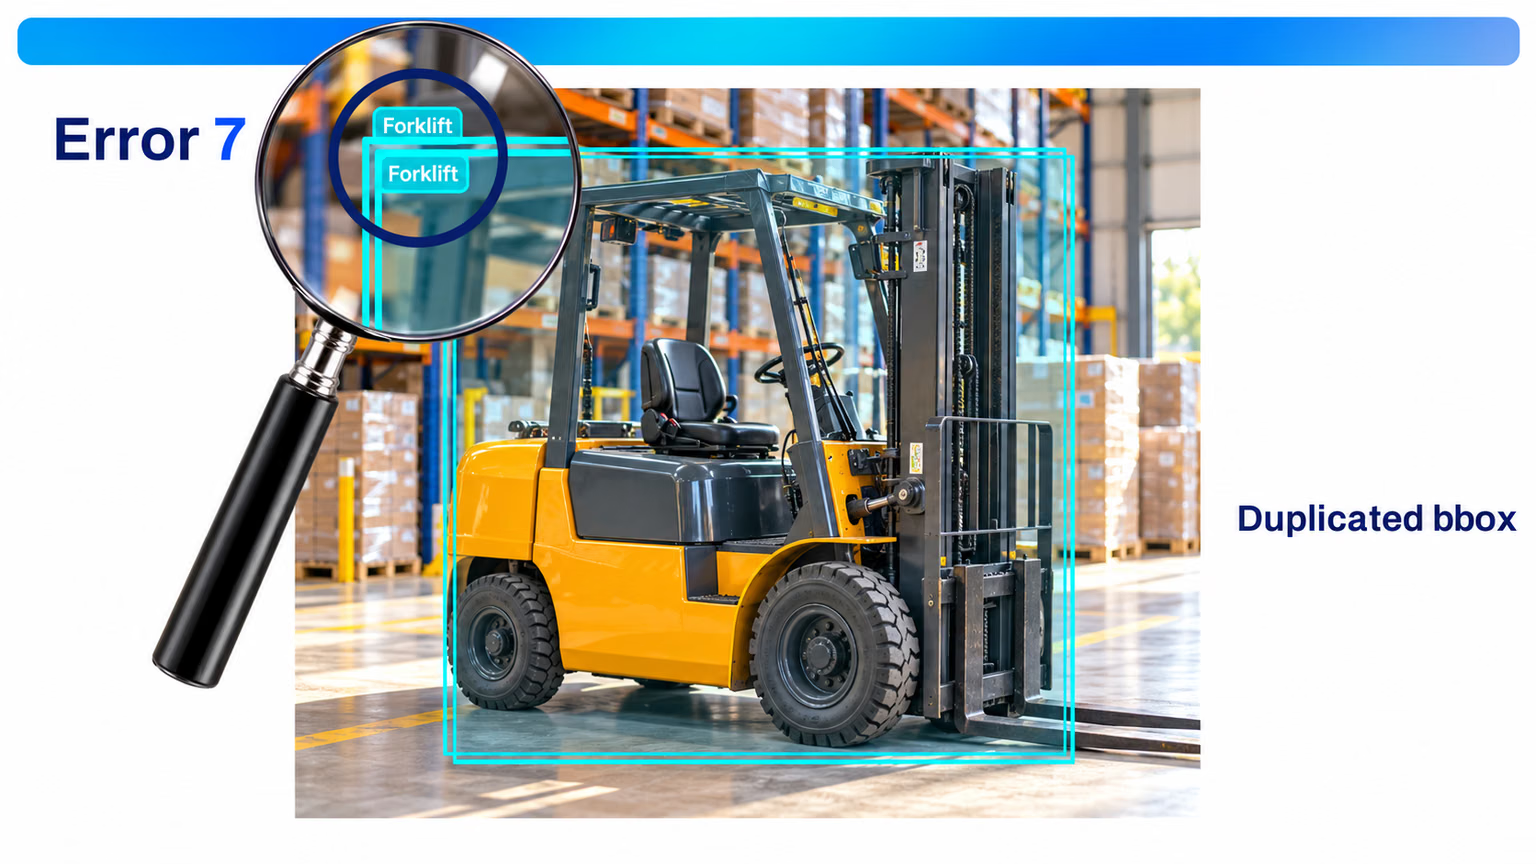
7. Boîtes en double. Un objet, une boîte. Deux boîtes qui se chevauchent sur le même chariot élévateur gonflent le nombre d’instances et apprennent au modèle à prédire des doublons.
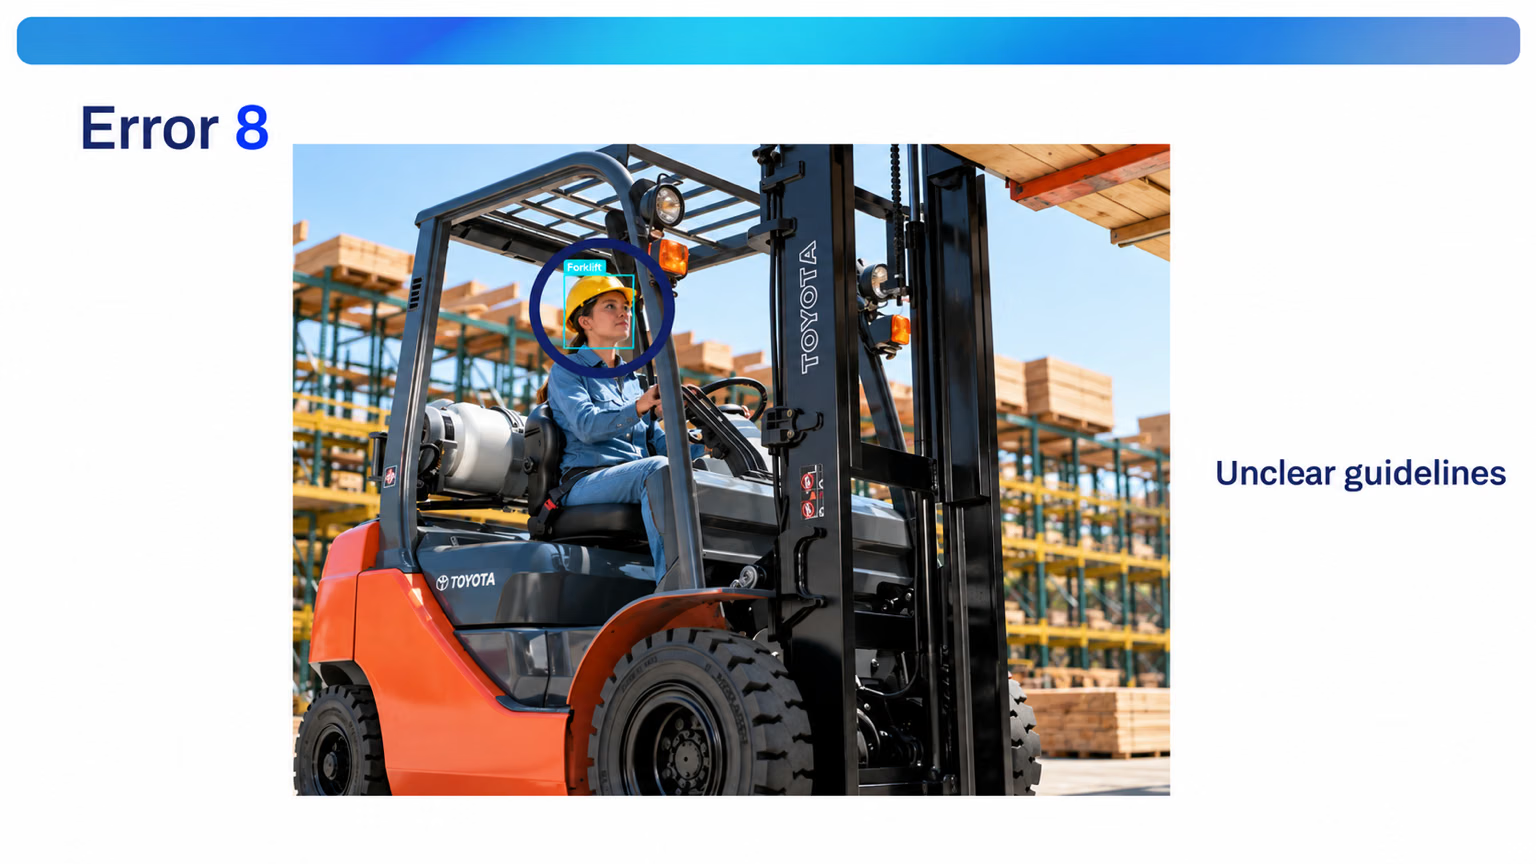
8. Consignes peu claires. Sans règle écrite, les annotateurs improvisent : ici, l’un a encadré uniquement la tête du conducteur et lui a attribué la classe forklift. Le conducteur fait-il partie du chariot élévateur, ou s’agit-il d’un person distinct ? Réponds une fois à cette question dans le guide.
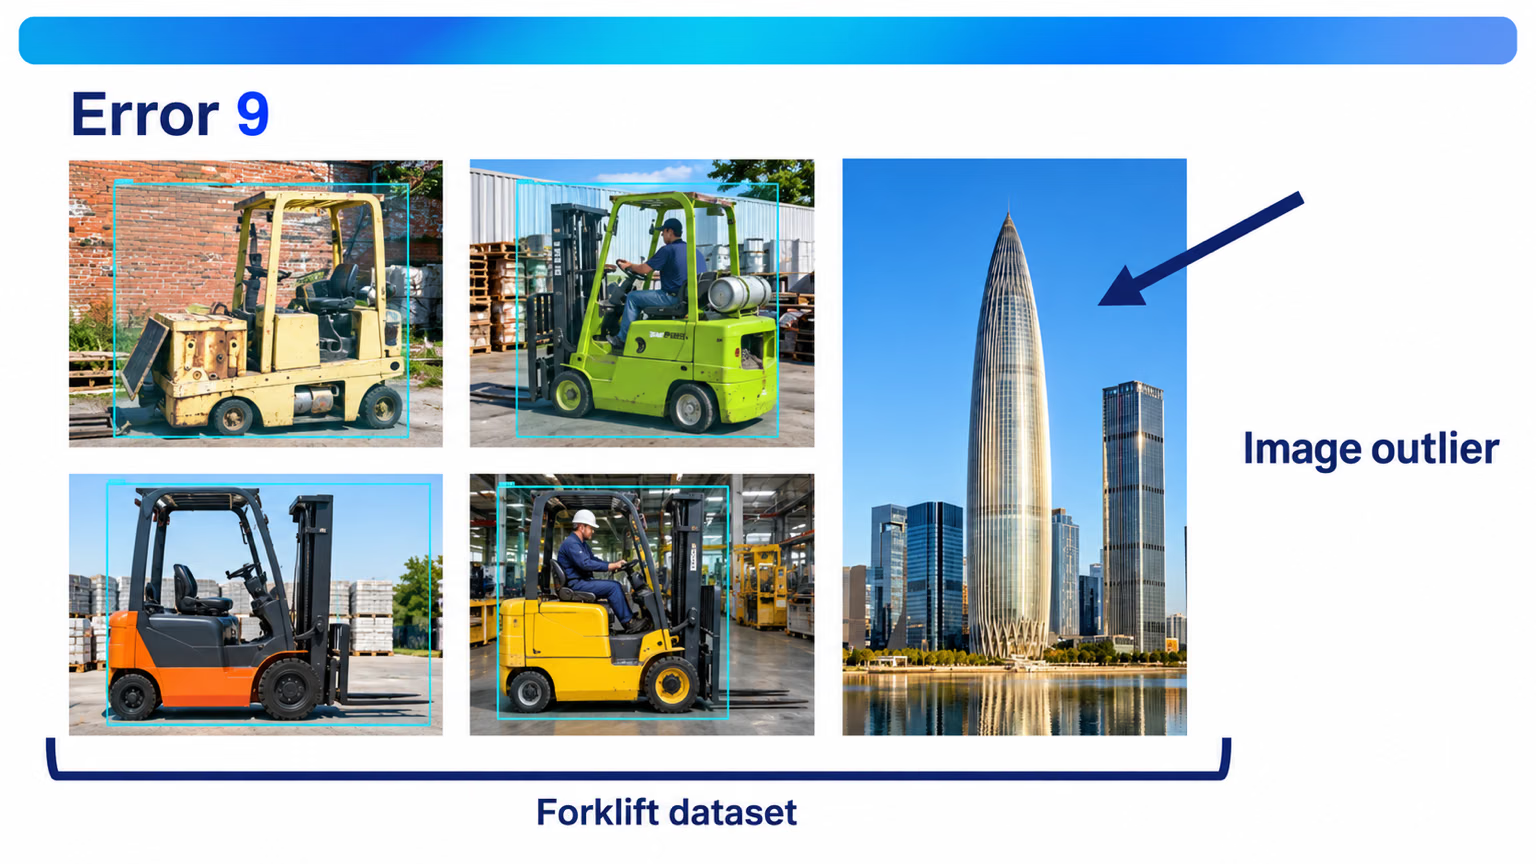
9. Images aberrantes. Écarte les images qui ne correspondent pas au déploiement. Une photo de panorama urbain dans un jeu de données de chariots élévateurs n’apporte rien d’utile et dilue le reste.
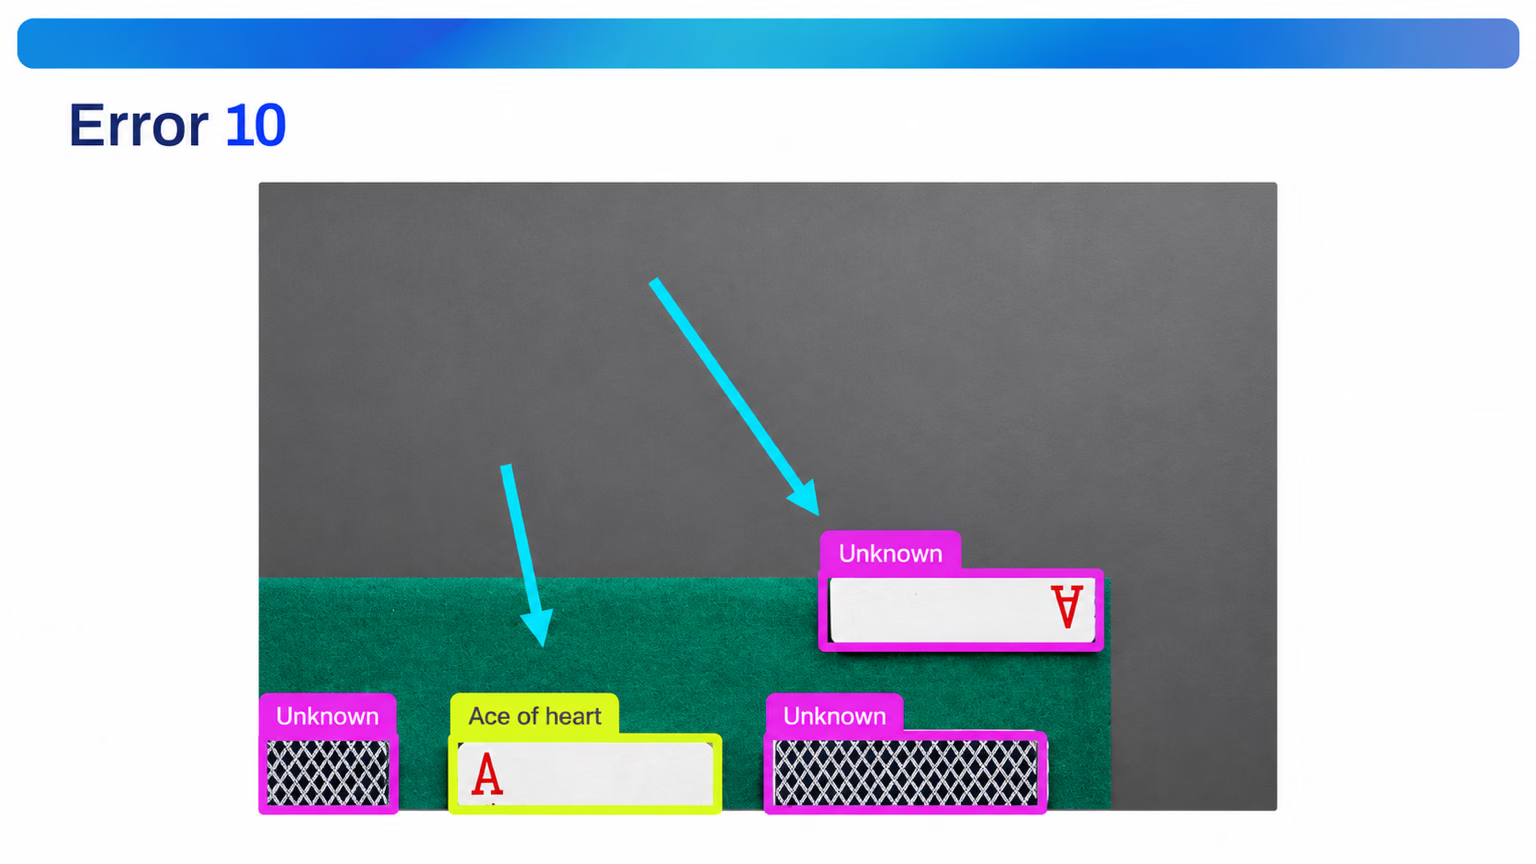
10. Ambiguïté induite par l’augmentation. Si un recadrage peut supprimer la caractéristique qui définit une classe, deux classes deviennent identiques. Coupe le symbole dans le coin d’un as de cœur : il ressemble alors aux cartes étiquetées unknown. Utiliser l’augmentation avec précaution explique comment corriger le problème.
Mesure l’accord, ne le devine pas#
Une phase de calibration donne les mêmes images à deux annotateurs et compare leurs étiquettes objet par objet. Deux étiquettes concordent si elles ont la même classe et se chevauchent selon un IoU d’au moins 0,5. Ce script calcule le score sur les images de validation de COCO8. Pour pouvoir l’exécuter sans deuxième personne, un modèle préentraîné joue le rôle de l’annotateur B ; avec une vraie équipe, lis plutôt les boîtes de B dans ses fichiers d’étiquettes :
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%Comment interpréter le résultat :
- Le score correspond au nombre d’objets appariés divisé par le nombre total d’objets dessinés par l’un ou l’autre annotateur : 8 sur 17.
- Les désaccords se concentrent. Les neuf désaccords se trouvent dans deux images, et la plupart concernent des personnes couvrant bien moins de 1 % de l’image. Ce ne sont pas neuf erreurs aléatoires, mais une seule règle manquante : étiquetons-nous les personnes éloignées ?
- La solution consiste à ajouter une consigne au guide, par exemple « étiqueter toute personne mesurant au moins 10 pixels de haut dans une image de 640 pixels ». Les deux annotateurs réétiquettent ces deux images, puis le score est recalculé.
La règle de décision : n’augmente l’échelle de l’annotation que lorsque l’accord atteint 90 %. En dessous, chaque nouvel annotateur multiplie les incohérences.
Utilise l’annotation intelligente pour accélérer le travail#
L’annotation intelligente permet à un modèle YOLO ou SAM de proposer des étiquettes qu’une personne accepte ou corrige, ce qui peut multiplier le débit plusieurs fois. Procède par cycles : entraîne un modèle sur un lot vérifié, utilise-le pour proposer les étiquettes du lot suivant, vérifie-les, puis réentraîne le modèle. C’est le cycle d’apprentissage actif, présenté dans Annotation intelligente et étiquetage par lots sur Ultralytics Platform.
Un modèle qui ne détecte pas les petites personnes ne propose aucune boîte pour elles, et un réviseur qui clique sur « tout accepter » ne les ajoute jamais. Le modèle suivant, entraîné sur ces étiquettes, les manque avec encore plus d’assurance. Révise chaque image et ajoute les éléments manqués par le modèle, en plus de corriger ce qu’il a dessiné.
Vérifie à l’œil#
Chaque entraînement Ultralytics écrit labels.jpg et train_batch*.jpg dans son dossier d’exécution. Le premier trace le nombre de classes ainsi que la position et la taille des boîtes ; les autres montrent de vraies images d’entraînement avec leurs étiquettes. Ouvre-les avant la fin de la première époque. L’œil repère ce que les métriques ne verront jamais : des boîtes autour des ombres, des ID de classe inversés et des polygones qui ne se referment pas.
Afficher la solution
Les désaccords sur COCO8 donnent lieu à des consignes comme celles-ci dans le guide :
| Désaccord | Règle ajoutée au guide |
|---|---|
Personnes éloignées dans 000000000049.jpg étiquetées uniquement par A | Étiqueter toute personne mesurant au moins 10 pixels de haut dans une image de 640 pixels ; ignorer les personnes plus petites dans toutes les images. |
| Plante en pot au bord de l’image étiquetée uniquement par A | Étiqueter un objet coupé par le bord de l’image si au moins la moitié de l’objet est visible. |
Éléphant partiellement caché par un autre éléphant dans 000000000061.jpg | Étiqueter les animaux occultés si leur tête ou la moitié de leur corps est visible ; encadrer uniquement la partie visible. |
Pour comparer deux personnes plutôt qu’une personne et un modèle, lis les lignes de l’annotateur B dans le second dossier d’étiquettes, exactement comme le script lit celles de A (Path("labels_b", image.stem + ".txt")), crée b_cls et b_box à partir de ces lignes avec les mêmes deux lignes de code, puis utilise-les partout où le script lit b.cls et b.xyxyn. Relance le script après la réannotation ; le cycle est terminé lorsque le score dépasse 90 %.