Diviser correctement le jeu de données
Mesure les fuites dues aux divisions aléatoires, divise des groupes entiers comme les séquences vidéo, les caméras ou les jours à l’aide d’un script, vérifie la présence de toutes les classes et verrouille le jeu de test.
Une division négligente produit une métrique à laquelle tu te fies, mais qui est fausse. Quand des images vidéo consécutives se retrouvent à la fois dans l’entraînement et dans la validation, la mAP de validation mesure la mémorisation plutôt que la capacité de généralisation, et l’écart n’apparaît qu’en production. Chaque chiffre que tu communiques au sujet du modèle dépend de cette division : choisis-la donc délibérément une fois, puis garde-la fixe.
Pratique
Trois partitions, trois rôles#
| Partition | Part typique | Rôle |
|---|---|---|
| Entraînement | 70% | Le modèle en apprend ses poids |
| Validation | 15% | Choisir la meilleure époque, comparer les exécutions et ajuster les paramètres |
| Test | 15% | Une décision finale par rapport au test d’acceptation |
Les guides Ultralytics recommandent 70–80 % pour l’entraînement et 10–20 % pour chacun des sous-ensembles de validation et de test : les étapes d’un projet de vision par ordinateur suggèrent 10–15 % pour chacun, et le guide de prétraitement utilise une répartition 70/20/10. Compte les parts en objets aussi bien qu’en images, car une image très dense peut contenir davantage d’annotations que dix images peu denses. Les pourcentages exacts importent beaucoup moins que l’usage de chaque sous-ensemble.
Les divisions aléatoires entraînent des fuites avec des données corrélées#
Les images 124 et 125 de la même séquence vidéo sont presque identiques. Si l’une se retrouve dans l’entraînement et l’autre dans la validation, le modèle est évalué sur des images qu’il a déjà pratiquement vues. Mesure cela sur le jeu d’exercice de Collecter des données représentatives de haute qualité, dont les noms de fichiers commencent par une clé de groupe caméra-jour :
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainChaque groupe caméra-jour de la validation apparaît aussi dans l’entraînement. Avec des images réelles, cela signifie que les images de validation partagent l’éclairage, l’arrière-plan et souvent les mêmes objets que les images d’entraînement : la mAP de validation est donc excellente, contrairement à celle de production.
Choisir l’unité de division#
Choisis le groupe qui correspond au niveau de généralisation requis en déploiement :
En cas de doute, divise les données selon l’unité la plus générale que tu peux te permettre : tu obtiendras ainsi le résultat le plus honnête. Les divisions aléatoires par image ne sont sûres que si chaque image est une capture indépendante, comme des photos de produits prises à plusieurs semaines d’intervalle.
Diviser les données par groupes dans le code#
Ce script attribue des groupes entiers aux sous-ensembles jusqu’à ce que chacun atteigne sa part de 70/15/15, écrit les listes de fichiers acceptées par un fichier YAML de données et indique la couverture des classes :
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingComment interpréter le résultat :
- Aucun groupe ne se retrouve dans plusieurs sous-ensembles, par construction. La fuite est donc éliminée.
- La validation contient 2 groupes et ne couvre pas 36 classes : il est donc impossible de mesurer leur AP. Avec 71 classes dans 128 images, aucune valeur de départ ne peut résoudre ce problème ; la vraie solution consiste à ajouter des groupes (davantage de caméras ou de jours), comme dans un jeu de données de production comptant plus de 1 500 images par classe.
- Il manque 5 classes dans l’entraînement, car elles apparaissent uniquement dans la validation ou le test. Le modèle ne pourra jamais les apprendre à partir de cette division.
La règle à suivre : si une classe est absente d’un sous-ensemble, ajoute ou déplace des groupes entiers qui la contiennent, jamais des images isolées, ce qui réintroduirait la fuite. Fais pointer les clés train, val et test du fichier YAML de données vers les trois fichiers .txt ; Écrire un fichier YAML de jeu de données explique le reste du fichier.
Équilibrer les classes entre les sous-ensembles#
Pour la classification, train_test_split(..., stratify=labels) de scikit-learn conserve les mêmes proportions de classes entre les sous-ensembles avec un seul argument. Les images de détection contiennent plusieurs classes à la fois : équilibre donc les données au niveau des groupes. Après group_split.py, compare le nombre d’éléments de chaque classe entre les sous-ensembles et échange des groupes entiers jusqu’à ce que chaque classe se situe à environ ±20 % de la part attendue.

Sur la plateforme Ultralytics, Redistribute Splits réattribue les images de manière aléatoire et Auto définit la répartition recommandée 80/20 entre entraînement et validation (documentation sur les divisions). Cette fonction supprime les images strictement identiques, mais ne connaît pas tes groupes : utilise-la donc pour des captures indépendantes et charge des sous-ensembles déjà divisés par groupes pour les vidéos ou les données issues de plusieurs caméras.
Suivre séparément deux jeux de validation#
Tu voudras souvent disposer de deux jeux de validation : une suite de régression stable et organisée, et un jeu représentatif de la production, qui évolue avec les nouvelles images collectées. Le fichier YAML de données accepte une liste de dossiers de validation, mais les regroupe en un seul jeu de validation avec un seul score :
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Pour afficher chaque score, conserve un fichier YAML de données par jeu de validation (mêmes train et names, mais val différent) et évalue les poids entraînés sur chacun d’eux :
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Une baisse sur le jeu organisé indique une régression ; une baisse sur le jeu de production indique un décalage de domaine.
Verrouiller le jeu de test#
L’erreur de répartition la plus coûteuse consiste à comparer dix variantes du modèle sur le jeu de test. Dès que le test a influencé une décision, le score final devient optimiste. Fais tous les réglages et compare les exécutions sur la validation, puis lance une seule fois le test d’acceptation sur le jeu de test, à la fin.
Chaque métrique que tu publies dépend de cette séparation. Mélanger de nouveau les données par la suite change tous les chiffres et rend les anciennes et les nouvelles exécutions incomparables. Conserve l’unité de séparation, la graine et les trois listes de fichiers avec le jeu de données.
Validation croisée à k plis pour les petits jeux de données#
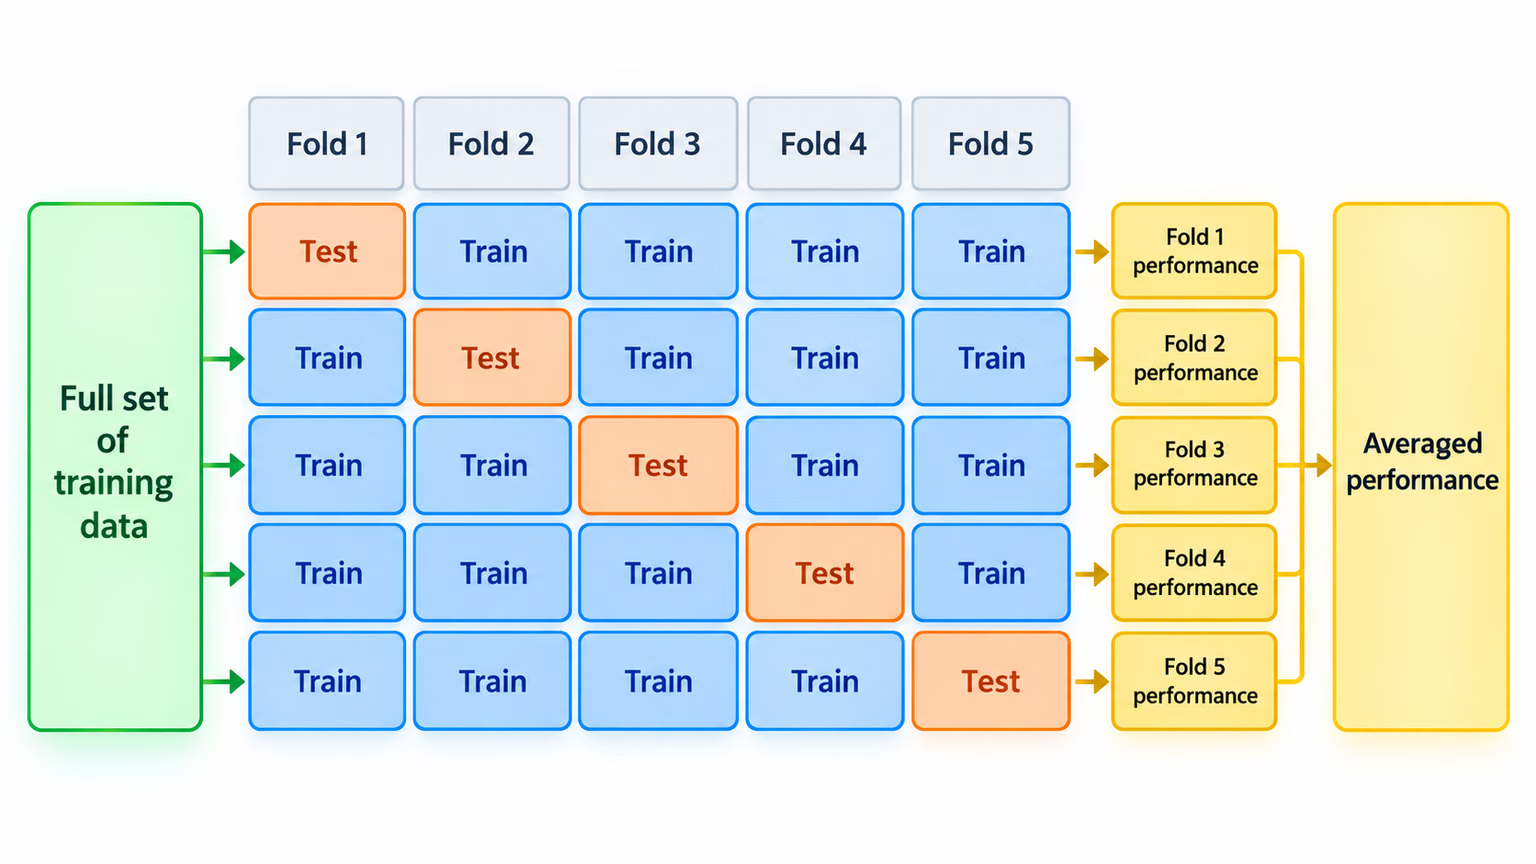
Lorsque le jeu de données est petit (moins de 500 images par classe environ) et qu’une seule division semble statistiquement fragile, la validation croisée à k plis entraîne k modèles sur des divisions tournantes et calcule la moyenne des résultats : k fois plus de calcul pour une estimation beaucoup plus stable. Construis les plis à partir de groupes de la même manière, sinon chaque pli présentera des fuites.
Afficher la solution
Pour des caméras fixes en entrepôt qui doivent rester opérationnelles les jours suivants, divise les données par groupe caméra-jour : cam2_2026-05-01. Après group_split.py, vérifie qu’aucun groupe ne se retrouve dans plusieurs sous-ensembles :
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneLa division d’exercice passe le contrôle des fuites, mais échoue au contrôle de couverture : 36 des 71 classes manquent dans la validation. La solution consiste à établir un plan de collecte, pas à redistribuer les données. Capture au moins deux jours de caméra supplémentaires pour la validation et le test, chacun couvrant les classes les plus importantes selon les spécifications, puis relance les deux scripts.