Savoir quand le jeu de données est prêt
Conditionne le premier entraînement à huit vérifications réussite/échec, automatise les trois qu’un script peut vérifier et identifie la correction requise pour chaque échec.
Chaque projet arrive au moment où l’équipe veut lancer l’entraînement. Parfois, le jeu de données est prêt ; parfois, il contient encore une fuite entre les découpages ou une classe insuffisamment annotée, ce qui fera perdre une semaine de calcul GPU et produira un chiffre auquel personne ne devrait se fier. Huit vérifications, chacune notée oui, non ou exception documentée, permettent de prendre cette décision objectivement plutôt qu’au gré de l’humeur.
Pratique
Les huit vérifications#
| # | Vérification | Critères de réussite | En cas d’échec, reprendre |
|---|---|---|---|
| 1 | Objectif clair | L’objectif, la tâche, les classes et un test d’acceptation sont consignés et validés par tous | Commencer par l’objectif métier |
| 2 | Classes définies | Chaque classe a une définition et un exemple ressemblant explicitement exclu | Objectif et guide d’annotation |
| 3 | Images représentatives | Chaque scénario de la spécification respecte son quota, avec des images provenant principalement de sources de production | Collecter des données de haute qualité et représentatives |
| 4 | Volume suffisant | ≥ 1 500 images et ≥ 10 000 instances par classe, ou exception documentée | Spécification et collecte |
| 5 | Annotations cohérentes | Guide rédigé, session de calibration effectuée, accord ≥ 90 % | Bonnes pratiques d’annotation |
| 6 | Contrôle qualité terminé | Script d’audit sans erreur, cas suspects examinés, notes de contrôle qualité rédigées | Contrôle qualité du jeu de données |
| 7 | Découpages sans fuite | Découpage par groupes, aucun groupe présent dans deux découpages, chaque classe présente dans chaque découpage | Découper correctement le jeu de données |
| 8 | Images d’arrière-plan | 0–10 % des images sont des images sans annotation | Spécification et collecte |
La liste de contrôle regroupe en une seule décision go/no-go les mêmes points que le guide de collecte et d’annotation des données aborde un par un.
Automatiser les vérifications quantifiables#
Les vérifications 4, 7 et 8 reposent sur des calculs ; un script les évalue donc de la même façon à chaque fois. Celui-ci lit le jeu de pratique et les listes de découpages générés par group_split.py dans la leçon précédente :
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background imagesLe découpage par groupes a corrigé la fuite, mais le jeu de pratique est loin d’être prêt : sa classe la plus faible (30, skis) ne compte qu’une seule instance annotée, et l’évaluation ne peut pas mesurer la moitié des classes. C’est le verdict attendu pour 128 images de démonstration, et précisément celui que cette vérification doit fournir avant une semaine d’entraînement.
Le script couvre ce qui peut être compté. Les points 1, 2, 3, 5 et 6 nécessitent une intervention humaine : un objectif convenu, des définitions écrites, une couverture conforme au cahier des charges, un score d’accord mesuré et des notes de contrôle qualité. Évalue-les manuellement, avec une ligne de preuve pour chaque point.
Décider : entraîner, livrer malgré une lacune ou corriger#
Lorsqu’une vérification échoue, l’étape suivante tentante consiste presque toujours à faire autre chose que corriger les données :
| Raccourci tentant | Pourquoi ça ne marche pas |
|---|---|
| « Essaie un modèle plus grand. » | Un modèle plus grand apprend le bruit des annotations tout aussi fidèlement. |
| « Règle le taux d’apprentissage. » | Aucun réglage de l’optimiseur ne peut ajouter une classe ou un scénario manquant. |
| « Entraîne le modèle pendant plus d’époques. » | Avec des données trop limitées, davantage d’époques accélèrent le surapprentissage. |
| « Ajoute plus d’augmentation. » | L’augmentation ne peut pas créer des scénarios absents des données. |
Trois situations où le jeu de données est presque prêt#
| Situation | Vérification en échec | À quoi ça ressemble | Correctif |
|---|---|---|---|
| Volume sans diversité | 3 | 5 000 images, une seule caméra, aucun cas limite | Collecte des images provenant de davantage de caméras, de sites et de moments avant l’entraînement |
| Diversité sans cohérence | 5 | Les annotateurs ne s’accordent pas sur les limites des boîtes ni sur l’occlusion | Termine le guide, effectue la calibration et réannote l’échantillon concerné |
| Fuite discrète | 7 | Découpage aléatoire par image sur des images vidéo | Refais la répartition par clip, caméra ou jour ; attends-toi à une baisse du mAP de validation, car cette baisse reflète la réalité |
Déploie en connaissant les lacunes#
Souvent, le bon choix consiste à créer un premier modèle ciblé avant que tous les contrôles soient au vert : un pilote, un prototype ou une v1 sur un sous-ensemble de caméras. Un modèle en production révèle plus vite les vrais problèmes que le peaufinage des données dans le noir. Si tu déploies avec une lacune, consigne trois choses :
- Le contrôle qui a échoué.
- L'impact attendu, par exemple « aucune donnée de nuit ; attends-toi à un rappel plus faible après la tombée de la nuit ».
- Le plan de collecte qui permettra de combler la lacune pendant l'exécution de la v1.
« Volume : exception » n’apprend rien à la personne suivante. « Volume : pallet à 700 instances, rappel des palettes probablement plus faible dans les zones encombrées ; 2 000 étiquettes supplémentaires d’ici juin » correspond à un risque maîtrisé. Chaque exception doit indiquer son impact prévu sur le test d’acceptation.
Relance les contrôles avant chaque nouvel entraînement#
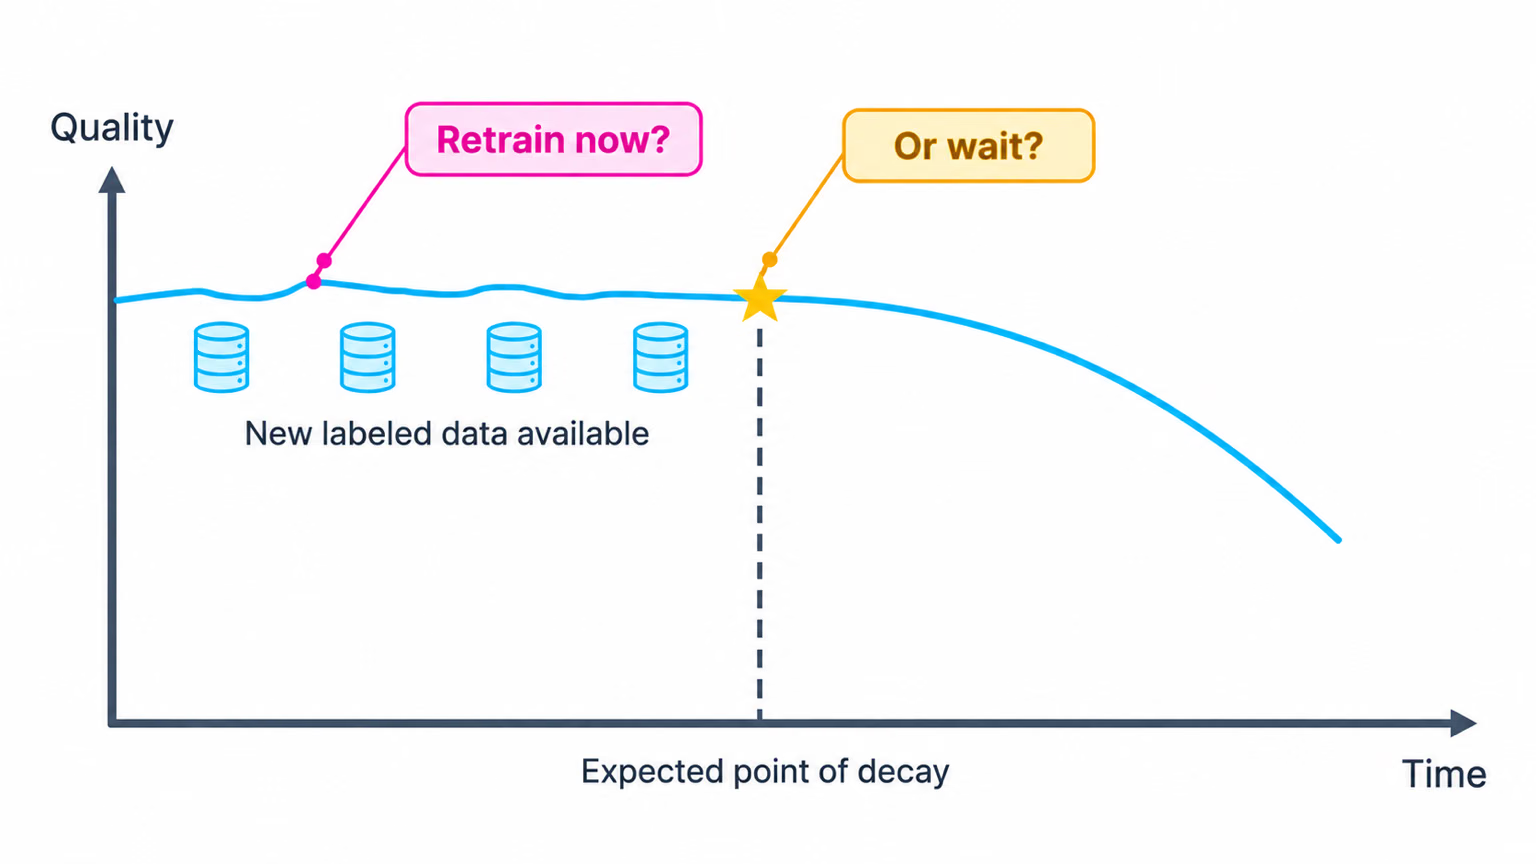
Un jeu de données prêt pour la v1 n'est pas automatiquement prêt pour la v3. De nouvelles classes, de nouvelles sources et de nouveaux annotateurs peuvent chacun faire échouer un contrôle qui réussissait auparavant, tandis que les données de production dérivent à mesure que les nouvelles annotations s'accumulent. Relance readiness.py et réévalue les contrôles manuels avant chaque nouvel entraînement ; cela prend quelques minutes, et sauter cette étape peut te coûter une semaine d'entraînement sur un jeu de données défectueux.
Afficher la solution
Une liste de contrôle notée pour le jeu d'exercice :
| # | Vérification | Note | Preuve |
|---|---|---|---|
| 1 | Objectif clair | oui | objective.md et acceptance_test.py de la leçon 1 |
| 2 | Classes définies | non | Les 80 noms de COCO n'ont ni définitions écrites ni exemples de ressemblances à exclure |
| 3 | Images représentatives | non | coverage.py : cam2–cam4 sous le quota |
| 4 | Volume suffisant | non | readiness.py : la classe la moins représentée ne compte qu'une image |
| 5 | Annotations cohérentes | non | Accord de 47 % lors de la phase de calibration |
| 6 | Contrôle qualité terminé | partiel | Audit effectué ; les cas suspects dans 000000000438.jpg restent à traiter |
| 7 | Répartitions sans fuite | non | Aucun groupe partagé, mais le jeu de validation ne contient que 35 des 71 classes |
| 8 | Images d'arrière-plan | oui | 1.6% |
Décision : corriger d'abord. Par ordre de risque pour le test d'acceptation : (1) réduire la liste de classes aux classes requises par l'objectif, ce qui allège d'un coup les contrôles 2, 4 et 7 ; (2) collecter davantage de groupes pour ces classes ; (3) compléter la règle du guide concernant les personnes éloignées et réannoter. Un jeu de démonstration échoue à ce contrôle, et c'est normal.