Premier ajustement fin et boucle d'itération
Ajuste finement les poids YOLO26 préentraînés avec les paramètres par défaut, classe les classes selon leur AP, avec le nombre d'objets manqués et confondus, puis transforme la classe la plus faible en prochaine correction du jeu de données.
L'exécution pratique de cette leçon obtient un mAP50 de 0,66, ce qui semble indiquer un problème de taux d'apprentissage. Pourtant, un tableau par classe montre autre chose : cup compte 14 objets annotés dans le jeu de validation, et le modèle n'en trouve aucun. C'est un problème de données, qu'aucun hyperparamètre n'aurait résolu. Considère la première exécution comme un diagnostic qui t'indique quelle classe corriger ensuite.
Pratique
Partir de poids préentraînés#
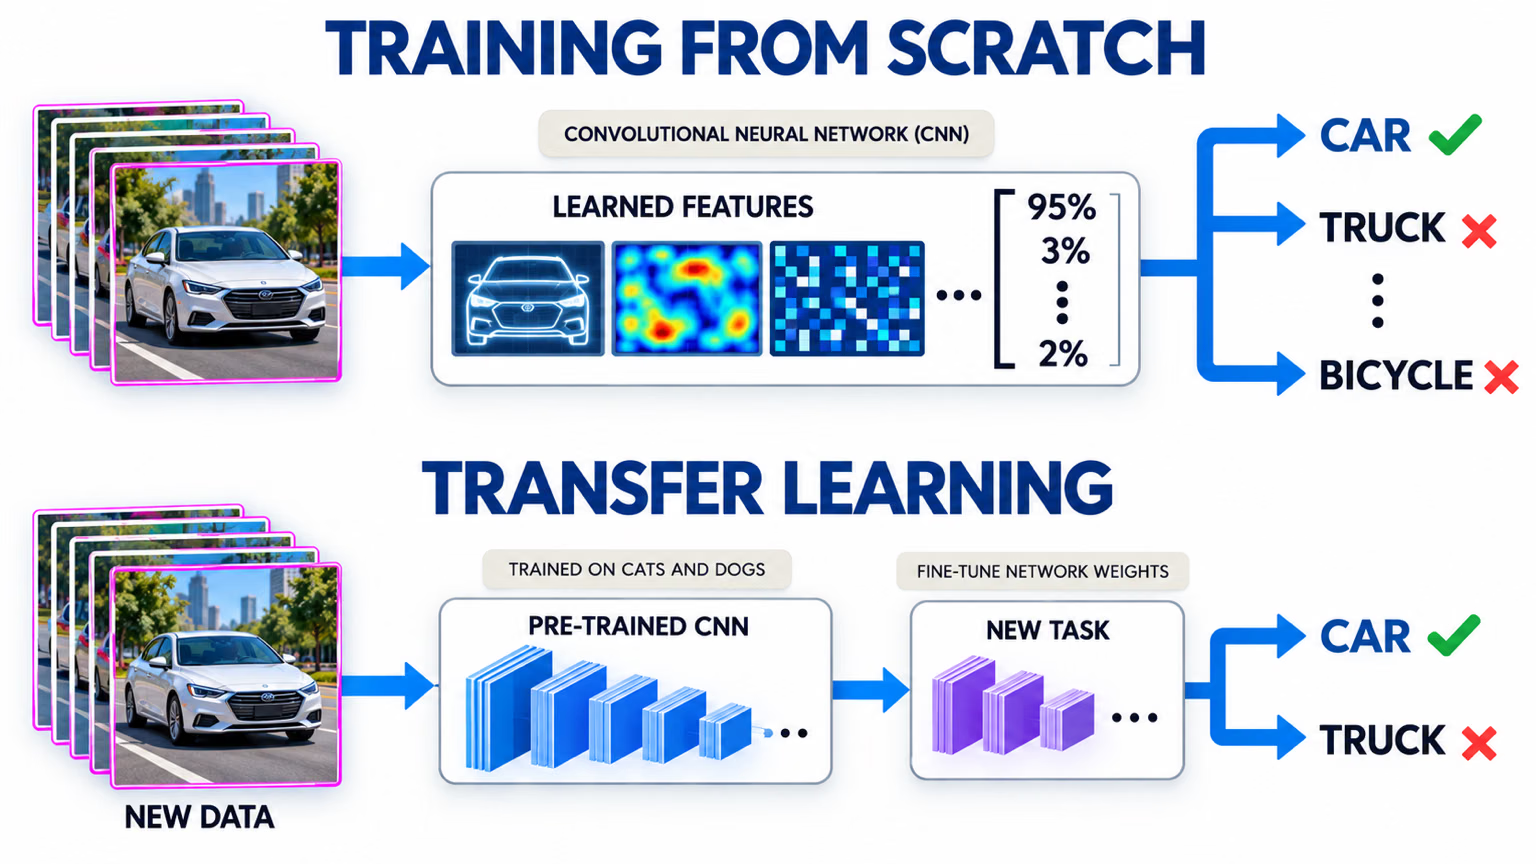
L'ajustement fin part de poids qui reconnaissent déjà les contours, les textures et les formes ; il converge donc plus vite et nécessite beaucoup moins de données qu'un entraînement à partir de poids aléatoires. Choisis le point de contrôle YOLO26 adapté à ta tâche :
| Tâche | Point de contrôle préentraîné | Préentraîné sur |
|---|---|---|
| Détection | yolo26n.pt | COCO |
| Segmentation | yolo26n-seg.pt | COCO |
| Sémantique | yolo26n-sem.pt | Cityscapes |
| Pose | yolo26n-pose.pt | Points clés COCO |
| OBB | yolo26n-obb.pt | DOTAv1 |
| Classification | yolo26n-cls.pt | ImageNet |
| Profondeur | yolo26n-depth.pt | Un vaste ensemble de données de profondeur en intérieur et en extérieur |
Le backbone et le neck sont transférés tels quels ; la tête de tâche est partiellement réinitialisée pour correspondre au nombre de classes. L'entraînement à partir de zéro n'est avantageux qu'avec de très grands jeux de données dans des domaines très inhabituels. Commence avec le modèle nano (n) pour obtenir rapidement une référence, puis passe à des tailles supérieures seulement lorsque les itérations sur les données ne produisent plus de progrès. Le guide d'ajustement fin explique ce qui se passe en interne.
Exécuter le modèle de référence#
Entraîne avec les paramètres par défaut ; le premier entraînement sert à établir une référence, pas à battre un record. Il s'appuie sur la répartition du jeu d'exercice présentée dans Répartir correctement le jeu de données, en commençant par écrire son fichier YAML de données :
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # le jeu d'exercice conserve les noms de classes de COCO
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # préentraîné sur COCO ; utilise le point de contrôle correspondant à ta tâche
model.train(data="practice.yaml", epochs=3, imgsz=320)  # une vraie exécution : epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486Le dossier d'exécution (runs/detect/train/) contient maintenant weights/best.pt. Seuls trois arguments méritent d'être envisagés lors du premier entraînement :
| Argument | Par défaut | Quand modifier ce paramètre |
|---|---|---|
epochs | 100 | Moins pour les très petits jeux de données ; 200–300 pour les très grands |
imgsz | 640 | 1024 ou 1280 si de nombreux objets sont petits dans l'image |
batch | 16 | -1 pour le réglage automatique de la taille des lots ; diminue cette valeur en cas d'erreur de mémoire insuffisante |
Entraîner ton premier modèle détaille l'appel d'entraînement et son journal en direct.
Classer les classes et analyser les objets manqués#
Le mAP global masque l'emplacement du problème. Classe les classes selon leur AP50-95 et utilise la matrice de confusion pour répartir les erreurs de chaque classe entre les objets que le modèle n'a pas détectés du tout et ceux qu'il a attribués à une autre classe :
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classChaque type d'erreur indique une correction différente du jeu de données :
- Trop peu d'instances dans le jeu de validation (
fork,handbag,sink, une instance chacune) : l'AP n'est que du bruit. N'interviens pas sur une classe tant que le jeu de validation ne contient pas au moins quelques dizaines de ses instances ; collecte d'abord davantage de groupes de validation. - Objets manqués (
car: 4 sur 4,cup: 10 sur 14) : le modèle ne détecte aucun objet. Vérifie la couverture de ce scénario dans le jeu d'entraînement et recherche les annotations manquantes avecsuspect_labels.py. - Attribués à une autre classe (
cup: 4 sur 14) : les définitions des classes se chevauchent. Ouvre ces images, précise les définitions et indique dans le guide l'élément ressemblant.
cup est le constat exploitable ici : 14 instances annotées, et aucune détectée.
Lire le dossier d'exécution comme un retour sur les données#

Chaque entraînement génère ces fichiers, et la plateforme Ultralytics affiche les mêmes courbes en direct pendant l'entraînement dans le cloud :
| Fichier | Ce qu'il révèle sur les données |
|---|---|
confusion_matrix_normalized.png | Les classes confondues entre elles ou dont les instances sont manquées et considérées comme de l'arrière-plan |
BoxPR_curve.png | Précision-rappel par classe ; une courbe basse indique une classe faible |
val_batch0_pred.jpg | Prédictions sur de vraies images de validation ; repère les erreurs systématiques |
labels.jpg | Nombre de classes et tailles de boîtes utilisés pour l'entraînement du modèle |
results.png | Courbes de perte et de métriques ; une perte de validation qui augmente tandis que la perte d'entraînement baisse signale le surapprentissage |
Valider et diagnostiquer explique chaque graphique ; ici, la question est toujours de savoir quelles données manquent.
La boucle axée sur les données#
Une itération type : choisis la classe la plus faible qui compte suffisamment d'instances dans le jeu de validation, audite environ 50 images qui la contiennent, corrige les données, réentraîne avec les mêmes paramètres et la même répartition, puis compare l'AP par classe. Passe ensuite à la classe la plus faible suivante.
Si tu ajoutes 300 images et augmentes imgsz lors du même réentraînement, tu ne peux pas savoir quel changement a modifié le score. Garde les paramètres et la séparation identiques pendant les itérations sur les données, afin que chaque comparaison isole un seul changement de données.
Quand régler les hyperparamètres#
Après deux ou trois itérations sur les données, lorsque les classes faibles restantes ne s'expliquent plus par la couverture, les annotations ou les définitions, le réglage peut permettre de gagner les derniers points. Le guide d'ajustement fin aborde le gel de couches, les taux d'apprentissage et le choix de l'optimiseur. Mais si tu ajustes les paramètres avant que les données soient au point, tu passes des semaines à optimiser un modèle entraîné sur un jeu de données inadéquat.
Une fois qu'un modèle réussit acceptance_test.py sur le jeu de test verrouillé, YOLO d'Ultralytics en production traite de l'exportation et du déploiement, tandis que Surveiller l'état et la précision et Automatiser la boucle de réentraînement, dans Développer avec la plateforme Ultralytics, abordent la boucle de réentraînement.
Afficher la solution
À l’issue de l’essai, cup est la classe à traiter : 14 instances annotées dans val, 0 détectée, 10 manquées, 4 attribuées à une autre classe. Voici un plan chiffré :
| Constat | Action sur le jeu de données | Volume |
|---|---|---|
| 10 des 14 gobelets manqués | Vérifie la couverture de train : compte les images train avec des gobelets par caméra et par jour ; collecte des images de gobelets dans les groupes qui n’en contiennent aucun. | 40 nouvelles images avec des gobelets, réparties sur 4 jours de prise de vue |
| 4 des 14 attribués à une autre classe | Ouvre-les dans val_batch0_pred.jpg et dans la matrice de confusion ; s’ils sont attribués à wine glass ou à bowl, ajoute les deux classes similaires à la définition de cup. | Réannote environ 30 images train selon la nouvelle règle. |
| Classes à une instance | N’interviens pas encore ; ajoute des groupes val qui en contiennent. | Prochaine collecte |
Réentraîne ensuite avec epochs, imgsz et la même partition, relance rank_classes.py, puis compare l’AP de cup avant et après. Si elle augmente, les données étaient le goulot d’étranglement ; si ce n’est pas le cas, vérifie les 50 images suivantes avant de toucher à un hyperparamètre.