Commencer par l'objectif métier
Transforme un objectif métier en une tâche de vision, en classes définies et en test d'acceptation exécutable sous forme de code, avant même de collecter la moindre image.
Une équipe d'entrepôt photographie tout pendant un mois, puis apprend que la responsable de la sécurité ne s'intéresse qu'aux personnes à proximité des chariots élévateurs en mouvement et que la moitié des annotations doit être refaite. Un objectif d'une page, convenu avant la première photo, évite cela. Il prend un après-midi à rédiger et détermine tous les choix ultérieurs de ce cours : quoi collecter, quoi annoter et quand le modèle est assez bon pour être déployé.
Pratique
L'objectif d'une page#

Cinq lignes répondent aux questions dont dépend chaque étape ultérieure. Le guide sur la définition des objectifs du projet traite des mêmes sujets plus en détail. Voici un exemple rempli pour un entrepôt, qui sert de base à ce cours :
| Ligne | Question à laquelle elle répond | Exemple d'entrepôt |
|---|---|---|
| Objectif métier | Qu'est-ce qui change pour l'entreprise, et pour quand ? | Réduire de 30 % les incidents évités de justesse aux portes de quai en six mois. |
| Tâche de vision | Que renvoie le modèle ? | Détection d'objets : des boîtes autour des chariots élévateurs et des personnes. |
| Classes | Qu'est-ce qui reçoit exactement une annotation ? | forklift, person, pallet ; tout le reste est de l'arrière-plan. |
| Test d'acceptation | Quel chiffre signifie « prêt à déployer » ? | Rappel sur person ≥ 0,95 avec une précision ≥ 0,85 sur 500 images provenant de caméras non utilisées pour l'entraînement. |
| Hors périmètre | Que ne promettra pas la v1 ? | Quais plongés dans l'obscurité, personnes entièrement cachées derrière des rayonnages, transpalettes manuels. |
Affiche la page à un endroit où toute l'équipe peut la voir. Si une partie prenante conteste une ligne plus tard, modifie d'abord la page, puis le jeu de données.
Choisir la tâche la plus simple qui répond à la question#
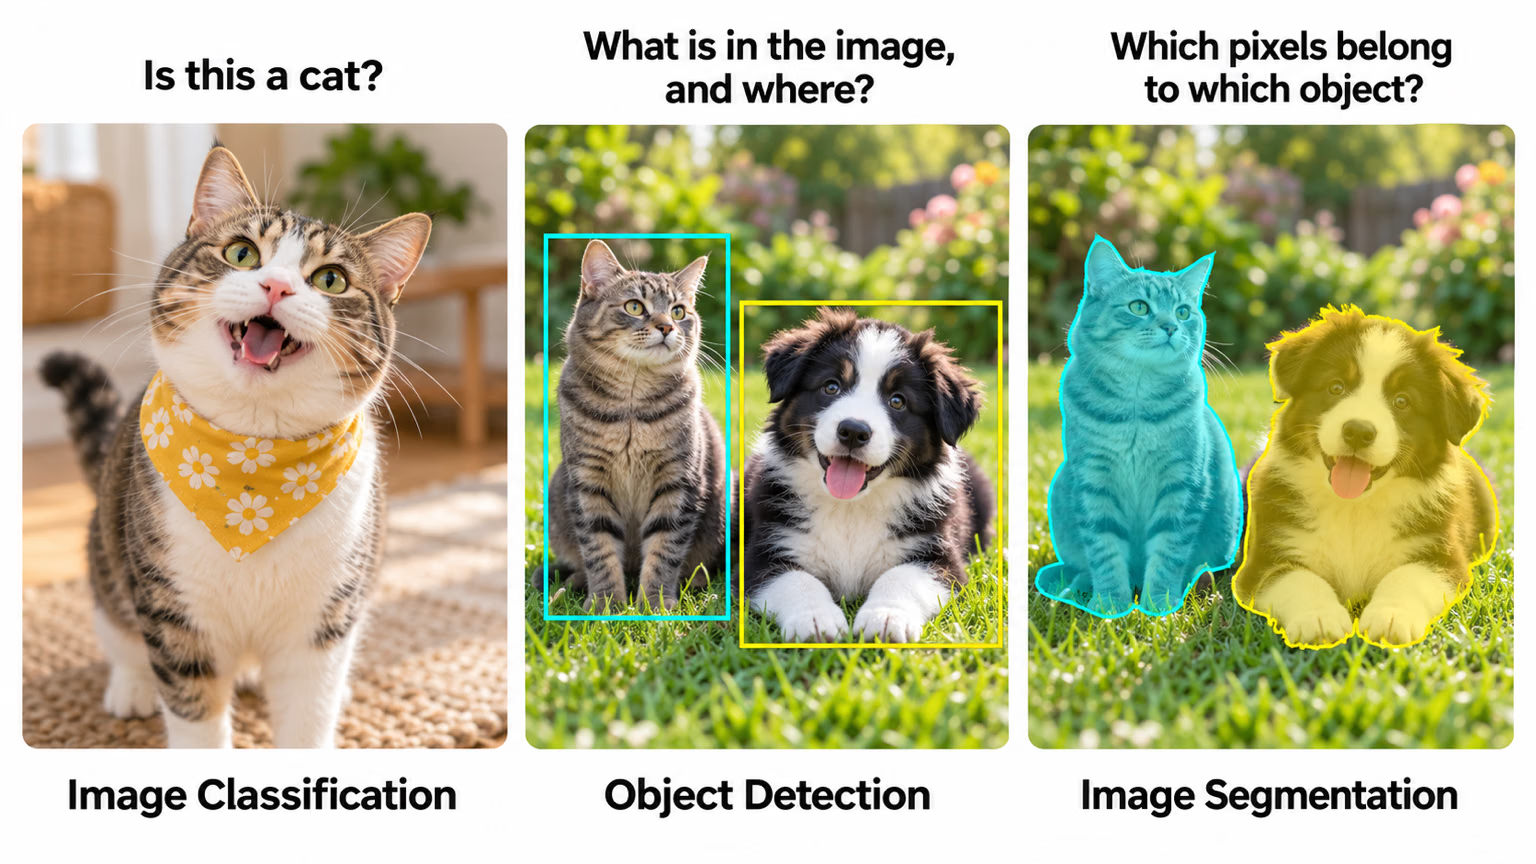
La tâche détermine ce que les annotateurs dessinent, et cela détermine l'essentiel du budget d'annotation. Suis cet arbre de décision et arrête-toi à la première tâche qui répond à la question métier :
Ultralytics YOLO prend en charge sept tâches. Pour planifier un jeu de données, ce qui compte, c'est le coût d'annotation de chacune ; Fondamentaux de la vision par ordinateur les compare en détail dans sa leçon sur les tâches de vision.
| Tâche | Production des annotateurs | Effort d'annotation | À choisir lorsque |
|---|---|---|---|
| Classification | Une étiquette par image | Le plus faible | Une réponse par image suffit |
| Détection | Classe + boîte alignée sur les axes par objet | Faible | Tu dois compter ou localiser des objets |
| OBB | Classe + boîte orientée par objet | Moyen | Les objets sont longs, fins ou vus d'en haut |
| Pose | Classe + points clés nommés par objet | Élevé | La position des articulations ou des parties compte |
| Segmentation d’instance | Classe + polygone par objet | Élevé | Le contour de chaque objet compte |
| Segmentation sémantique | Une classe pour chaque pixel | Le plus élevé | Tu as besoin de régions, pas d’objets dénombrables |
| Estimation de profondeur | Rien n’est dessiné : une carte de profondeur par image, généralement obtenue à l’aide d’un capteur de profondeur | Dépend du matériel de capture | Tu as besoin de la distance de chaque pixel |
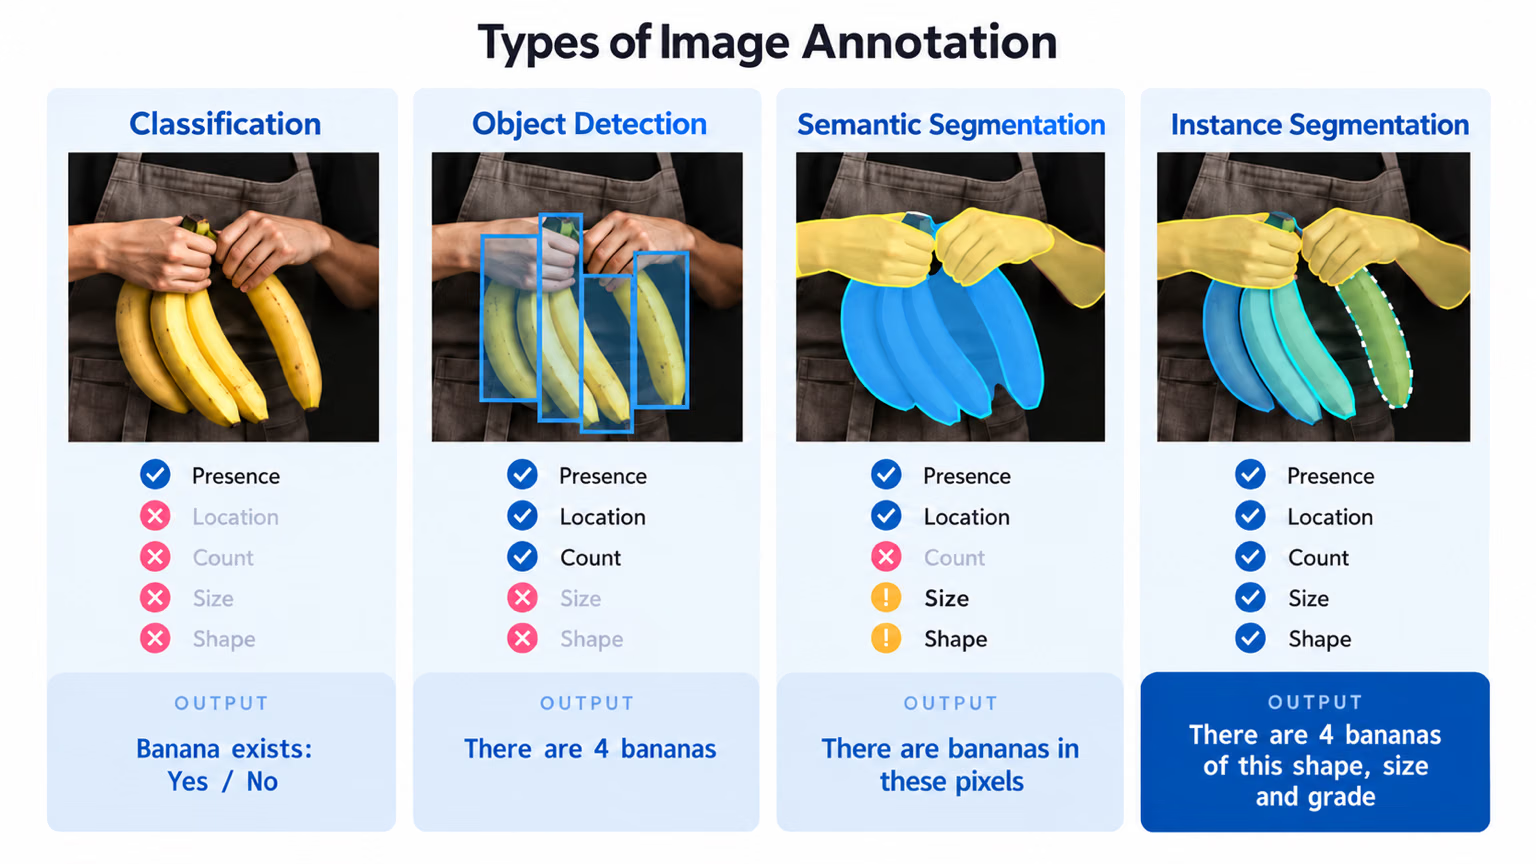
Lis le panneau des bananes comme une liste de prix : la détection indique déjà la présence, l’emplacement et le nombre, et seuls les deux panneaux de segmentation ajoutent la taille et la forme, à un coût d’annotation bien plus élevé. Si l’entreprise veut seulement savoir « combien de bananes », la détection est la solution et les polygones sont une dépense inutile.
Les équipes se tournent souvent vers la segmentation parce qu’elle semble plus précise, puis épuisent leur budget d’annotation avant que le jeu de données couvre les équipes de nuit, la pluie ou le deuxième site. Les polygones coûtent plusieurs fois plus cher par objet que les boîtes. Choisis la segmentation uniquement si un critère de l’objectif exige le contour lui-même, par exemple pour mesurer une surface ou découper un masque.
Définis des classes qu’un annotateur peut appliquer#
Une classe n’est utile que si deux annotateurs attribuent la même étiquette au même objet. Définis chaque classe en une phrase qui précise un élément ressemblant qu’elle exclut :
forklift: un chariot élévateur motorisé, fourches et mât compris. Exclut les transpalettes manuels.person: toute personne, y compris partiellement visible, assise ou dans la cabine d’un véhicule. Exclut les reflets et les affiches.pallet: une palette d’expédition en bois ou en plastique, chargée ou vide. Exclut les caisses empilées sans palette à leur base.
Choisis ensuite délibérément le niveau de granularité. Les classes générales (« véhicule ») coûtent moins cher et convergent plus vite ; les classes détaillées (« berline », « pick-up ») sont plus utiles en aval, mais plus difficiles à appliquer de façon cohérente. Commence par définir les besoins de l’entreprise. Il est possible de regrouper plus tard des étiquettes détaillées en classes générales avec une seule ligne de code, mais il est impossible de subdiviser des classes générales sans refaire l’annotation.
« Tout ce qui semble dangereux » ou « les trucs qui bloquent l’allée » ne constitue pas une classe. Cela demande à chaque annotateur de porter un jugement, et un modèle entraîné sur des jugements incohérents apprend cette incohérence. Reformule une classe vague jusqu’à ce qu’un nouvel annotateur puisse l’appliquer à partir de la seule définition, ou transforme-la en règle appliquée après la détection (par exemple, « tout pallet à l’intérieur du polygone de l’allée »).
Transforme la métrique en un test d’acceptation que tu peux exécuter#
Choisis la métrique qui correspond au coût d’une erreur :
- Un oubli coûte cher (sécurité, défauts) : fixe un seuil de rappel pour cette classe.
- Une fausse alerte coûte cher (rejet automatique de pièces, alerte du personnel) : fixe un seuil de précision.
- Toutes les classes comptent autant (comptage, inventaire) : fixe un seuil d’AP par classe pour qu’aucune classe ne se dissimule derrière la moyenne.
Le guide des métriques de performance YOLO explique chacune d’elles. Écris ensuite le test sous forme de code pour mettre fin aux débats sur la question « est-ce assez bon ? ». Ce script fonctionne dès maintenant avec un modèle préentraîné sur le jeu de démonstration COCO8, puis plus tard avec ton propre checkpoint et ton jeu de données de validation indépendant :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # later: your fine-tuned runs/detect/train/weights/best.pt
metrics = model.val(data="coco8.yaml", classes=[0], verbose=False)  # 0 = person; later: your holdout YAML

precision, recall = metrics.box.mp, metrics.box.mr
print(f"person: precision={precision:.2f} recall={recall:.2f}")
print("PASS" if recall >= 0.95 and precision >= 0.85 else "FAIL: below the acceptance test")
all 4 10 0.939 0.8 0.848 0.387
person: precision=0.94 recall=0.80
FAIL: below the acceptance testCe que chaque ligne t’indique :
classes=[0]évalue uniquementperson, afin que les autres classes ne puissent pas gonfler le résultat. Utilise l’identifiant de ta propre classe de sécurité.- La ligne du validateur indique 4 images contenant 10 personnes annotées.
mpetmrcorrespondent à la précision et au rappel au seuil de confiance qui les équilibre le mieux (F1 maximal). - Un modèle COCO préentraîné détecte 8 des 10 personnes, soit un rappel de 0,80 : le résultat est précis, mais pas assez sûr. Cet échec montre que le test fait son travail. Dans ce cours, un échec renvoie aux données, pas aux hyperparamètres.
Un test constitué à partir des mêmes caméras et des mêmes jours que l’entraînement mesure la mémoire, pas la capacité à être déployé. Indique le jeu de mise à l’écart dans l’objectif (« caméras non utilisées pour l’entraînement », « les deux dernières semaines d’images ») et constitue-le avec Répartir correctement le jeu de données.
Note ce que la v1 ne fera pas#
Aucun modèle n’est parfait. Précise donc à l’avance les erreurs acceptables : les conditions que tu ne couvriras pas (brouillard épais, obscurité totale), les éléments ressemblants qu’il est acceptable de confondre et les classes rares reportées à la v2. Cette ligne évite qu’un modèle qui atteint son objectif soit jugé selon un seuil de 100 % jamais énoncé, et indique à l’équipe de collecte où ne pas investir ses efforts pour l’instant.
Afficher la solution
Voici un objectif concret pour un autre projet : une chaîne d’épiceries qui détecte les emplacements vides en rayon.
| Ligne | Réponse |
|---|---|
| Objectif métier | Réduire de 25 % les minutes de rupture de stock sur les 200 produits les plus vendus en un trimestre. |
| Tâche de vision | Détection. Le magasin a besoin de l’emplacement de chaque espace vide, pas de son contour : les boîtes sont donc préférables aux polygones. |
| Classes | gap : un emplacement vide en rayon d’au moins la largeur d’un produit ; exclut les emplacements cachés par un client ou un chariot. price_tag : une étiquette de bord de rayon ; exclut les autocollants promotionnels. |
| Test d'acceptation | Rappel de gap ≥ 0.90 avec une précision ≥ 0.80 sur 400 images provenant de 5 magasins non utilisés pour l’entraînement. |
| Hors périmètre | Portes de congélateur avec reflets, présentoirs de tête de gondole, rayon des fruits et légumes. |
Le rappel passe en premier, car un espace vide non détecté entraîne une vente perdue, tandis qu’une fausse alerte coûte une courte marche à un membre du personnel. acceptance_test.py ne change qu’à trois endroits : data="holdout_stores.yaml" (les cinq magasins inconnus), classes=[0] (0 devient gap) et les seuils recall >= 0.90 and precision >= 0.80.