Valider et diagnostiquer
Valide best.pt par rapport à une valeur de référence, lis la matrice de confusion, les valeurs par classe et les images de prédiction, puis transforme ces résultats en une liste précise de corrections.
Un seul chiffre de mAP t’indique dans quelle mesure le modèle se trompe, pas sur quoi. Les petits objets manqués, les confusions entre deux classes et les boîtes trop lâches diminuent tous le mAP, et chacun de ces problèmes nécessite une correction différente. Si tu te trompes de diagnostic, tu risques de passer une semaine à collecter les mauvaises données.
Dans cette leçon, tu vas lancer le mode Val sur best.pt, le comparer à la valeur de référence et lire la matrice de confusion et les images de prédiction jusqu’à pouvoir rédiger la liste des corrections pour la prochaine série. Le guide des métriques de performance est son complément détaillé.
Pratique
Exemple détaillé : valider best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Sortie réelle de val.py :
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
Les graphiques sont placés dans un nouveau dossier runs/detect/val (puis val-2, etc.). Mets les valeurs à côté de la référence :
| Modèle | mAP50 | mAP50-95 |
|---|---|---|
yolo26n.pt préentraîné (sans classe pilule) | 0.001 | 0.0002 |
pills_v1 (10 époques, imgsz 320, CPU) | 0.977 | 0.659 |
Ce que disent les chiffres :
- Précision 0.970, rappel 0.957 : l’équilibre est bon. Peu de fausses alertes, peu d’objets manqués.
- mAP50 0.977 : avec une exigence de chevauchement peu stricte, le modèle détecte presque toutes les pilules.
- mAP50-95 0.659 : avec un chevauchement strict, beaucoup de boîtes ne sont pas assez ajustées. Un écart aussi important pointe vers la localisation — davantage d’époques, un
imgszplus grand ou des annotations plus précises — plutôt que vers un manque de données.
Pour comprendre les compromis entre précision, rappel et mAP, consulte Lire honnêtement les métriques de détection.
Savoir quel fichier répond à quelle question#
| Question | Fichier |
|---|---|
| Quelles classes sont confondues et lesquelles sont manquées ? | confusion_matrix_normalized.png |
| Comment chaque classe échange-t-elle de la précision contre du rappel ? | BoxPR_curve.png |
| Quel seuil de confiance déployer ? | BoxF1_curve.png : son pic constitue un bon point de départ pour conf |
| À quoi ressemblent les échecs ? | val_batch0_labels.jpg par rapport à val_batch0_pred.jpg |
| Le modèle est-il en surapprentissage ? | results.png dans le dossier d’entraînement |
Lire la matrice de confusion#
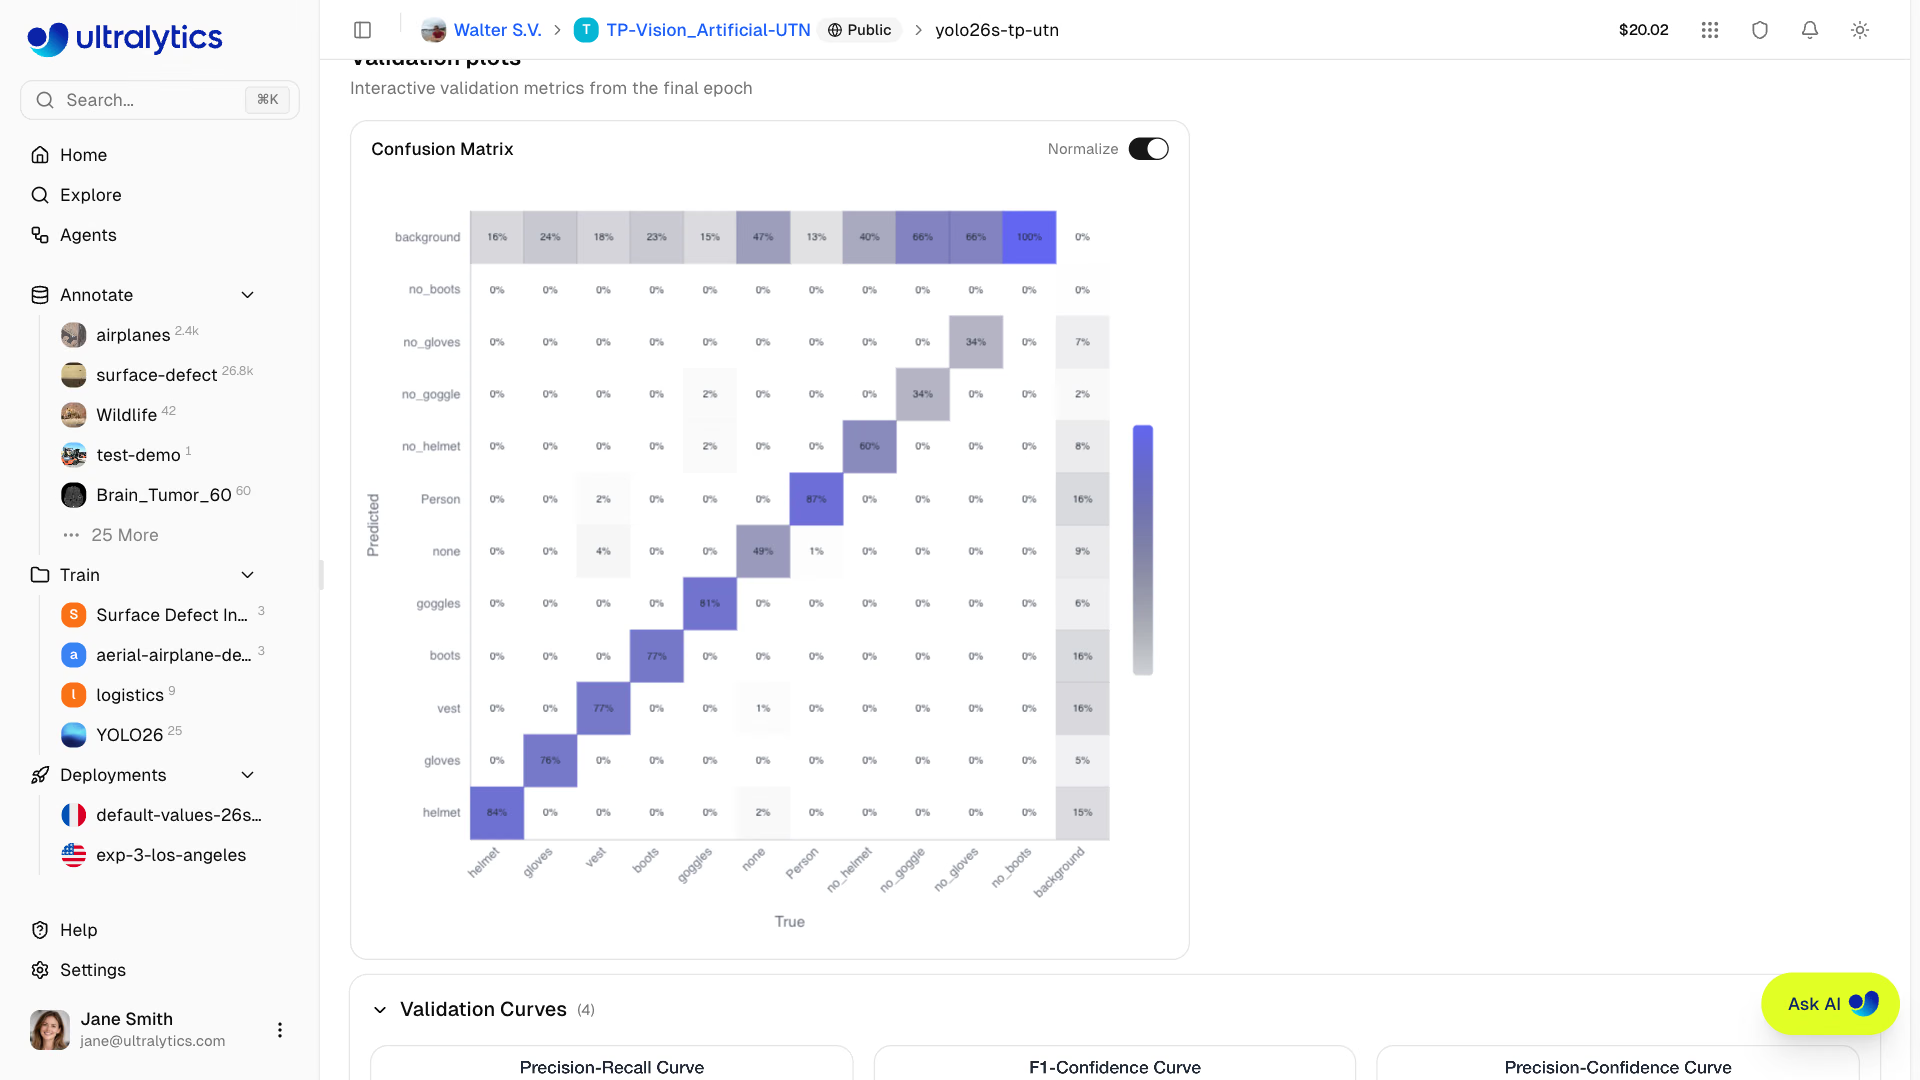
La matrice de confusion est l’outil de diagnostic le plus utile. Dans les graphiques Ultralytics, les colonnes représentent la classe réelle et les lignes la classe prédite, avec une ligne et une colonne background supplémentaires. La version normalisée divise chaque colonne par son total : chaque colonne indique donc où sont passés les objets de cette classe. Pills ne compte qu’une seule classe ; entraînons-nous donc sur cet exemple d’entrepôt à trois classes (chiffres illustratifs) :
| Prédites ↓ / Réelles → | chariot élévateur | personne | palette | arrière-plan |
|---|---|---|---|---|
| chariot élévateur | 0.78 | 0.03 | 0.18 | 0.45 |
| personne | 0.04 | 0.91 | 0.00 | 0.20 |
| palette | 0.10 | 0.00 | 0.65 | 0.35 |
| arrière-plan | 0.08 | 0.06 | 0.17 | — |
- Diagonale : proportion de chaque classe correctement détectée. La palette, à 0.65, est la classe la moins performante.
- Hors diagonale : confusions. 18 % des palettes réelles ont été prédites comme des chariots élévateurs, et 10 % des chariots élévateurs comme des palettes.
- Ligne d’arrière-plan : objets manqués. 17 % des palettes n’ont pas été détectées du tout.
- Colonne d’arrière-plan : faux positifs, c’est-à-dire des boîtes tracées sur des zones vides. Parmi ceux-ci, 45 % ont été classés comme des chariots élévateurs.
Chaque type de cellule correspond à une correction :
| Situation | Correctif |
|---|---|
| Deux classes se confondent | Ajoute des exemples qui les distinguent : des chariots élévateurs transportant des palettes, des palettes empilées à côté de chariots élévateurs. |
| Ligne d’arrière-plan élevée (objets manqués) | Davantage d’exemples de cette classe, dans les conditions où elle est manquée |
| Colonne d’arrière-plan élevée (fausses alertes) | Des images d’arrière-plan des scènes qui déclenchent ces alertes, comme des allées vides |
Lire les chiffres par classe#
Avec plusieurs classes, le journal de validation affiche une ligne par classe, et metrics.box.maps contient les mAP50-95 par classe pour le code. Continuons avec l’exemple de l’entrepôt :
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet est bien inférieur aux autres, et il ne compte que 7 instances dans l’ensemble de validation. Le modèle est peut-être mauvais pour détecter les palettes, ou les données de validation sont peut-être trop peu nombreuses pour le savoir. Dans les deux cas, la même étape s’impose : collecter davantage de palettes, pour l’entraînement et la validation.
Examiner les échecs#
Ouvre val_batch0_labels.jpg et val_batch0_pred.jpg côte à côte. Les différences montrent les échecs sous forme d’images, et les motifs qui s’en dégagent permettent de poser le diagnostic : objets manqués au bord de l’image, petits objets, une condition d’éclairage particulière, un sosie difficile à distinguer. Ces motifs liés au jeu de données sont presque toujours plus utiles que le réglage des hyperparamètres.
Dans les images de validation du modèle de pilules, les pilules clairement visibles obtiennent un score proche de 1.0. Les boîtes à faible confiance, autour de 0.3–0.5, se concentrent sur les pilules partiellement cachées sous une autre plaquette et sur celles coupées par le bord de l’image. Ce n’est pas un problème à corriger en ajustant conf ; c’est une question de politique d’annotation. Une pilule à moitié cachée doit-elle être comptée ? Décide, consigne la règle et annote chaque image de la même façon.
Ouvre ensuite results.png. Les pertes d’entraînement et de validation doivent diminuer ensemble. Si la perte d’entraînement continue de diminuer alors que la perte de validation augmente, le modèle fait du surapprentissage ; si les deux restent élevées, il est en sous-apprentissage. Le compromis biais-variance permet d’analyser ces deux situations.
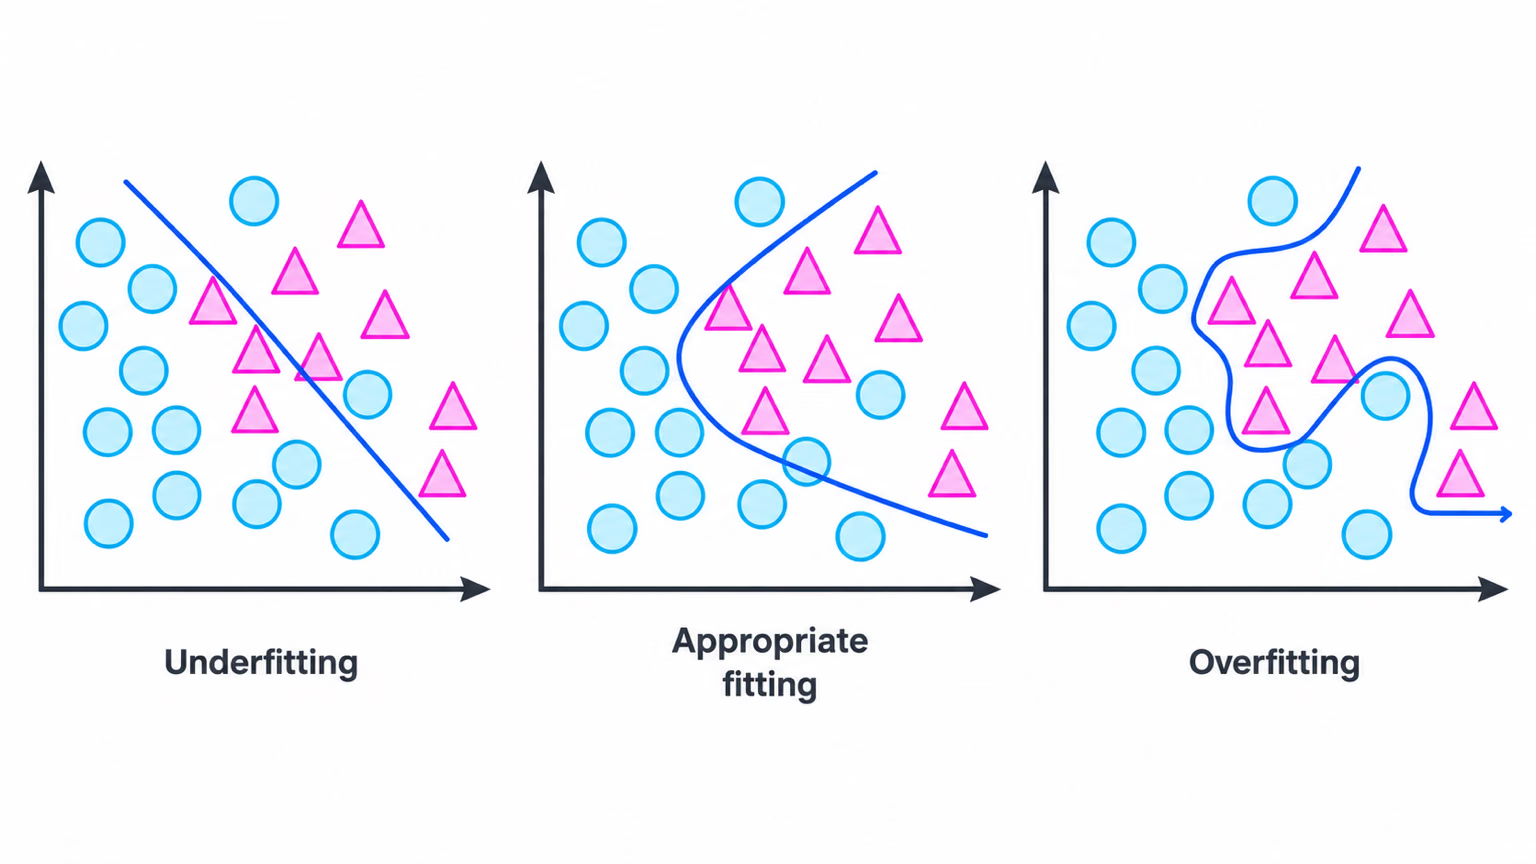
Pour le surapprentissage, voici les corrections classées selon leur fréquence d’efficacité : davantage de données variées ; moins d’époques ou un patience plus strict ; et l’augmentation des données (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). Les valeurs par défaut de l’augmentation sont déjà efficaces ; ne les modifie que si tu as une raison, par exemple désactiver fliplr lorsque la gauche et la droite sont importantes.
Transformer les constats en liste de corrections#
Corrige les données avant de régler les hyperparamètres, et ne change qu’un élément par itération pour savoir ce qui a aidé. La partie du cycle consacrée au jeu de données est abordée dans Premier ajustement fin et cycle d’itération.
Éviter ces erreurs#
Symptôme : un modèle qui obtenait un score de 0.659 mAP50-95 passe soudainement à 0.403. Cause : pills_v1 a été entraîné avec imgsz=320 et validé avec imgsz=640 ; les objets semblent deux fois plus grands que tout ce qu'il a appris. Solution : valide et déploie avec le imgsz utilisé pour l'entraînement, et compare les exécutions uniquement à taille identique.
La validation s'exécute avec conf=0.001 afin de tracer toute la courbe précision-rappel, ce qui explique pourquoi val_batch0_pred.jpg affiche des boîtes que ton application ne signalerait jamais. Choisis le seuil de déploiement à partir de BoxF1_curve.png, puis vérifie-le avec predict.
Avec 23 images, la précision d'une époque est passée de 0.93 à 0.80, puis est remontée. Évalue les tendances sur plusieurs époques et exécutions, et agrandis le jeu de validation avant de te fier à des écarts d'un ou deux points.
Afficher la solution
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.