Entraîne ton premier modèle
Affine YOLO26 sur ton jeu de données en un seul appel, lis le journal d’entraînement en direct ligne par ligne et trouve best.pt ainsi que les graphiques importants dans le dossier d’exécution.
Entraîner un détecteur à partir de zéro prend des jours et nécessite d’énormes jeux de données. Affiner un YOLO26 préentraîné sur une centaine d’images prend environ une minute sur le CPU d’un ordinateur portable, car l’apprentissage par transfert réutilise tout ce que le modèle sait déjà sur les contours, les formes et les objets.
Dans cette leçon, tu vas entraîner le modèle sur le jeu de données de pilules, voir le mAP50-95 passer d’une valeur de référence proche de zéro à 0,66 en dix époques, et apprendre à déterminer rapidement, à partir du journal, si une exécution se déroule correctement ou te fait perdre du temps.
Pratique
Exemple détaillé : entraîner le détecteur de pilules#
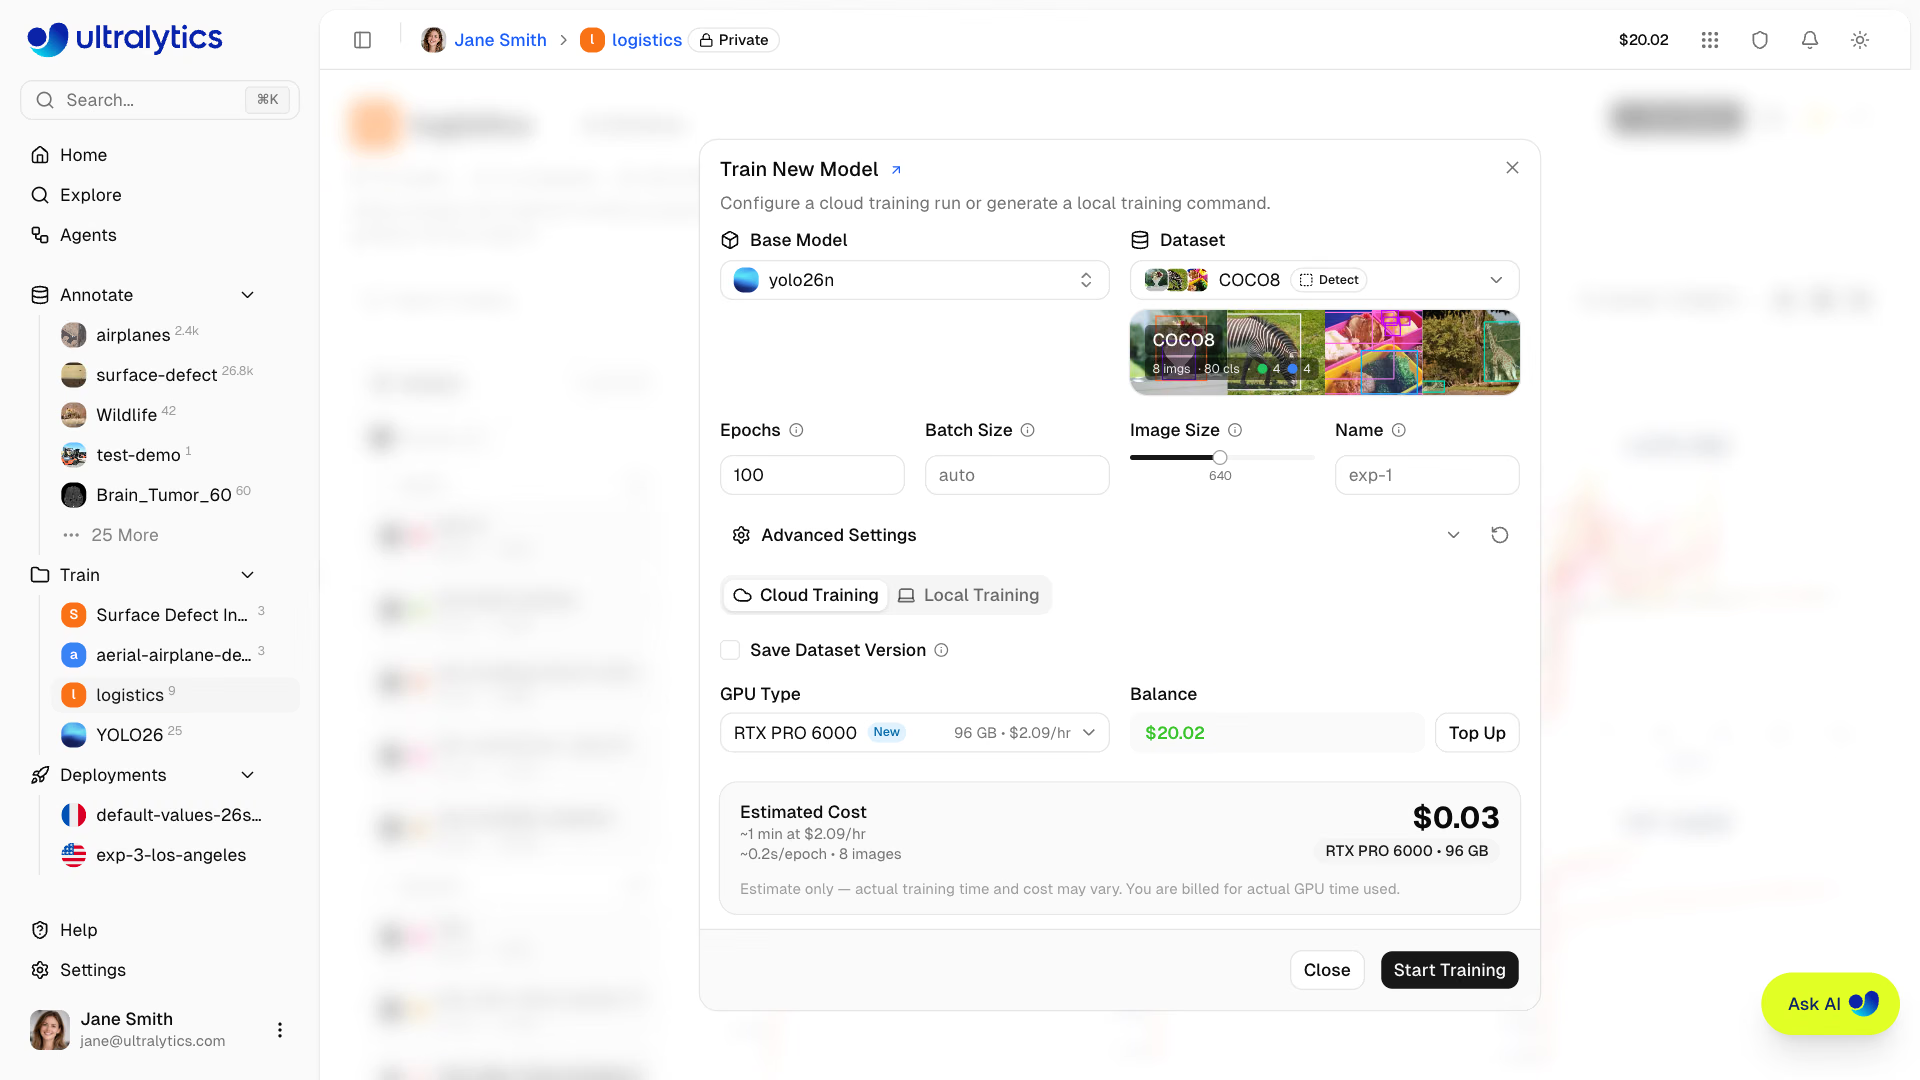
La boîte de dialogue « Entraîner un nouveau modèle » de la plateforme Ultralytics demande les mêmes choix que le code ci-dessous — modèle de base, jeu de données, époques et taille d’image — puis les exécute sur des GPU cloud ou génère la commande locale correspondante. Ces paramètres permettent de terminer l’entraînement en environ une minute sur le CPU d’un ordinateur portable :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # préentraîné sur COCO
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
La CLI et Python sont équivalents. epochs=10 et imgsz=320 raccourcissent les exécutions sur CPU ; avec un GPU, supprime les deux et accepte les valeurs par défaut (epochs=100, imgsz=640), car davantage d’époques et de pixels sont presque toujours bénéfiques. Le mode Train exécute cette boucle à ta place :
Lire le journal ligne par ligne#
Sortie réelle, réduite aux deux premières et aux deux dernières époques :
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): la valeur par défautoptimizer=autoa choisi l’optimiseur et le taux d’apprentissage à ta place.Using 92 train, 23 val images: vérifie que ces valeurs correspondent à ton jeu de données. Un nombre plus petit signifie que des images ont été ignorées.GPU_mem 0G: l’entraînement se fait sur le CPU. Sur un GPU, tu verrais ici la mémoire utilisée ;0Gsur une machine équipée d’un GPU signifie qu’il n’est pas utilisé.- Première ligne de chaque époque : les trois pertes pour la partition d’entraînement, ainsi que le nombre d’objets annotés dans le dernier lot (
Instances) et la taille des images. - Ligne
allde chaque époque : précision, rappel, mAP50 et mAP50-95 sur la partition de validation. C’est cette ligne qu’il faut surveiller.
| Colonne | Signification | Tendance saine |
|---|---|---|
box_loss | Écart entre les boîtes prédites et les boîtes annotées | Diminue, puis se stabilise |
cls_loss | Degré d’erreur des scores de classe | Diminue, puis se stabilise |
l1_loss | Erreur directe sur les coordonnées des boîtes de YOLO26 | Diminue |
P, R | Précision et rappel sur la partition de validation | Augmentent et restent équilibrés |
mAP50, mAP50-95 | Qualité de détection ; le mAP50-95 récompense aussi les boîtes bien ajustées | Augmente, puis atteint un plateau |
Ici, le mAP50-95 est passé de la valeur de référence 0,0002 à 0,548 après une époque, puis à 0,659 après dix. La précision a baissé à 0,80 à l’époque 4, puis s’est rétablie : les résultats d’une seule époque sont bruités sur 23 images de validation ; juge la tendance, pas une seule ligne. Règles de décision pendant une exécution :
- Les pertes diminuent et le mAP augmente : laisse l’entraînement continuer.
- Les pertes sont stables dès l’époque 1 : arrête avec Ctrl+C et vérifie les annotations et le YAML.
- La précision est bien supérieure au rappel : le modèle est prudent et manque des objets. Le rappel est bien supérieur à la précision : il détecte des choses qui n’existent pas.
- Le mAP reste stable pendant de nombreuses époques : davantage d’époques n’aideront pas ; modifie les données ou
imgsz.
Les trois pertes sont les composantes de la fonction de perte de YOLO26 ; le guide des métriques de performance explique chaque métrique en détail.
Trouver les fichiers générés par l’exécution#
Tout se trouve dans runs/detect/pills_v1/ :
| Fichier | Utilité |
|---|---|
weights/best.pt | Point de contrôle offrant la meilleure aptitude de validation parmi les époques ; utilise-le pour l’inférence et l’exportation |
weights/last.pt | Dernier point de contrôle ; utilisé pour reprendre une exécution interrompue |
args.yaml | Tous les arguments utilisés par l’exécution, pour pouvoir la reproduire |
results.csv, results.png | Pertes et métriques par époque, sous forme de données et de graphiques |
labels.jpg | Histogrammes des classes, de la taille et de la position des boîtes |
train_batch*.jpg | Lots d’entraînement augmentés avec les annotations dessinées |
val_batch*_labels.jpg, val_batch*_pred.jpg | Vérités terrain et prédictions sur les images de validation |
confusion_matrix*.png, Box*_curve.png | Matrice de confusion et courbes de précision, de rappel, de F1 et PR |
Ouvre train_batch0.jpg avant toute autre chose. Si les boîtes ne se superposent pas aux objets, les annotations sont incorrectes et aucun nombre d’époques ne corrigera le problème.
Modifie d’abord ces arguments#
| Argument | Par défaut | À modifier quand |
|---|---|---|
epochs | 100 | Expériences courtes sur CPU ou petits jeux de données qui commencent à présenter du surapprentissage (diminue la valeur) ; grands jeux de données qui continuent à s’améliorer (augmente-la, entre 200 et 300) |
imgsz | 640 | Petits objets (augmente à 1024 ou 1280) ou expériences sur CPU (diminue) |
batch | 16 | Taille de lot : diminue-la en cas d’erreur de mémoire insuffisante, ou utilise -1 pour l’ajuster automatiquement à environ 60 % de la mémoire du GPU |
patience | 100 | Arrête tôt si l’aptitude de validation ne s’est pas améliorée pendant N époques, par exemple patience=20 |
device | auto | Force cpu, mps, un indice de GPU comme 0 ou plusieurs indices comme [0, 1] |
name | train | Dans tous les cas : nomme les exécutions d’après ce qui a changé |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")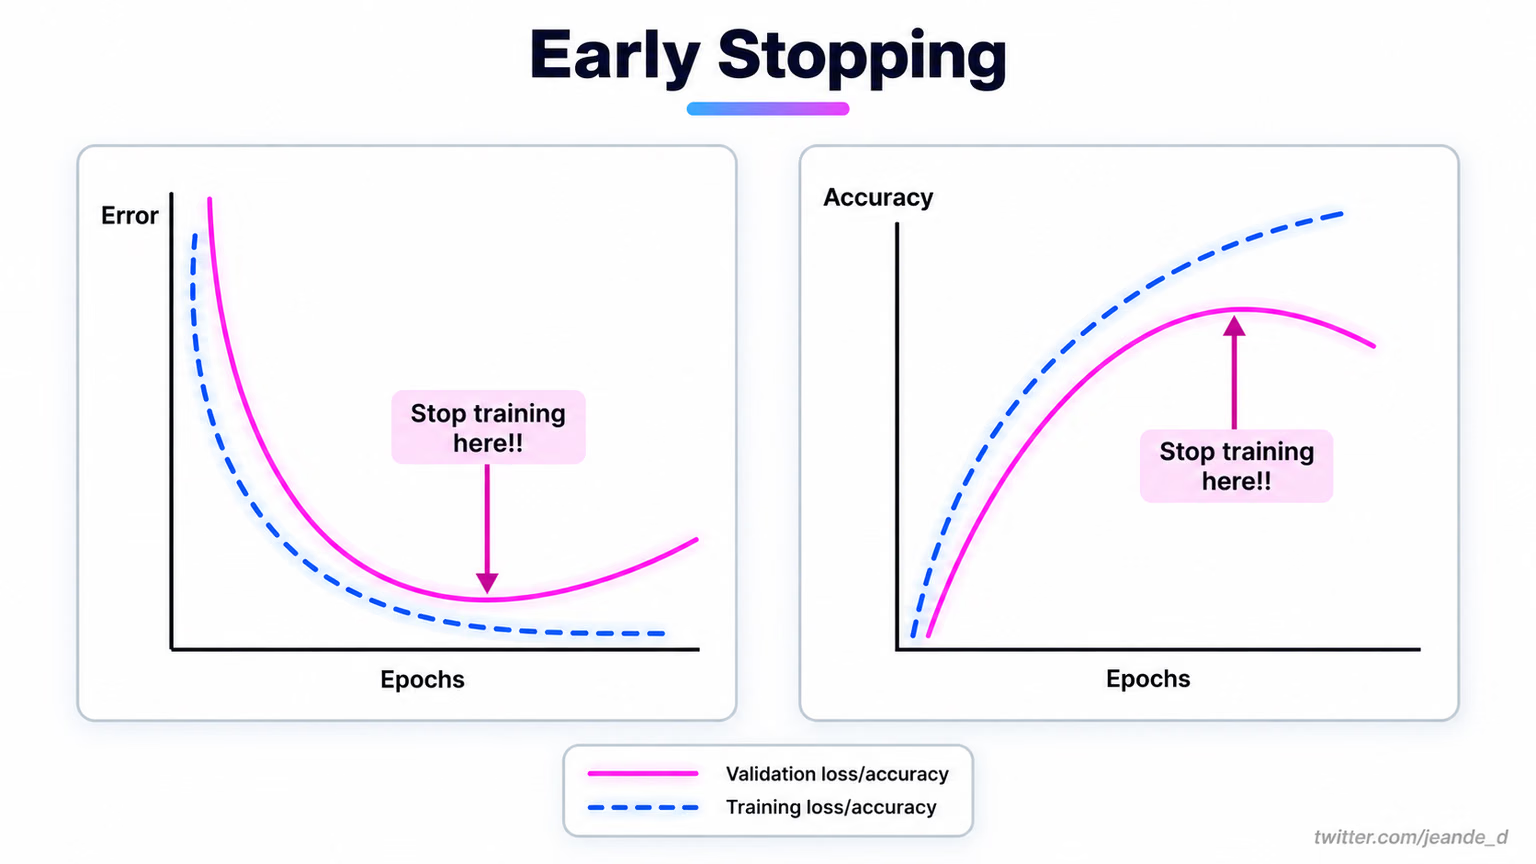
La valeur par défaut 100 de patience signifie qu’une exécution de 100 époques ne s’arrête jamais de façon anticipée. Une valeur plus stricte met fin à une exécution qui stagne, au moment indiqué par les courbes ci-dessus ; best.pt est conservé dans tous les cas.
Avec plusieurs GPU, passe une liste comme device=[0, 1, 2, 3] : Ultralytics lance l’entraînement distribué en parallèle sur les données (DDP) à ta place, batch correspond au total pour tous les GPU, et l’entraînement utilise par défaut la précision mixte (amp=True). Quand ton ordinateur portable ne suffit plus, le même jeu de données et les mêmes arguments peuvent être exécutés sur des GPU cloud via la plateforme Ultralytics, comme expliqué dans Entraîner, lire et affiner des exécutions.
Éviter ces erreurs#
Symptôme : mAP proche de zéro après de nombreuses époques sur un petit jeu de données. Cause : le modèle provient de yolo26n.yaml (poids aléatoires) plutôt que de yolo26n.pt. Solution : pars toujours d'un .pt préentraîné. L'entraînement à partir de zéro n'est intéressant que pour la recherche sur les backbones ou avec de très grands jeux de données.
Symptôme : CUDA out of memory dès la première époque. Solution : divise batch par deux ou définis batch=-1 pour qu'AutoBatch choisisse une taille adaptée. Réduire également imgsz peut aider, mais cela change ce que le modèle peut voir.
last.pt correspond à la dernière époque, qui peut être moins performante qu'une époque précédente. best.pt correspond à l'époque avec le meilleur score de validation, et c'est celle qu'il faut valider, exporter et déployer.
Le guide des conseils d’entraînement des modèles présente les autres arguments, et le guide du réglage des hyperparamètres traite des balayages du taux d’apprentissage et de l’optimiseur génétique. Le guide d’affinage traite du gel des couches.
Afficher la solution
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pillsLes valeurs exactes varient légèrement selon le matériel et la version du paquet.