Surveiller l’état de santé et la précision
Consulte les métriques des points de terminaison et les statistiques de prédiction de Platform, configure une alerte à partir d’une vérification de santé planifiée et détecte la dérive de précision avec un traitement sur un jeu de validation.
Un point de terminaison peut renvoyer 200 OK à chaque requête alors que sa précision chute de 5 points parce que l’équipe de nuit a baissé l’éclairage. Platform montre le comportement de chaque point de terminaison, mais n’envoie aucune alerte et ne peut pas mesurer la précision sans annotations. Cette leçon crée les deux vérifications planifiées qui comblent cette lacune et simule une alerte de précision lors d’une équipe de nuit.
Pratique
Ce que Platform affiche#

| Signal | Emplacement | Durée de conservation |
|---|---|---|
| Requêtes HTTP, taux d’erreur (4xx et 5xx), latence P95 | Cartes sur la page du déploiement et dans l’onglet Deployments, actualisées chaque minute | Les cartes couvrent 24 heures ; l’API donne accès aux données sur une période de 1 heure à 30 jours |
| État de santé | Carte Endpoint de l’onglet Overview | Données en temps réel ; nouvelles tentatives automatiques en cas de problème de santé |
| Journaux | Onglet Logs : les 20 entrées les plus récentes, avec le filtre Errors | L’API renvoie jusqu’à 200 entrées par requête, avec pagination |
| Statistiques de prédiction et exemples temporaires (jusqu’à 100 images) | Onglet Monitoring | Mémoire de l’instance de service uniquement |
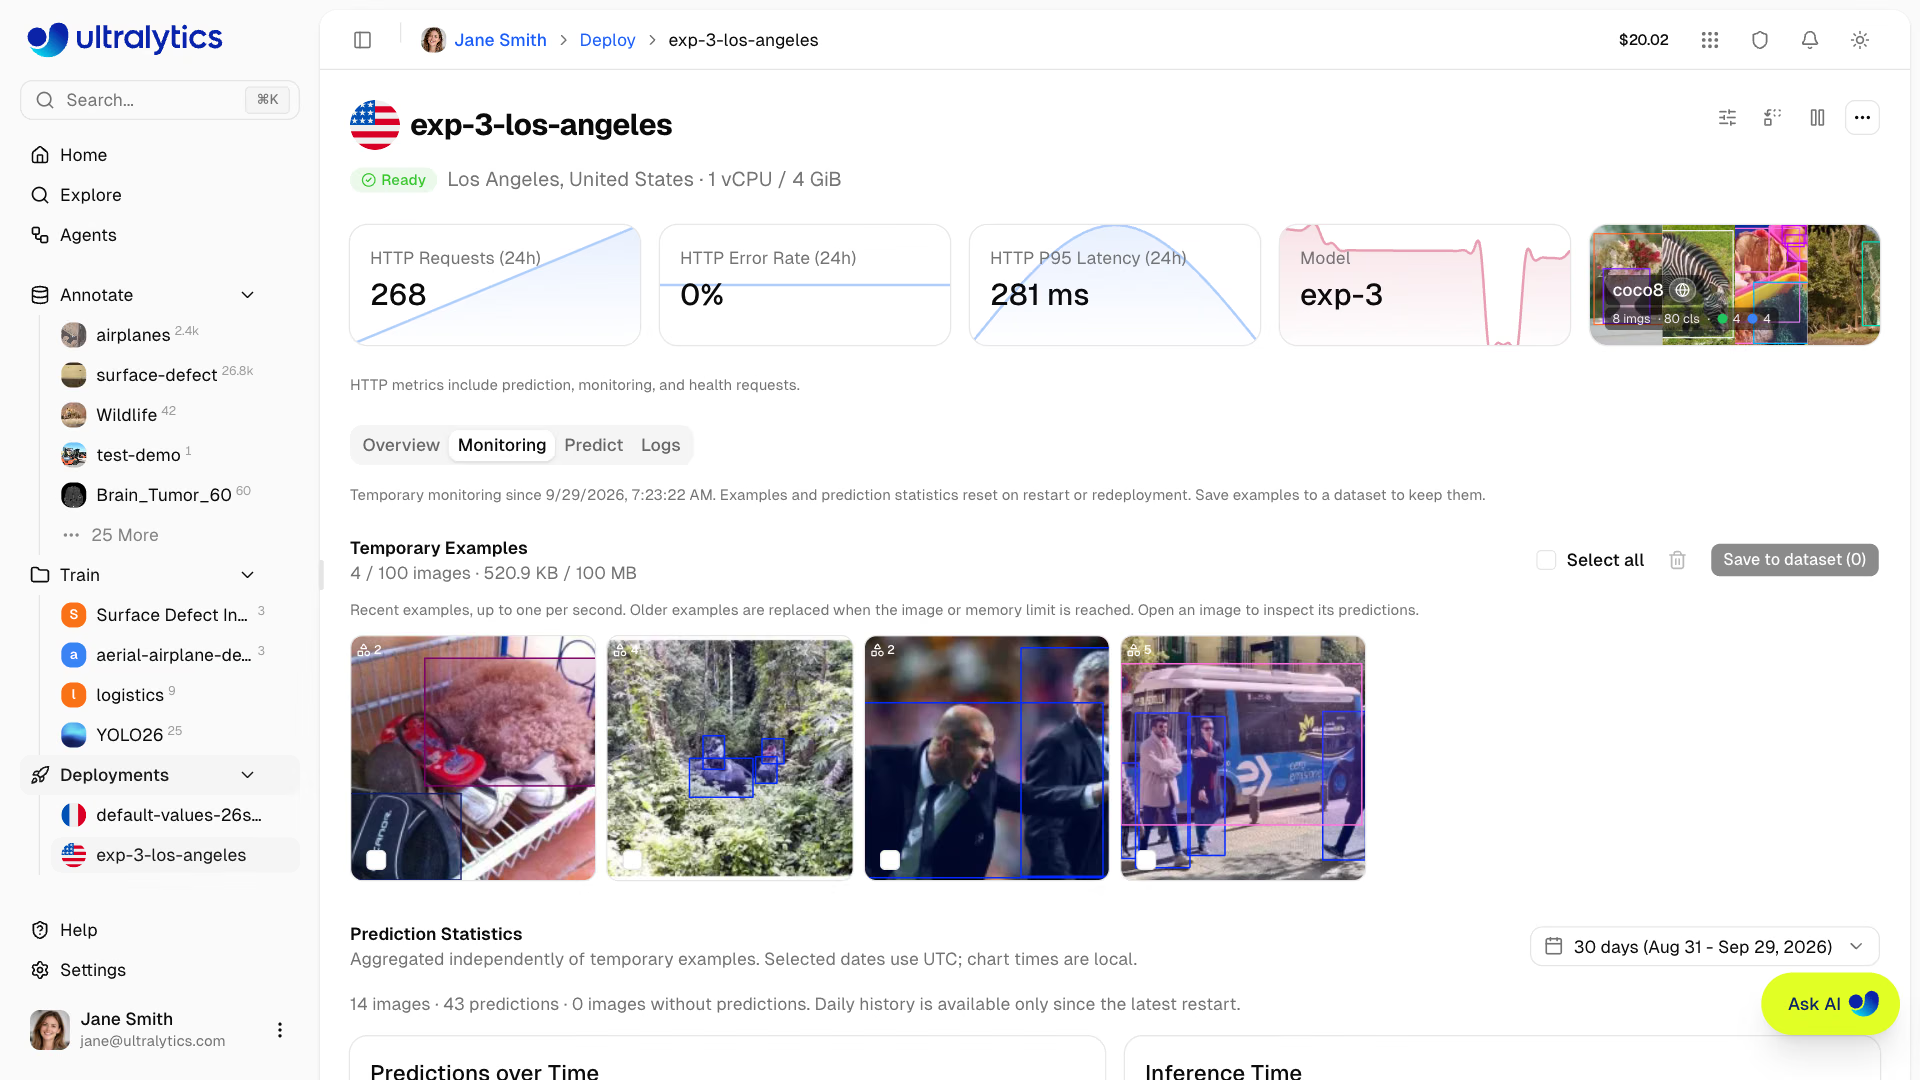
Deux réserves conditionnent tout le reste. Les métriques sont collectées uniquement lorsque le point de terminaison est Ready, et la suppression d’un déploiement met fin à l’accès à son historique. Les statistiques et les exemples de l’onglet Monitoring sont perdus dès que le point de terminaison s’arrête, redémarre ou change de taille, ou que son modèle est remplacé : il s’agit d’une vue en direct, pas d’une archive.
Exemple détaillé : une vérification planifiée du point de terminaison#
Platform affiche en rouge la carte du taux d’erreur au-dessus de 5 %, et Slack peut signaler qu’un déploiement est prêt ou qu’il n’a pas démarré, mais il n’existe pas d’alertes de seuil. Exécute cette vérification toutes les 5 minutes depuis cron, CI ou ton agent de surveillance, et déclenche une alerte en cas de code de sortie non nul :
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
Exécuté contre une API factice qui renvoie un point de terminaison en bonne santé, le script affiche une ligne et renvoie le code de sortie 0 ; avec P95_BUDGET_MS = 100, les mêmes données renvoient le code de sortie 1 :
healthy=True requests=1200 p95=180 ms errors=0.40%healthvérifie le point de terminaison et renvoiehealthy,statusetlatencyMs. Il réveille aussi un point de terminaison dont la mise à l’échelle est descendue à zéro ; une vérification toutes les 5 minutes sert donc également de signal pour le maintenir actif.metrics(..., view="overview")renvoietotalRequests,errorRate(un pourcentage) etp95LatencyMspour la période.logsrécupère les dernières erreurs et les derniers avertissements, afin que l’alerte fournisse un premier indice.
Installe le SDK avec pip install -U ultralytics-platform (le SDK nécessite Python 3.11 ou une version ultérieure). Ne déclenche une alerte qu’en cas de dépassement prolongé, par exemple après trois vérifications consécutives en échec, et associe à chaque alerte une procédure d’intervention d’une ligne.
Exemple détaillé : suivre la précision avec un jeu de validation#
Les métriques des requêtes ne mesurent pas la précision. Un jeu de validation le permet : 200 à 500 images représentatives de la production, soigneusement annotées, dans leur propre version privée d’un jeu de données, et jamais utilisées pour l’entraînement. Évalue chaque semaine le point de contrôle déployé et ajoute les résultats à un fichier historique :
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
La première exécution consigne la référence du jour du déploiement. Simule ensuite l’alerte avant d’en avoir besoin : ce script crée une copie du jeu de validation « équipe de nuit », avec les mêmes annotations et les mêmes images à 15 % de luminosité :
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbookToutes les requêtes pendant l’équipe de nuit renverraient toujours 200 en quelques millisecondes, alors que la précision du modèle a chuté de 5 points de mAP. Seul le jeu de validation permet de le détecter. Actualise le jeu de validation chaque trimestre avec de nouvelles images de production annotées, et réinitialise la référence à chaque déploiement d’un nouveau modèle. Le guide de surveillance des modèles et la leçon Observabilité et dérive présentent les tests statistiques de dérive.
Détecter la dérive dans l’onglet Monitoring#
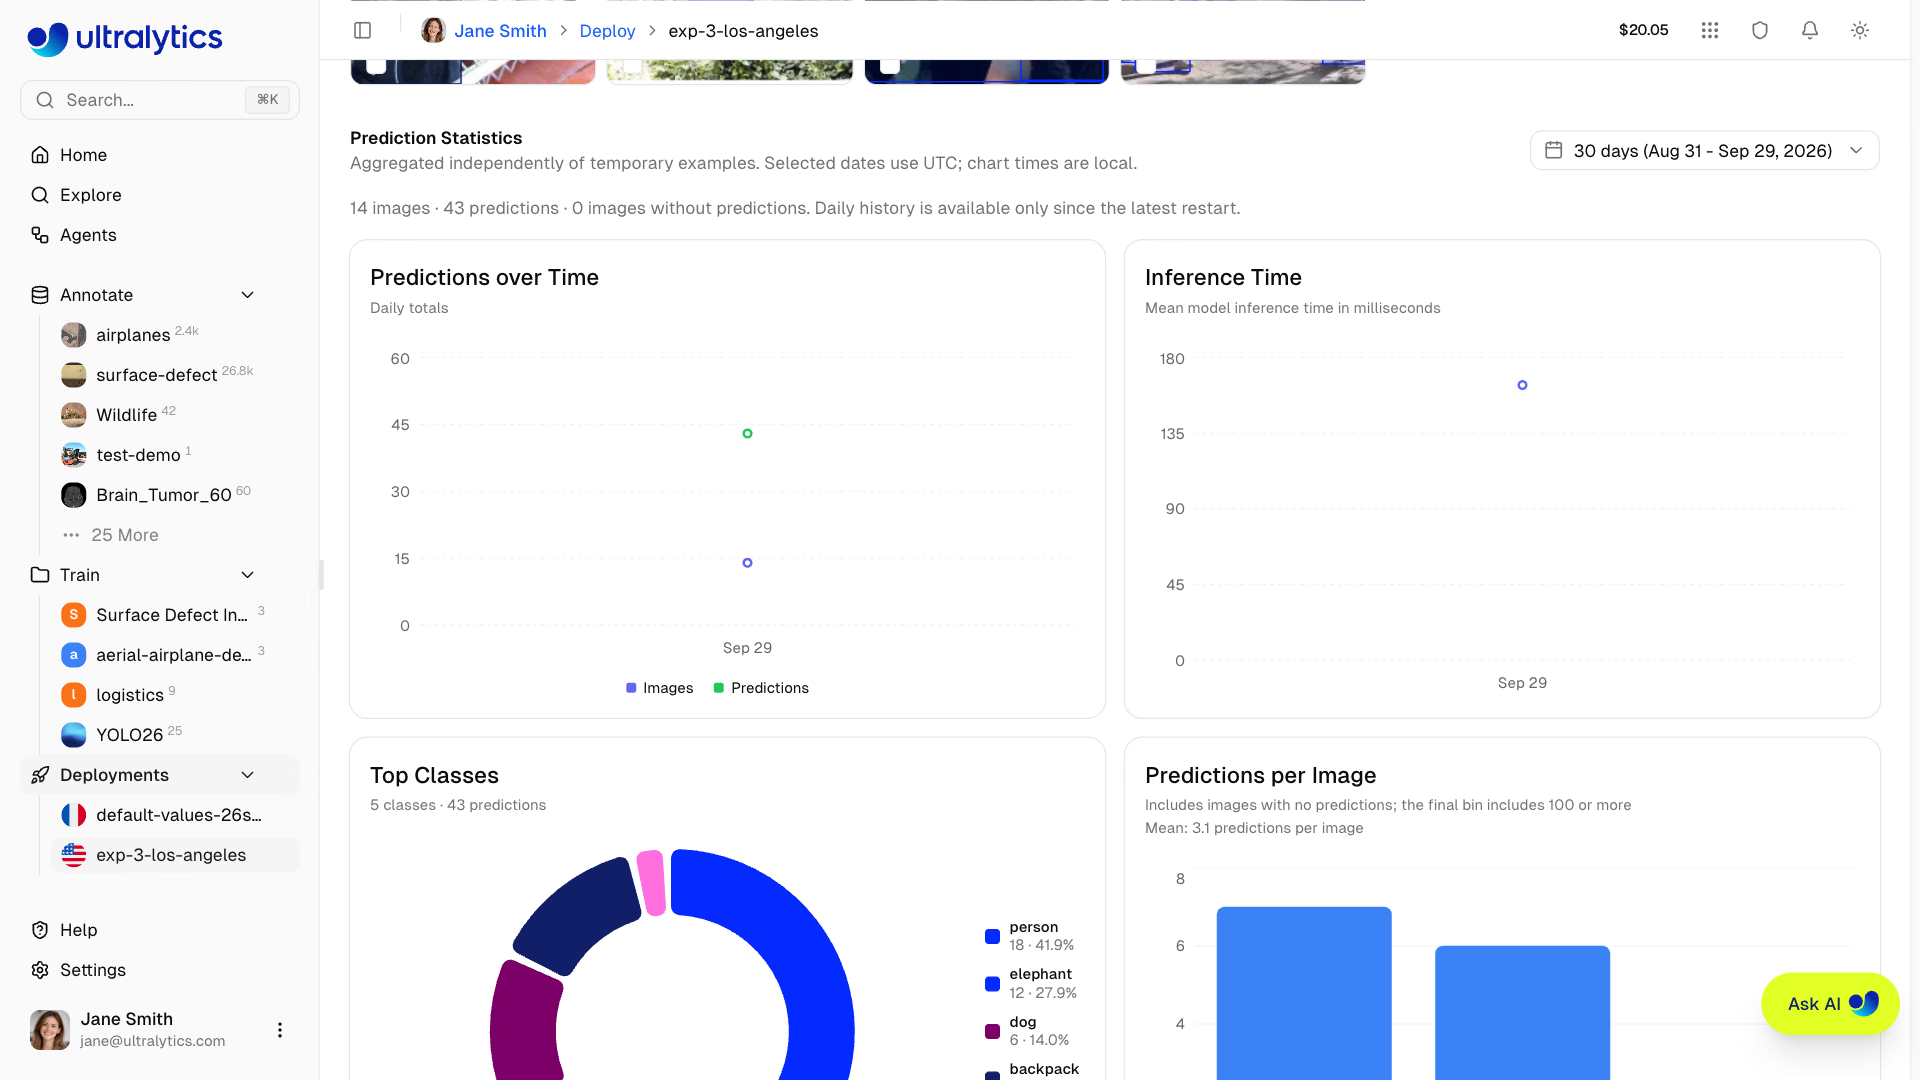
Observe la forme des graphiques pendant la semaine du déploiement, puis compare-la à celle des semaines suivantes. La confiance mesure le degré de certitude, pas l’exactitude ; interprète donc ces données en parallèle avec celles du jeu de validation :
| Situation | Cause probable | Action |
|---|---|---|
| La confiance diminue, la performance du jeu de validation reste stable | Changement bénin du domaine | Surveille la situation ; enregistre des exemples pour la prochaine version du jeu de données |
| La confiance et la performance du jeu de validation diminuent | Régression réelle de la précision | Réentraîne le modèle (leçon 10) |
| La taille ou l’emplacement des boîtes change soudainement | La caméra a bougé, l’objectif ou le site a changé | Vérifie la caméra avant de modifier le modèle |
| Le nombre de prédictions par image diminue, la confiance reste stable | Caméra hors ligne, scène plus calme ou bogue dans un client | Recherche la cause en amont |
| La latence P95 augmente, le temps d’inférence reste stable | Traitement des requêtes, taille des charges utiles ou capacité | L’infrastructure, pas le modèle |
Réinjecter les images de production#
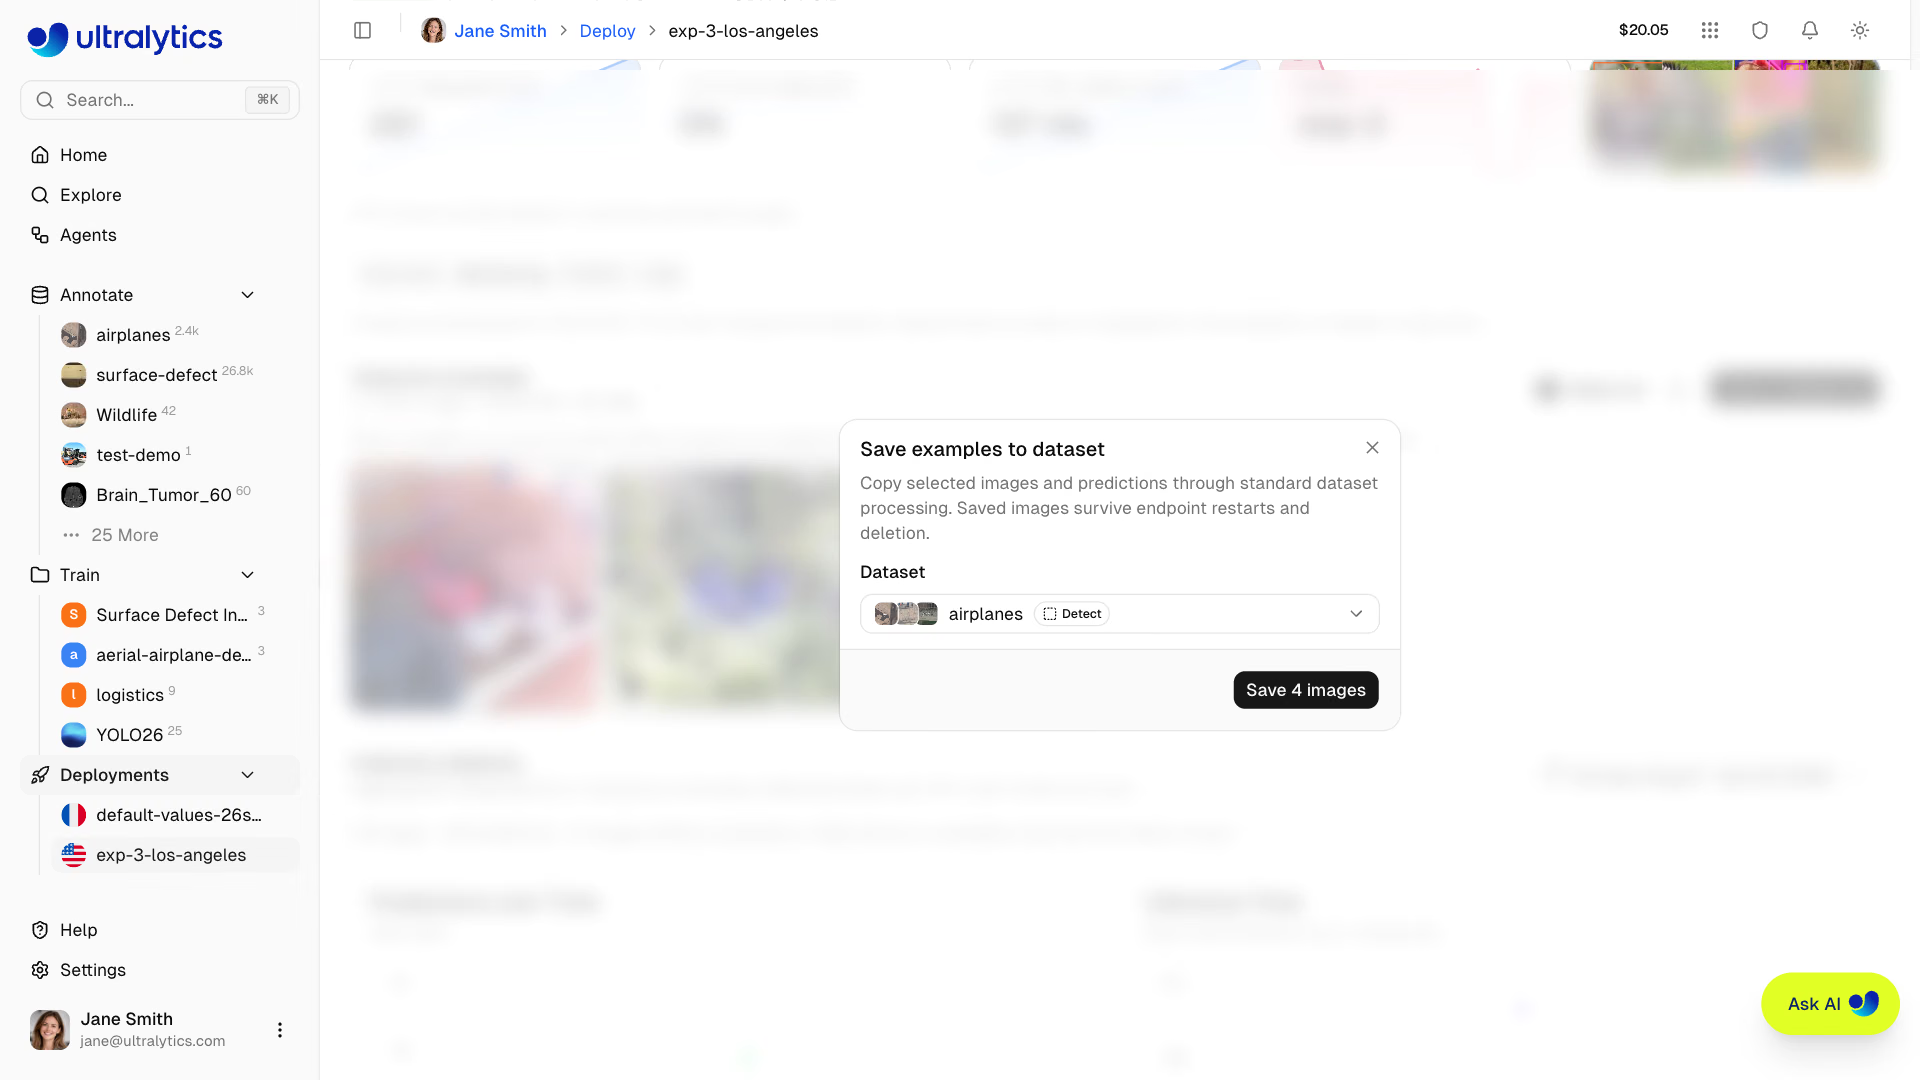
Dans l’onglet Monitoring, sélectionne des exemples et clique sur Save to dataset ; ils sont soumis au processus d’ingestion habituel avec leurs prédictions, et deploymentId ainsi que la région sont conservés dans leurs métadonnées. Le modèle Collect Uncertain Detections d’Agents fait de même pour un jeu de données entier : il effectue les prédictions avec ton déploiement et copie dans un jeu de données de révision les images contenant des détections dont la confiance se situe dans une plage donnée.
Pièges#
Symptôme : les exemples que tu voulais annoter ont disparu après un redimensionnement ou un changement de modèle. Correctif : ils sont stockés dans la mémoire de l’instance de service. Enregistre-les dans un jeu de données et attends la fin de l’ingestion avant d’arrêter, de redimensionner ou de remplacer le modèle.
Symptôme : l’alerte du jeu de réserve se déclenche juste après le déploiement d’un meilleur modèle, ou ne se déclenche plus jamais. Correctif : la référence correspond à la première ligne de l’historique. Crée un nouveau holdout_history.jsonl (ou enregistre une nouvelle ligne de référence) chaque fois que tu remplaces le modèle.
Symptôme : le taux d’erreur grimpe pendant un pic de trafic alors que l’état de santé est au vert. Correctif : les réponses 429 sont comptées comme des erreurs, mais signifient « capacité maximale atteinte ». Consulte les journaux ; s’il s’agit d’erreurs 429, répartis le trafic sur davantage de points de terminaison ou utilise une taille personnalisée supérieure.
Afficher la solution
Exemple de solution pour le point de terminaison des pilules : une entrée cron */5 * * * * python endpoint_check.py || ./page-oncall.sh avec P95_BUDGET_MS = 300 et MAX_ERROR_RATE = 1.0 ; régler le budget à 100 ms avec un vrai P95 de 180 ms entraîne une sortie avec le code 1 et déclenche une notification, ce qui confirme que le câblage fonctionne. Le job CI hebdomadaire exécute holdout_check.py avec DEPLOYED = "pills-v2.pt" sur la version privée du jeu de validation de 300 images : référence à 0,69. La simulation de l’équipe de nuit fait baisser le résultat de 0,05 et affiche la ligne ALERT avec le code de sortie 1, ce qui fait échouer le job CI et avertit le canal. Douze exemples Monitoring de l’équipe du soir sont envoyés dans pill-review via Enregistrer dans le jeu de données, chacun étant étiqueté avec deploymentId et europe-west1.