Observabilité et dérive
Consigne les métriques qui détectent les pertes de précision silencieuses, teste les distributions de confiance pour repérer les dérives et ne déclenche des alertes que sur des signaux exploitables.
Un service de vision peut être opérationnel, rapide et pourtant se tromper. Une caméra est déplacée, l’éclairage change, une nouvelle gamme de produits arrive, et le modèle continue de renvoyer des boîtes alors que tous les tableaux de bord de l’infrastructure restent au vert. Dans cette leçon, l’assombrissement d’un clip pour simuler le crépuscule n’a modifié la confiance moyenne que de 0,01, variation invisible sur un graphique, mais un test KS à deux échantillons l’a détectée avec p = 0,007. Tu vas créer ce contrôle ainsi que la journalisation qui l’alimente.
Pratique
Trois niveaux de signaux#
| Niveau | Question | Signaux |
|---|---|---|
| Infrastructure | Le service est-il opérationnel et suit-il le rythme ? | Latence, débit, images perdues, utilisation du CPU et du GPU |
| Comportement du modèle | Le modèle se comporte-t-il comme la semaine dernière ? | Détections par image, confiance moyenne, répartition des classes, tailles des boîtes |
| Précision du modèle | Le modèle donne-t-il toujours des résultats corrects ? | mAP sur le jeu de réserve (métriques de performance), échantillonnage pour une vérification humaine, taux de fausses alertes |
La plupart des équipes couvrent le premier niveau avec des outils standards et s’arrêtent là. C’est aux deuxième et troisième niveaux que les systèmes de vision échouent sans bruit ; le guide de surveillance des modèles couvre l’ensemble du cycle de maintenance.
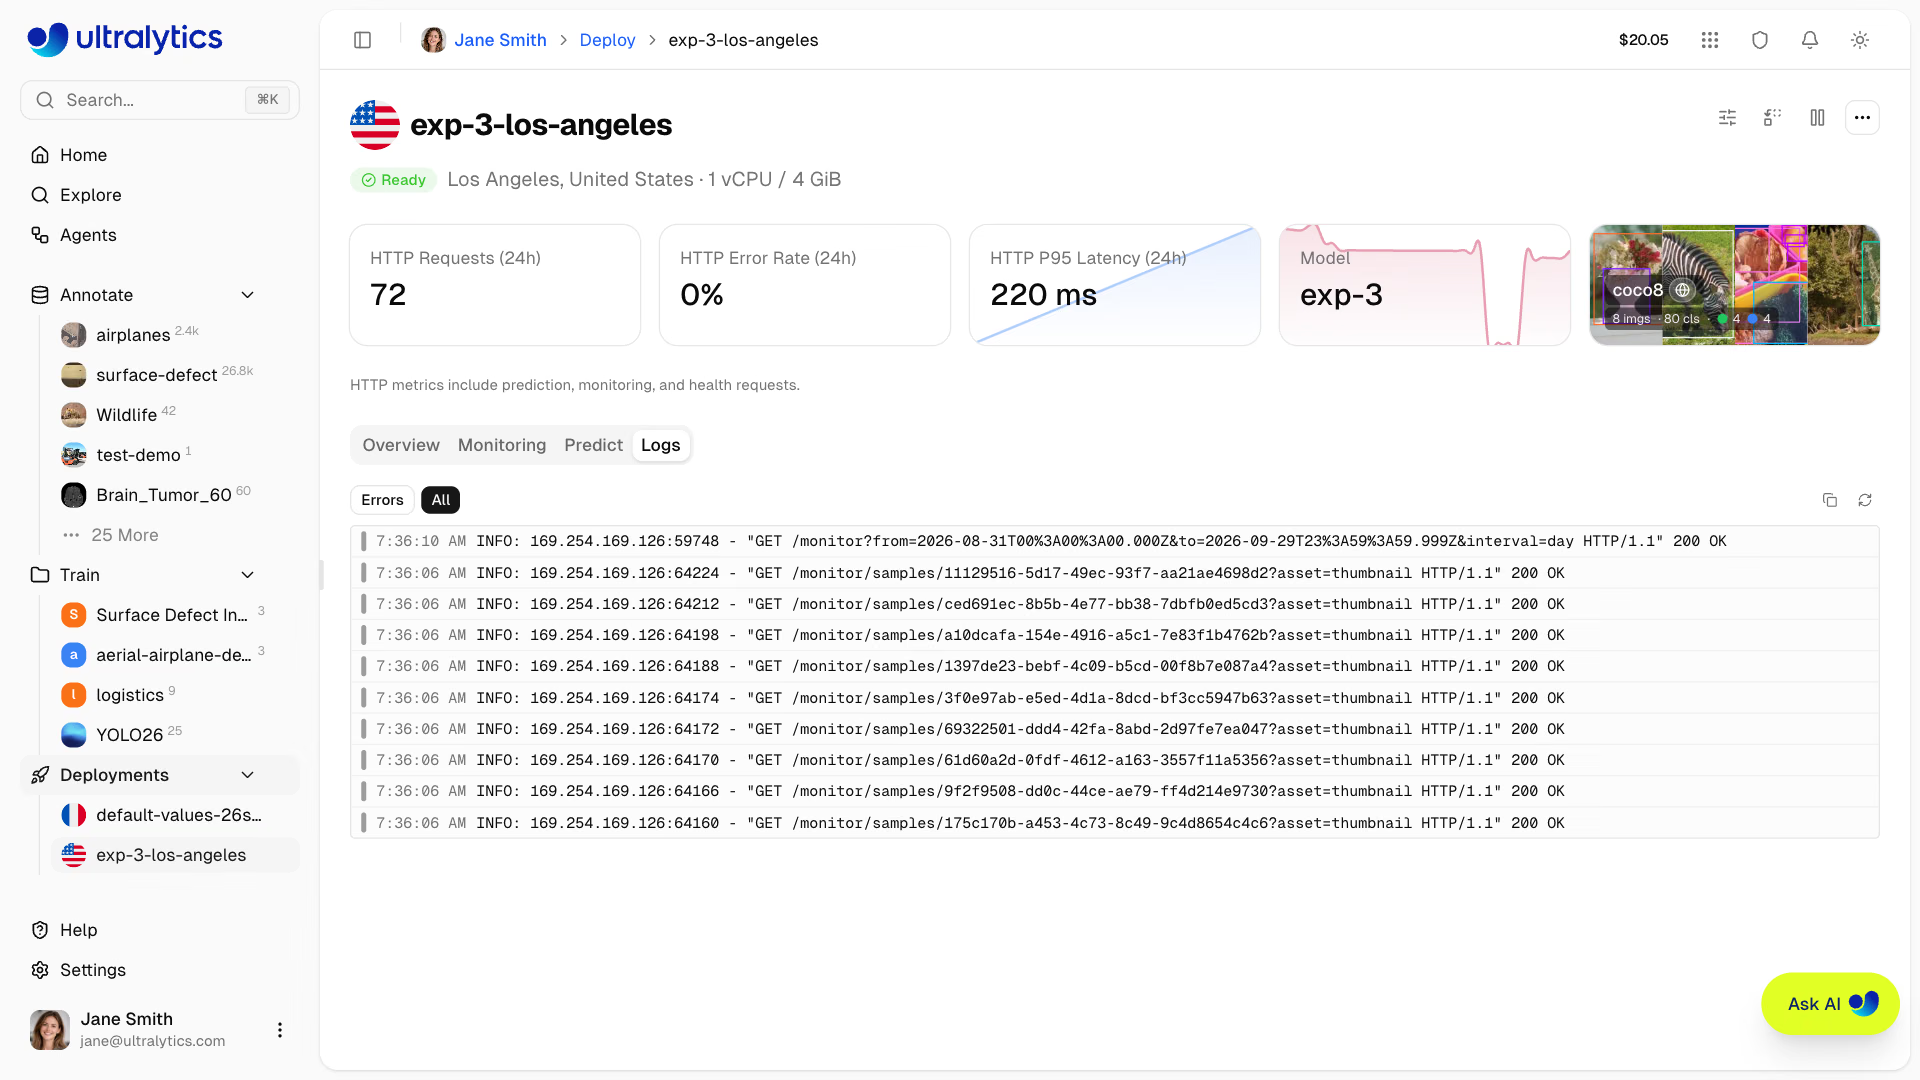
Si tu déploies avec Ultralytics Platform, la page de déploiement fournit les données de l’infrastructure (requêtes, taux d’erreur, latence P95) et les journaux des requêtes, que tu peux filtrer pour afficher les erreurs, comme ci-dessus ; la leçon Surveiller l’état et la précision les présente. À toi de construire les niveaux du comportement et de la précision ; le reste de cette leçon s’y consacre.
Émettre des métriques pour chaque image#
Chaque objet Results contient des temps d’exécution et des boîtes. Écris une ligne JSON par image et envoie-la au système de métriques que tu utilises :
import json
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
with open("metrics.jsonl", "w") as log:
    for r in model.predict(video, stream=True, verbose=False):
        conf = r.boxes.conf
        record = {
            "ts": time.time(),
            "camera": "lobby-1",
            "inference_ms": round(r.speed["inference"], 1),
            "detections": len(r.boxes),
            "mean_conf": round(conf.mean().item(), 3) if len(conf) else None,
            "confs": [round(c, 3) for c in conf.tolist()],  # valeurs brutes pour le test de dérive
        }
        log.write(json.dumps(record) + "\n")
print({k: v for k, v in record.items() if k != "confs"})
{'ts': 1792003254.33, 'camera': 'lobby-1', 'inference_ms': 34.7, 'detections': 22, 'mean_conf': 0.543}À quoi sert chaque champ :
- inference_ms : déclenche une alerte lorsque le p95 dépasse ton budget.
- detections : une chute soudaine à près de zéro indique généralement qu’une caméra est bloquée ou en panne ; une hausse signale un changement de scène ou des faux positifs.
- mean_conf : une courbe de tendance rapide, mais trop grossière pour détecter une dérive à elle seule.
- confs : la distribution complète, nécessaire au test de dérive ci-dessous.
Tester la dérive des distributions de confiance#
La dérive des données se manifeste dans les confiances bien avant que quiconque n’annote de nouvelles données. Recueille les confiances au lancement pour établir une référence, collecte une fenêtre récente, puis compare les deux distributions à l’aide d’un test de Kolmogorov-Smirnov à deux échantillons (pip install scipy). Ce script simule le crépuscule en assombrissant le même extrait vidéo :
import cv2
import numpy as np
from scipy.stats import ks_2samp

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

model = YOLO("yolo26n.pt")
video = str(safe_download("https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"))

def confidences(darken=1.0):
    """Collect every detection confidence from the clip, optionally darkened to simulate dusk."""
    cap, out = cv2.VideoCapture(video), []
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        out += model((frame * darken).astype(np.uint8), verbose=False)[0].boxes.conf.tolist()
    return np.array(out)

baseline = confidences()  # what "normal" looked like at launch
for name, recent in (("same scene", confidences()), ("dusk (35% brightness)", confidences(darken=0.35))):
    stat, p = ks_2samp(baseline, recent)
    print(f"{name:22s} n={len(recent):4d} mean_conf={recent.mean():.3f} KS={stat:.3f} p={p:.2g}")
same scene n=1376 mean_conf=0.519 KS=0.000 p=1
dusk (35% brightness) n=1337 mean_conf=0.508 KS=0.064 p=0.0068Examinons chaque ligne :
- Même scène : des distributions identiques donnent une statistique KS de 0 et p = 1 ; c’est le contrôle.
- Crépuscule : 39 détections en moins et une moyenne inférieure de seulement 0,011, ce que personne ne remarquerait sur un graphique. La statistique KS (le plus grand écart entre les deux distributions cumulées) est de 0,064, et p = 0,0068 < 0,01 indique que le décalage est réel.
Une alerte de dérive est une raison d’examiner des images échantillons, pas une preuve de défaillance. Si la dérive est réelle, collecte et annote des images des caméras concernées : le guide de collecte et d’annotation des données explique quoi collecter, et le guide de réglage fin explique comment réentraîner le modèle. La taille des boîtes (largeur × hauteur) constitue un deuxième indicateur de dérive facile à obtenir : les nouveaux supports et les nouvelles optiques s’y manifestent en premier.
Valider un jeu de données de contrôle chaque semaine#
Les signaux comportementaux indiquent qu’un changement a eu lieu ; seules les annotations permettent de savoir si la précision a baissé. Conserve un jeu de contrôle de 200 à 500 images de production annotées et valide chaque version du modèle, ainsi qu’une fois par semaine :
yolo val model=yolo26n.pt data=coco8.yaml > weekly_metrics.txt # use your production model and holdout YAMLEnregistre mAP50-95 et l’AP par classe au fil du temps, et déclenche une alerte lorsque mAP baisse de plus d’un point d’une semaine à l’autre. La cause la plus fréquente est un changement de modèle qui était censé ne rien modifier ; la deuxième est la dérive. Une matrice de confusion calculée sur le même jeu de contrôle met clairement en évidence les régressions par classe.
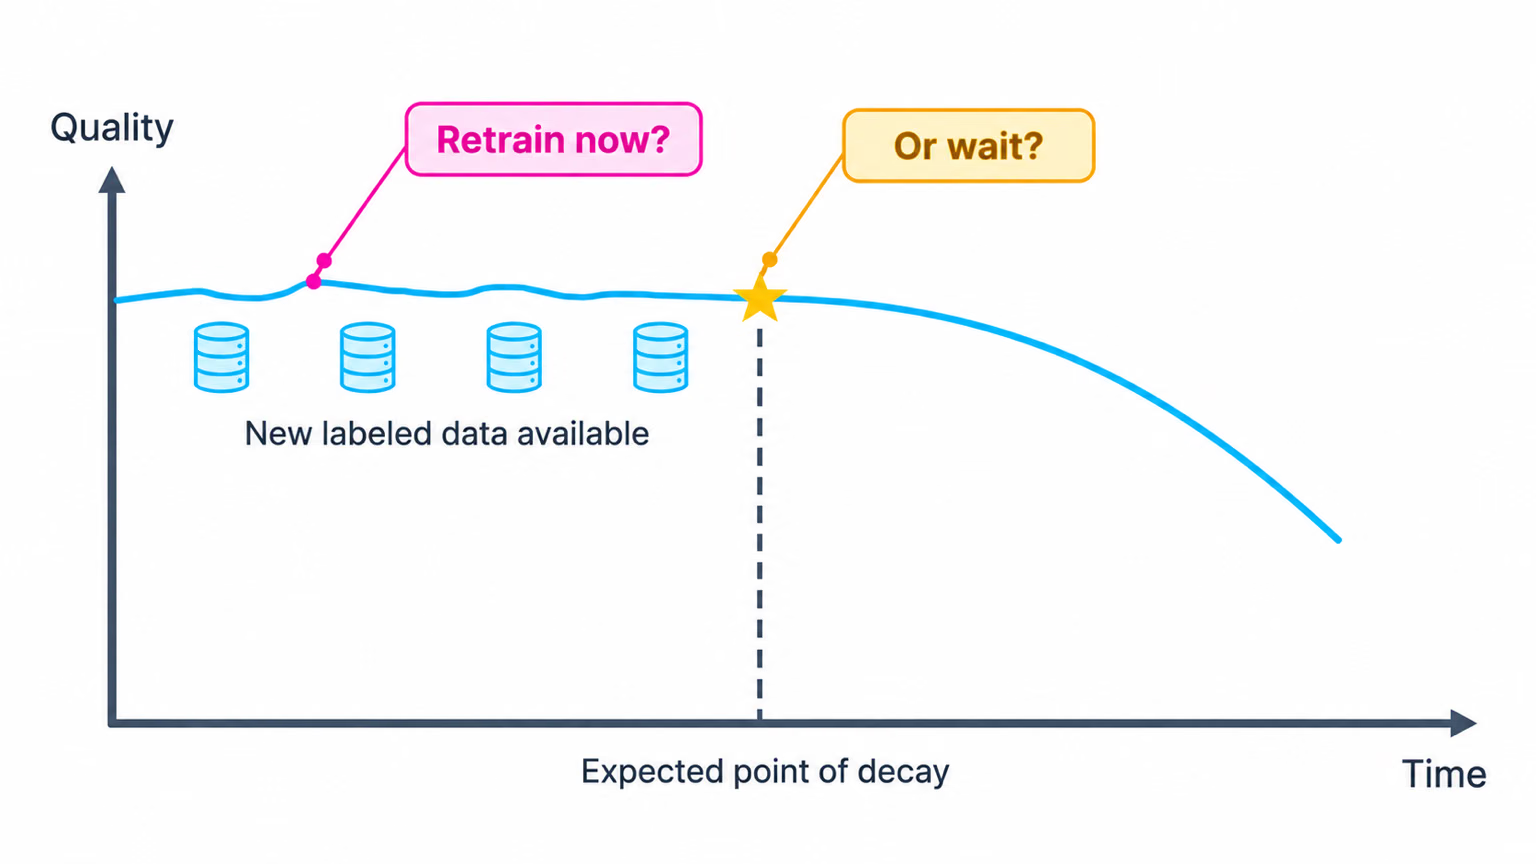
C’est le jeu de contrôle qui permet de répondre à la question posée par ce graphique. Réentraîne le modèle lorsque la qualité commence à baisser, ou lorsque tu disposes de suffisamment de nouvelles données annotées provenant des conditions ayant entraîné la dérive, et non selon un calendrier fixe.
Déclencher des alertes sur les actions, pas sur les chiffres#
| Signal | Déclenchement | Action |
|---|---|---|
p95 inference_ms | Dépassement du budget pendant plus de 3 minutes | Augmenter la capacité ou passer à l’export optimisé |
| Détections par image | Baisse d’au moins 50 % pendant 5 minutes | Vérifier le flux de la caméra, puis la version du modèle |
| Images perdues | Plus de 5 % pendant 10 minutes | Ajouter de la capacité ou réduire le FPS par flux |
| Test KS des confiances | p < 0,01 sur des fenêtres quotidiennes | Examiner les images, puis lancer la validation sur le jeu de contrôle |
| mAP50-95 sur le jeu de contrôle | Baisse d’au moins 1 point d’une semaine à l’autre | Collecter, annoter et régler finement le modèle |
Pièges#
Symptôme : le test KS se déclenche tous les soirs et tous les lundis. Solution : les cycles quotidiens et hebdomadaires sont de véritables changements de distribution. Compare des situations similaires (mêmes caméras, mêmes heures, mêmes jours de la semaine) et utilise des fenêtres de plusieurs milliers de détections.
Symptôme : la mAP du jeu de test semble bonne, alors que les utilisateurs signalent des erreurs de détection. Solution : le jeu de test doit ressembler à la production actuelle. Mets-le à jour chaque trimestre avec de nouvelles images annotées provenant des caméras importantes.
Chaque alerte doit être accompagnée d'une prochaine action écrite. Un signal que tu veux seulement surveiller doit apparaître sur un tableau de bord, pas déclencher une alerte.
Afficher la solution
Garde la première fenêtre saine de sortie monitor.py comme baseline.jsonl, puis compare chaque nouvelle fenêtre à celle-ci :
import json

import numpy as np
from scipy.stats import ks_2samp

def load(path):
    """Flatten the per-frame 'confs' lists written by monitor.py."""
    with open(path) as f:
        return np.array([c for line in f for c in json.loads(line)["confs"]])

baseline, recent = load("baseline.jsonl"), load("metrics.jsonl")
stat, p = ks_2samp(baseline, recent)
print(f"KS={stat:.3f} p={p:.2g} -> {'review frames' if p < 0.01 else 'ok'}")
KS=0.000 p=1 -> okC’est le résultat attendu lorsque les deux fichiers proviennent des mêmes séquences vidéo. Exécute le test chaque jour à l’aide d’un planificateur, envoie la statistique et la valeur p au même système de métriques que les journaux par image, et dirige review frames vers une personne, pas vers un système d’alerte.