Inférence multi-flux
Traite plusieurs caméras avec un seul modèle grâce à l’inférence par lots, à des files d’attente limitées et à la mesure des images perdues.
Un système qui suit le rythme d’une caméra peut prendre plusieurs minutes de retard avec quatre caméras, sans qu’aucune erreur ne survienne : les résultats arrivent simplement de plus en plus tard, jusqu’à épuisement de la mémoire. Sur le CPU de l’ordinateur portable utilisé ici, un flux à 30 FPS a suivi le rythme, quatre flux ont perdu la moitié de leurs images et huit en ont perdu plus des deux tiers. Cette leçon construit le pipeline qui mesure ce nombre, car cette mesure permet de dimensionner le matériel.
Pratique
Où passe le temps#
Chaque image passe par quatre étapes :
| Étape | Coût typique | S’exécute sur |
|---|---|---|
| Décodage (RTSP ou fichier → tableau) | 5–20 ms par image 1080p | CPU |
| Prétraitement (letterbox, normalisation) | environ 1 ms | CPU |
| Inférence | quelques ms (GPU) à plusieurs dizaines de ms (CPU) | Accélérateur |
| Post-traitement, suivi, sorties | quelques ms, davantage avec des bases de données lentes | CPU |
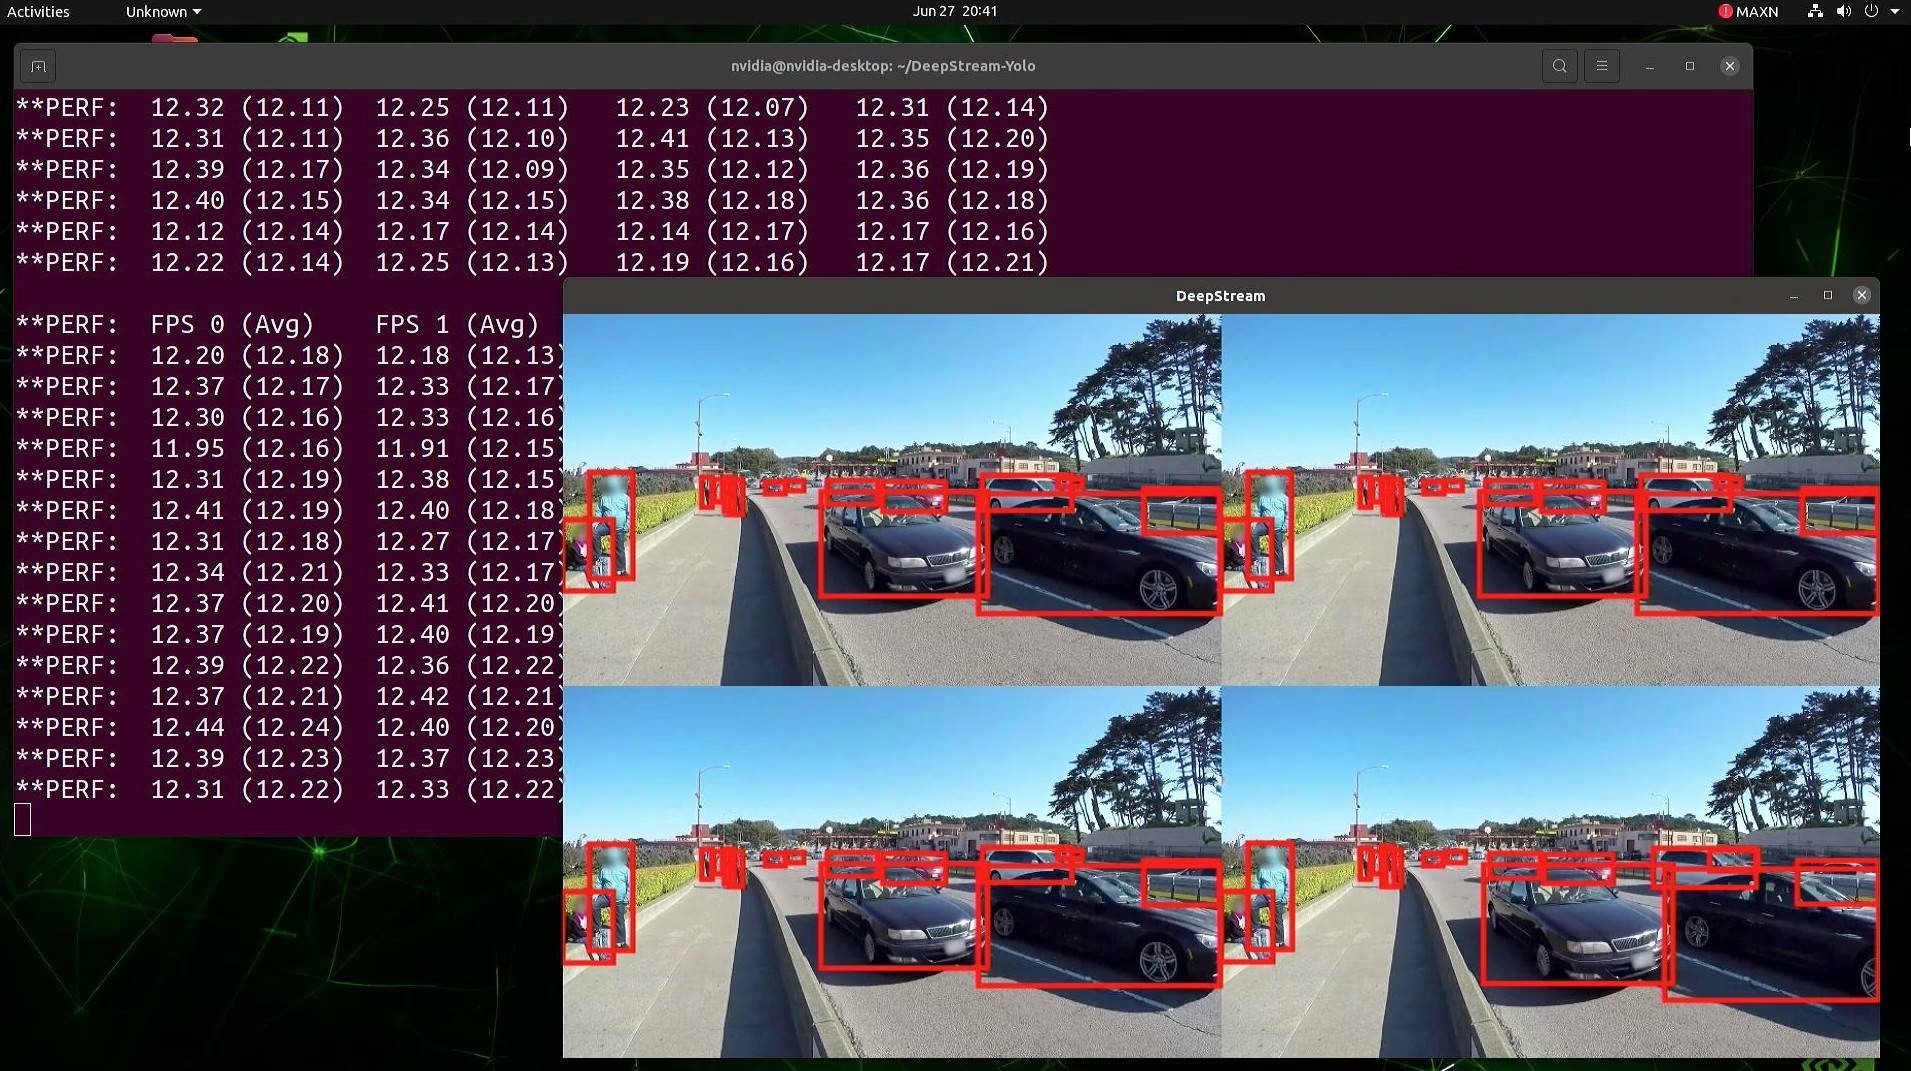
Exécute les étapes l’une après l’autre, caméra par caméra, dans un seul thread, et l’accélérateur reste inactif pendant le décodage des images. La solution consiste à séparer les étapes, comme le fait le pipeline DeepStream ci-dessus : quatre flux partagent un appareil, chacun indiquant son propre FPS (environ 12 ici). Voici la même structure en Python :
Intégré : un fichier .streams#
Ultralytics regroupe plusieurs sources en lots pour toi. Place une source par ligne dans un fichier .streams et transmets-le à Predict ou au mode Track. Chaque flux dispose de son propre thread de lecture et de son propre tracker, et chaque itération exécute une passe avant par lots sur tous les flux :
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # production : une URL rtsp:// par ligne

model = YOLO("yolo26n.pt")  # utilise ton export optimisé en production
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path indique de quel flux provient ce résultat
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Les deux flux ont produit 62 résultats, car l’itération s’arrête à la fin du flux le plus court (le clip de l’aéroport contient 150 images). stream_buffer=True a traité toutes les images, ce qui convient aux fichiers enregistrés ; pour les caméras en direct, conserve la valeur par défaut False afin qu’un modèle lent ignore les images périmées au lieu de prendre du retard. Associe cette solution à un export TensorRT ou OpenVINO pour obtenir le meilleur débit par flux.
Personnalisé : producteur-consommateur avec compteurs d’images perdues#
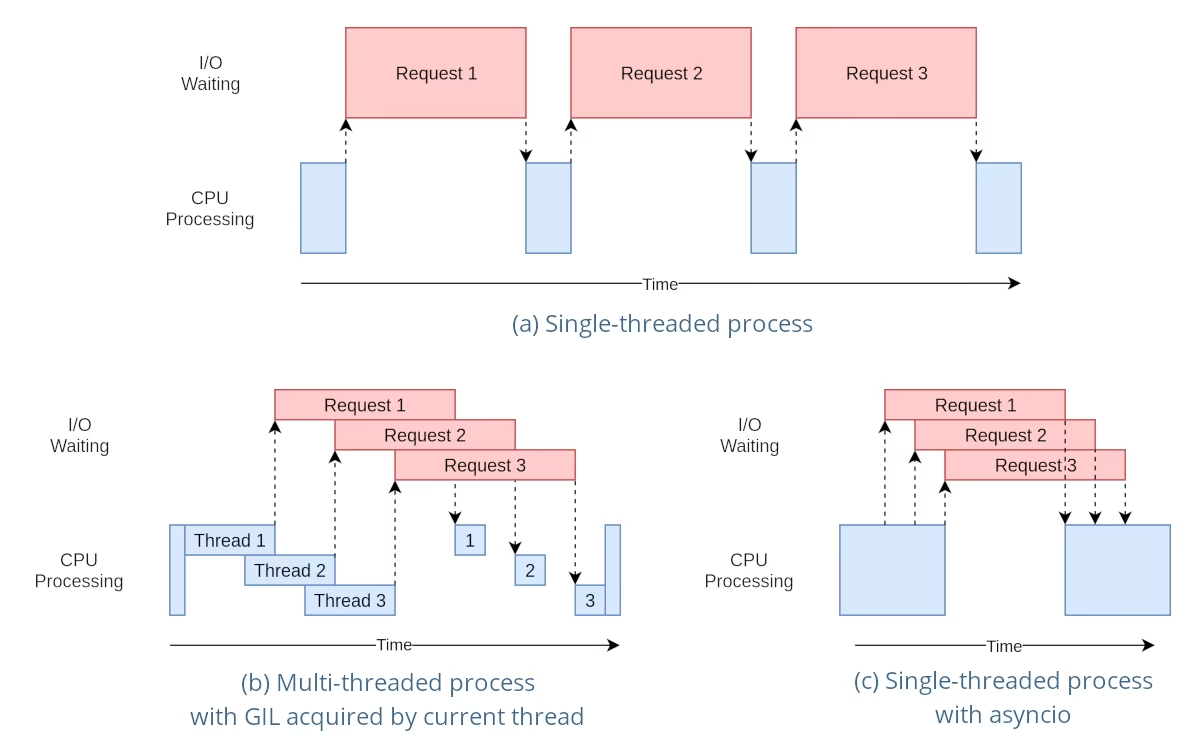
Le diagramme montre pourquoi les threads conviennent à ce pipeline. Le décodage consiste principalement à attendre (les barres roses d’E/S), et OpenCV et PyTorch libèrent le GIL de Python pendant leur exécution ; les threads de décodage se chevauchent donc efficacement (panneau b). Le post-traitement intensif en Python ne s’exécute pas en parallèle ; déplace cette tâche dans des processus distincts.
Si tu as besoin de tes propres sorties, d’une logique par caméra ou de mesures explicites des pertes, construis toi-même le pipeline. Les threads de décodage ne touchent jamais au modèle ; une boucle consommatrice unique le gère, ce qui te permet aussi de respecter les règles d’inférence thread-safe :
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]Les deux clips contiennent respectivement 62 et 150 images, et chaque image est soit traitée, soit perdue (56 + 6 = 62, 131 + 19 = 150) ; les compteurs prennent donc tout en compte. 25 images sur 212 ont été perdues : le CPU de cet ordinateur portable ne peut pas exécuter yolo26n dans PyTorch sur deux flux à 30 FPS. Voici un balayage unique qui répète les clips pour simuler davantage de caméras :
| Flux (30 FPS chacun) | Images perdues |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Dimensionner la capacité à partir des mesures#
Nombre de flux par appareil ≈ débit soutenu (nombre d’images par seconde traitées par le modèle avec la taille de lot choisie) ÷ FPS requis par flux. Mesure le débit avec l’export optimisé des leçons précédentes sur le matériel réel, garde une marge de 20 à 30 % pour les pics et déclenche une alerte dès que des pertes apparaissent. Le coût des résolutions supérieures évolue à peu près avec le nombre de pixels : 1280×1280 demande environ 4 fois plus de calcul que 640×640. Pour les grands parcs, Triton Inference Server et DeepStream sur Jetson sont des solutions de production naturelles.
Pièges#
Symptôme : model.track(["cam1.mp4", "cam2.mp4"]) traite la liste comme un lot d'images et non comme des flux. Solution : écris les sources dans un fichier .streams, à raison d'une par ligne.
Symptôme : chaque fichier ne produit qu'une ou deux images. Solution : stream_buffer=False supprime les images obsolètes, et les lecteurs de fichiers prennent de l'avance sur le modèle ; définis stream_buffer=True pour les fichiers et conserve la valeur par défaut pour les caméras en direct.
Symptôme : résultats erronés ou mélangés occasionnels sous charge. Solution : n'appelle jamais simultanément une même instance YOLO depuis plusieurs threads. Comme ci-dessus, confie-la à un seul consommateur ou crée un modèle dans chaque thread d'inférence.
Symptôme : la latence augmente chaque minute et la mémoire grimpe jusqu'à l'arrêt du processus. Solution : utilise une file d'attente limitée qui supprime des éléments lorsqu'elle est pleine, ainsi qu'un compteur de suppressions. Les systèmes temps réel doivent supprimer des images en cas de surcharge, plutôt que prendre du retard.
Afficher la solution
Fais du nombre de flux un argument de ligne de commande en ajoutant ces lignes à producer_consumer.py, juste après la ligne SOURCES :
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # nombre de caméras simulées
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Fais ensuite varier le nombre :
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]Pour cette machine, la réponse est un seul flux : les pertes commencent à deux. Pour gérer quatre caméras, exporte le modèle vers un moteur d’exécution plus rapide (leçons 3 et 4), réduis imgsz ou passe à un accélérateur, puis relance le test.