OpenVINO sur CPU
Exporte des modèles OpenVINO en FP32, FP16 et INT8, valide chacun d’eux et ne conserve INT8 que s’il apporte un gain sur ton propre CPU.
Un CPU Intel que tu possèdes déjà peut souvent remplacer une instance GPU : dans les benchmarks Ultralytics, YOLO26m passe de 192 ms dans PyTorch à 36 ms avec OpenVINO INT8 sur le CPU Core Ultra d’un ordinateur portable. Les gains dépendent toutefois de la puce ; sur l’ordinateur portable ARM utilisé pour les essais de ce cours, un export INT8 étalonné sur quatre images a perdu 3 points de mAP. Tu apprendras à déterminer lequel de ces cas s’applique avant le déploiement.
Pratique
Ce qu’apporte OpenVINO#
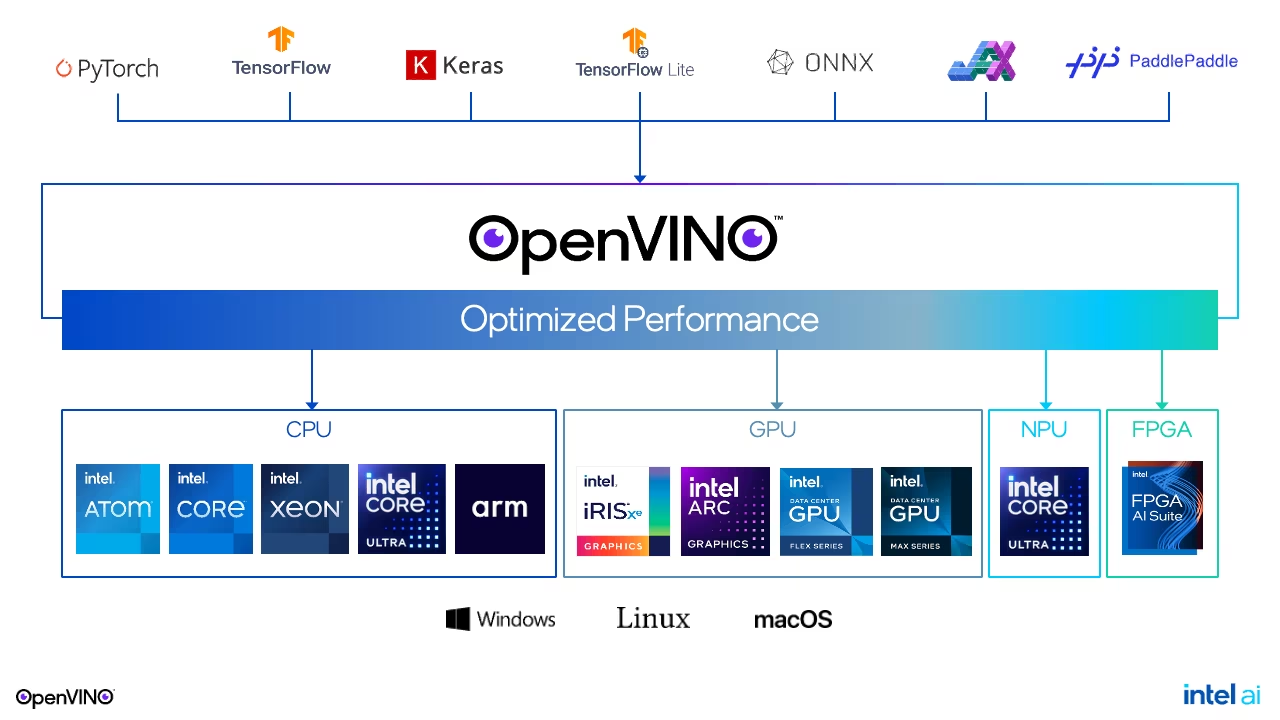
OpenVINO prend en charge les modèles PyTorch et ONNX et les exécute sur les CPU Intel, les GPU intégrés et discrets, ainsi que les NPU, via une seule API. Ses noyaux CPU ciblent les jeux d’instructions Intel (AVX2, AVX-512, AMX), et sa prise en charge d’INT8 est mature. Remarque la case ARM dans la colonne CPU : OpenVINO fonctionne aussi sur ARM, mais ses noyaux sont optimisés pour Intel ; mesure donc les performances avant de t’y fier.
Le benchmark publié sur un CPU Intel Core Ultra 7 155H (COCO128) :
| Modèle | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 FP32 → INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
Trois règles se dégagent de ce tableau :
- OpenVINO FP32 réduit à lui seul de moitié environ la latence de PyTorch sur un CPU Intel. Commence par là.
- INT8 est d’autant plus avantageux que le modèle est grand : 1,2× pour
n, 2,9× pourm, au prix de 1,2 à 1,7 point de mAP. Surn, INT8 vaut rarement le coût en précision. - Essaie le GPU intégré avant d’acheter du matériel : l’iGPU Arc (
device="intel:gpu") de la même puce a exécuté YOLO26n FP32 en 9,13 ms et YOLO26m en 34,47 ms.
Compare les précisions sur ton propre CPU#
Exporte chaque précision, valide-la immédiatement, puis seulement après exporte la suivante :
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/Ce que chaque ligne t’indique :
- FP32 et FP16 obtiennent le même score, et FP16 occupe deux fois moins d’espace (5,1 contre 9,6 Mo), mais les deux ont été enregistrés dans le même dossier. Si tu avais d’abord exporté les deux modèles avant de les valider, tu aurais mesuré deux fois FP16.
- INT8 fait 3,2 Mo et a perdu 3,2 points, car son étalonnage reposait sur les quatre images de COCO8. L’avertissement le signale : un véritable étalonnage nécessite des centaines d’images représentatives de la production issues de ton propre fichier YAML (
fractionlimite leur nombre). - Rien de tout cela ne mesure la vitesse. Pour cela, utilise le benchmark ci-dessous.
Pour exécuter un modèle exporté sur un périphérique Intel précis :
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # or intel:gpu, intel:npu
Déploie le dossier complet : yolo26n.xml (le graphe), yolo26n.bin (les poids) et metadata.yaml. intel:gpu et intel:npu nécessitent du matériel Intel.
Mesure les performances par rapport à ONNX Runtime#
La précision est établie ; la vitesse se mesure sur la cible, dans les conditions de charge réelles. Exécute pick_runtime.py de la première leçon avec CANDIDATES = ("onnx", "openvino"). Sur l’ordinateur portable de test avec puce Apple, tandis que d’autres tâches partageaient le CPU :
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO avait une meilleure médiane, mais une queue de distribution nettement plus mauvaise. Le wrapper Ultralytics compile OpenVINO avec l’indication LATENCY (le journal affiche Using OpenVINO LATENCY mode for batch=1 inference on CPU), ce qui répartit chaque requête sur les cœurs du CPU ; lorsque d’autres tâches se disputent ces cœurs, les requêtes les plus lentes en pâtissent le plus. Sur une machine Intel dédiée, les résultats sont généralement ceux publiés ci-dessus, mais seul ton propre p95 peut te renseigner.
Règles de décision :
Pièges#
Symptôme : l'export FP16 est deux fois plus petit, mais tout aussi lent. Solution : sur la plupart des CPU, le module d'extension choisit sa propre précision d'exécution ; utilise FP16 pour réduire la taille des téléchargements, et INT8 ou le GPU intégré pour accélérer.
Symptôme : FP32 et FP16 affichent des valeurs identiques, car il s'agissait du même fichier. Solution : les exports FP32 et FP16 partagent le dossier *_openvino_model/ ; valide-les (ou renomme le dossier) juste après chaque export.
Symptôme : la moyenne semble correcte, mais des images sont tout de même perdues aux périodes de forte activité. Solution : mesure le temps d'inférence avec la charge de production en cours et base-toi sur le p95, pas sur la moyenne. Pour de nombreux flux sur un même serveur, compile avec l'indication THROUGHPUT en chargeant directement .xml avec l'environnement d'exécution OpenVINO, comme l'explique le guide sur les modes latence et débit.
Sur macOS et Windows, la validation démarre des processus de travail qui réimportent ton script. Sans if __name__ == "__main__":, l'exécution de test de cette leçon a répété les exports dans ces processus, perdant ainsi plusieurs minutes et mobilisant le CPU qu'elle tentait de mesurer.
Afficher la solution
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Voici une décision concrète à partir des chiffres ci-dessus pour le Core Ultra 7 155H :
| Option | mAP50-95 | Volume | ms par image |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Déploie OpenVINO FP32 sur le GPU intégré : c’est l’option la plus rapide et elle ne fait rien perdre, tandis que l’INT8 sur le CPU coûterait 1,2 point pour gagner 2 ms. Pour un déploiement de YOLO26m, la décision s’inverse en faveur du CPU INT8 (2,9× plus rapide pour 1,7 point), si cette perte reste dans ton budget.