Réglage des coûts et de la latence
Profile l’ensemble du pipeline, actionne les leviers qui réduisent réellement la latence et les coûts, dans le bon ordre, puis arrête-toi une fois le budget atteint.
Les équipes perdent des semaines à gagner quelques millisecondes sur un modèle alors qu’une écriture en base de données ou un décodeur RTSP constitue le véritable goulot d’étranglement. Les principaux leviers sont peu nombreux et bien mesurés : YOLO26s prend 2,2 fois plus de temps que YOLO26n sur CPU pour gagner 7,7 points de mAP, et effectuer une détection une image sur deux divise la charge de travail par deux. Cette leçon t’apprend à commencer par le profilage, à actionner le levier le plus efficace qui convient et à t’arrêter au budget que tu as fixé à l’avance.
Pratique
Commencer par mesurer l’ensemble du pipeline#
Chaque objet Results répartit son propre temps en plusieurs étapes :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frameIci, l’inférence représente 95 % du temps du modèle ; les leviers liés au modèle seront donc utiles. Mesure de la même façon le décodage et tes propres opérations de sortie (ajoute time.perf_counter() autour de chacune), puis applique la règle correspondant à ton observation :
| Mesure | Priorité de correction |
|---|---|
| 60 ms de décodage RTSP, 5 ms d’inférence | Décodage matériel, résolution de flux plus faible ou davantage de threads de décodage |
| 30 ms d’inférence, 100 ms de post-traitement Python | Vectorise avec NumPy ou déplace le traitement dans un processus de travail |
| 5 ms d’inférence, 200 ms d’écritures en base de données | Regroupe les écritures ou rends-les asynchrones |
| L’inférence est prédominante | Le classement des leviers ci-dessous |
Classement des leviers#
Essaie les leviers en commençant par le premier et arrête-toi lorsque tu atteins le budget :
| Levier | Gain de vitesse typique | Coût typique en précision |
|---|---|---|
| Modèle plus petit (m → s, s → n) | 1.5–2.5× | 4,5 à 7,7 points de mAP sur COCO ; moins pour les tâches spécialisées |
imgsz plus petit (640 → 480) | environ 1,8× | Les petits objets éloignés sont les premiers touchés |
| Environnement d’exécution plus rapide, FP16 | environ 1,5× sur GPU | Généralement aucun ; vérifie la parité |
| INT8 avec calibration | 1,2× supplémentaire sur GPU ; jusqu’à 2,9× sur CPU | 1 point (YOLO26n) à 4–6 points (modèles plus grands) ; QAT permet d’en récupérer la majeure partie |
Moins d’images (vid_stride=N) | jusqu’à N× | Les objets rapides et les événements brefs peuvent passer inaperçus |
| Taille de lot supérieure (serveurs) | Débit supérieur, mais pas latence plus faible | Aucun |
Les chiffres proviennent des tableaux de référence YOLO26, TensorRT et OpenVINO, ainsi que des mesures ci-dessous ; les tiens seront différents, alors mesure.
Modèle plus petit#
Le tableau de référence YOLO26 sur COCO :
| Modèle | mAP50-95 | Latence CPU ONNX (ms) | Latence T4 TensorRT10 (ms) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
Sur CPU, chaque réduction d’un niveau accélère le traitement de 2,2 à 2,5×. L’écart de précision sur COCO représente le pire des cas : un détecteur d’entrepôt à 3 classes avec de grands objets perd généralement beaucoup moins en passant de m à n qu’un détecteur généraliste à 80 classes. Le modèle plus petit mérite donc toujours d’être testé sur ton propre jeu de validation.
Entrée plus petite#
La charge de calcul évolue approximativement avec le nombre de pixels ; imgsz=480 nécessite donc environ 56 % du travail requis en 640. Mesures effectuées sur le CPU de l’ordinateur portable de test, avec ONNX Runtime et une taille de lot de 1 (médiane de 25 exécutions sur bus.jpg) :
| Modèle | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
Règle de décision : si ton plus petit objet important couvre encore environ 10 pixels ou plus à la nouvelle taille, essaie-la ; si les objets sont petits ou éloignés (drones, étagères éloignées de la caméra), conserve la résolution et réduis plutôt la taille du modèle.
Moins d’images#
Si l’inférence limite ta fréquence d’images et que la scène évolue lentement, effectue une détection toutes les N images avec vid_stride=N et laisse le suivi combler les intervalles :
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDsTraiter la moitié des images prend environ deux fois moins de temps, et le suivi a conservé 30 des 32 identités. À vid_stride=3, il en a perdu 4 : c’est le signal qu’il faut s’arrêter pour cette scène à allure de marche.
Réduire les coûts du cloud#
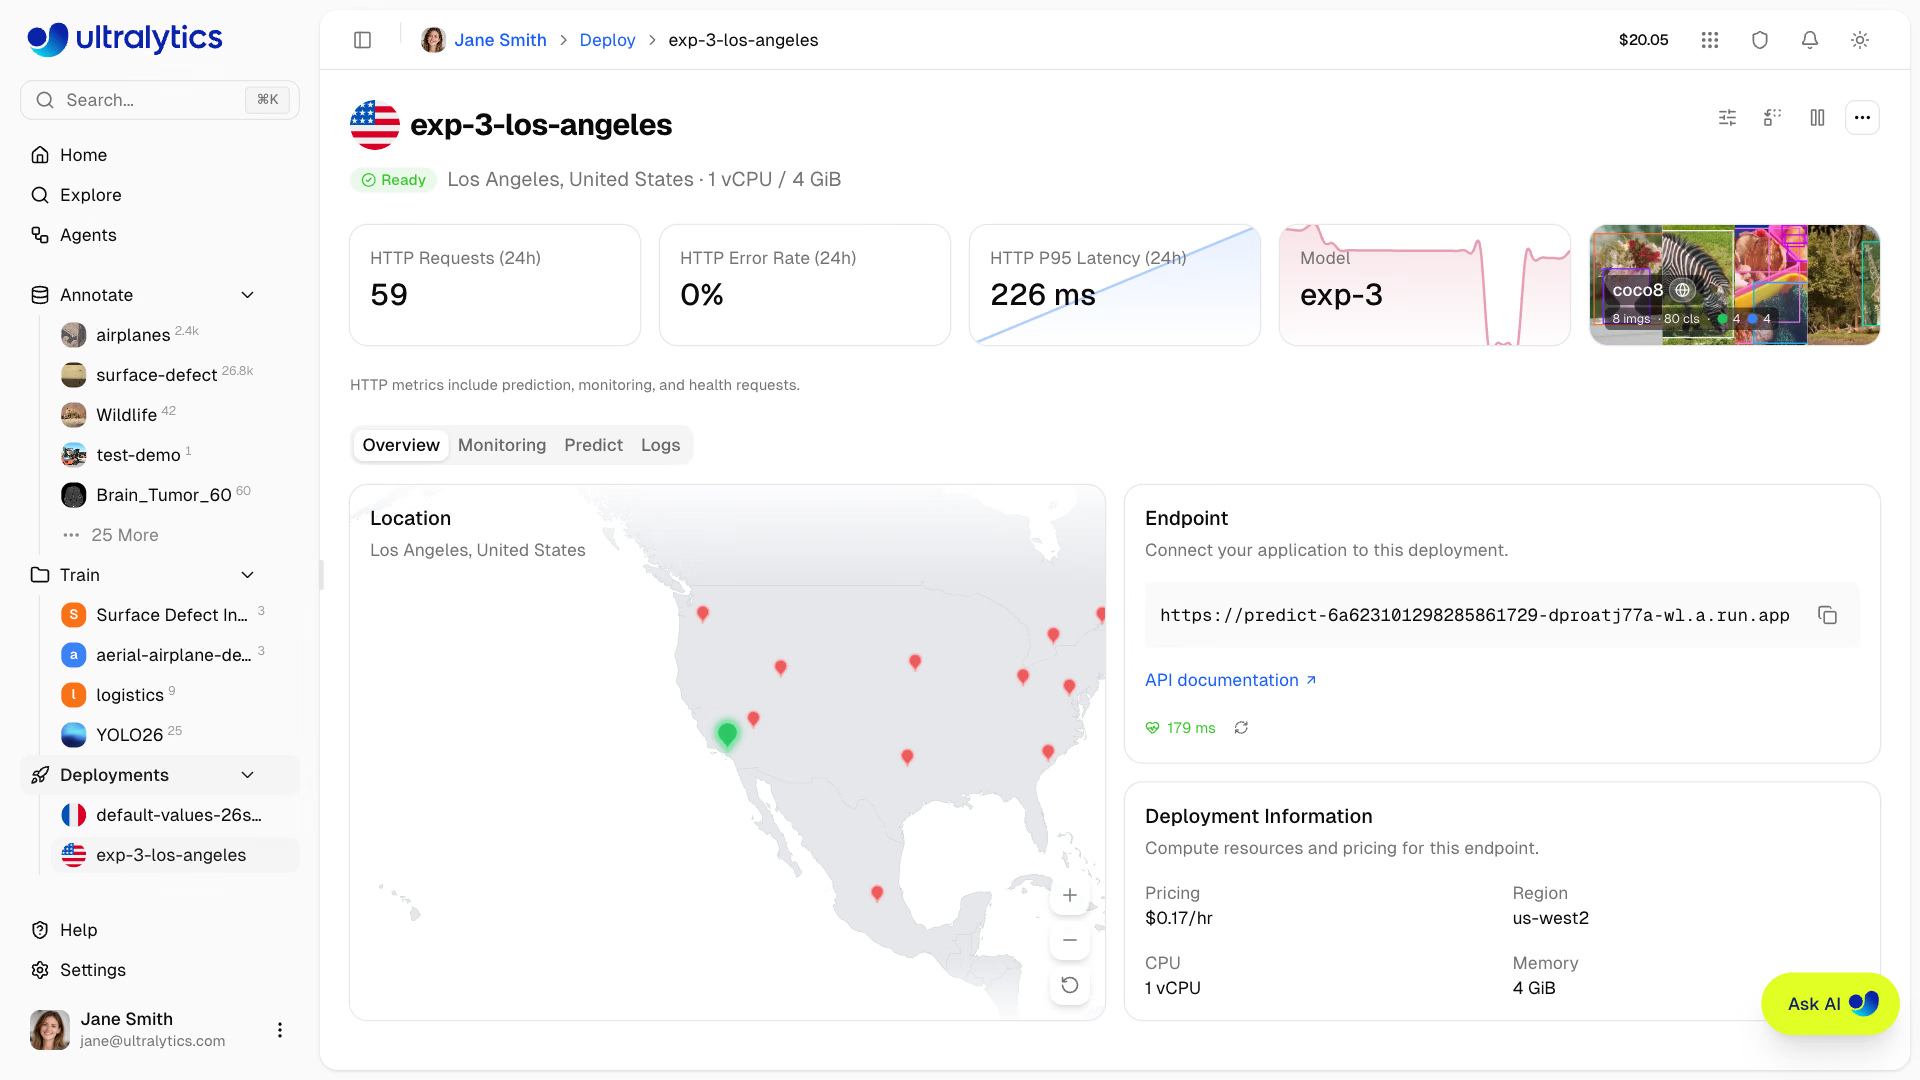
Le coût correspond aux heures d’instance divisées par le travail utile. Une fiche comme celle-ci contient les deux chiffres dont tu as besoin : le coût horaire (0,17 $ pour 1 vCPU et 4 Gio ici) et la quantité de travail effectuée (59 requêtes en 24 heures à une latence P95 de 226 ms ; le point de terminaison est donc presque inactif). Ensuite :
- Augmente le taux d’utilisation. Un GPU utilisé à 30 % gaspille 70 % de ta facture. Regroupe les flux en lots (voir les leçons précédentes) ou sers-les avec Triton Inference Server.
- Choisis une taille adaptée. Évalue les performances sur un GPU plus petit ou sur un CPU avec OpenVINO avant de supposer qu’il t’en faut un grand.
- Utilise une capacité préemptible ou à la demande pour les traitements par lots. Le retraitement de vidéos archivées tolère les interruptions ; les flux en direct, non.
Pièges#
Symptôme : deux semaines de réglages ont fait gagner 10 ms, et le système reste lent. Solution : commence par profiler l'ensemble du pipeline et corrige l'étape la plus lente, quelle qu'elle soit.
Symptôme : if i % 2: continue dans la boucle des résultats ne permet aucune économie. Solution : le modèle a déjà traité cette image ; ignore-la à la source avec vid_stride.
Symptôme : le débit a augmenté, mais chaque image arrive plus tard. Solution : des lots plus grands augmentent le débit par dollar, pas la latence par image ; utilise-les pour de nombreux flux ou des tâches hors ligne, pas pour une seule caméra en temps réel.
Lorsque tu as épuisé les leviers liés au modèle, l'amélioration des données est la prochaine piste. Un jeu de données qui correspond à la production permet à un modèle plus petit d'atteindre la précision qu'exigeait un modèle plus grand : une réduction des coûts sans perte de précision.
Afficher la solution
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
Chaque ligne écarte les cinq premières exécutions comme phase de chauffe et indique la médiane des autres. Choisis la première ligne qui respecte le budget de latence tout en maintenant la perte de mAP dans les limites de ton budget. Exemple de budget détaillé : « deux jours, au maximum 1 point de mAP, 20 FPS sur le serveur du magasin ». Si yolo26s en 640 dépasse 50 ms par image et que yolo26n en 640 respecte cette limite avec une perte inférieure ou égale à 1 point sur ton jeu de validation, arrête-toi là ; ne consacre pas la deuxième journée à la résolution 480.