Optimiser avec TensorRT
Crée un moteur TensorRT FP16, décide si INT8 vaut son coût en précision et soumets le moteur à un contrôle avant le déploiement.
Sur un GPU NVIDIA, un moteur TensorRT FP16 est généralement le gain de vitesse le plus facile à obtenir : environ 1,5× plus rapide dans le benchmark Ultralytics sur A100, sans changement de mAP. INT8 va plus loin, mais l’INT8 après entraînement a coûté de 4 à 6 points de mAP à YOLO26s à YOLO26m sur COCO. Cette leçon t’apprend à savoir quelle étape tu entreprends et à la mesurer avant tes utilisateurs.
Pratique
Le code de cette leçon nécessite un GPU NVIDIA avec TensorRT installé. Chaque argument présenté est répertorié pour format=engine dans la documentation du mode d'export.
FP16 est la première étape la plus sûre#
Les GPU NVIDIA à partir de Volta disposent de cœurs tenseurs FP16, et les modèles de détection ont rarement besoin de FP32 à l’inférence. Commence ici :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # Moteur FP16, espace de travail du constructeur jusqu'à 4 Gio
workspace limite la mémoire GPU que TensorRT peut utiliser pendant la création ; laisse ce paramètre vide pour laisser TensorRT décider. La page d’intégration TensorRT publie ce résultat sur A100 (YOLOv8n, 640 px) :
| Précision | Prédiction, lot de 8 (ms) | mAP50-95 sur COCO val |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
Le modèle est plus ancien que YOLO26, mais la tendance du compromis reste valable : FP16 était environ 1,5× plus rapide sans coût ; INT8 a apporté un gain supplémentaire de 1,2× pour un coût de 4 points. Si FP16 respecte ton budget, déploie-le.
Tu n’as pas de GPU NVIDIA local ? L’onglet Export de la plateforme Ultralytics crée le moteur sur le GPU cloud de ton choix, avec les mêmes options de taille d’image, précision, lot, mode dynamique, NMS et espace de travail :

Choisis la famille de GPU sur laquelle tu vas déployer : le moteur de la capture d’écran a été créé sur un RTX 5090 et ne fonctionnera que sur cette famille.
INT8 nécessite des données d’étalonnage#
La quantification INT8 mappe les activations de chaque couche sur 256 niveaux. Pour déterminer ces plages, l’exporteur fait passer des images d’étalonnage dans le modèle et enregistre les activations observées ; ces images doivent donc ressembler aux données de production :
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # les images d’étalonnage proviennent de la partition val de ce jeu de données ; utiliser my_dataset/data.yaml
    fraction=1.0,  # part ou nombre de ces images à utiliser
    batch=8,  # des lots d’étalonnage plus importants donnent des plages plus stables
    dynamic=True,  # avec batch=8, le moteur accepte des lots de 1 à 8
    workspace=4,
)
Le coût d’INT8 dépend du modèle. La documentation du mode Export a mesuré les moteurs TensorRT YOLO26 sur COCO val (mAP50-95) :
| Modèle | Moteur FP32 | INT8, étalonné (PTQ) | INT8 après entraînement conscient de la quantification (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
L’étalonnage seul coûte 1 point à YOLO26n et de 4 à 6 points aux modèles plus grands. Le QAT affine le modèle avec quantize=8 dans train afin que ses poids tolèrent INT8 ; le point de contrôle contient ses propres plages, son export INT8 ne nécessite pas de données d’étalonnage et son score est à 1 ou 2 points de celui de FP32. Voici comment prendre ta décision :
Soumets le moteur à un contrôle avant le déploiement#
Chaque moteur doit réussir les mêmes contrôles sur le GPU de déploiement :
| Vérification | Contrôle |
|---|---|
| mAP50-95 sur ton jeu de validation | À moins de 0,5 point de FP32 pour FP16 ; dans les limites de ton budget écrit pour INT8 |
| AP par classe | Aucune classe ne perd plus d’environ 1 point (les petites classes varient le plus) |
| Latence p95 | Sous le budget avec la taille de lot utilisée en production |
| Seuil opérationnel | conf recalculé à partir de la propre courbe F1 du moteur |
| Déterminisme | La même image donne exactement les mêmes boîtes deux fois de suite |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
D’où vient le gain de vitesse#
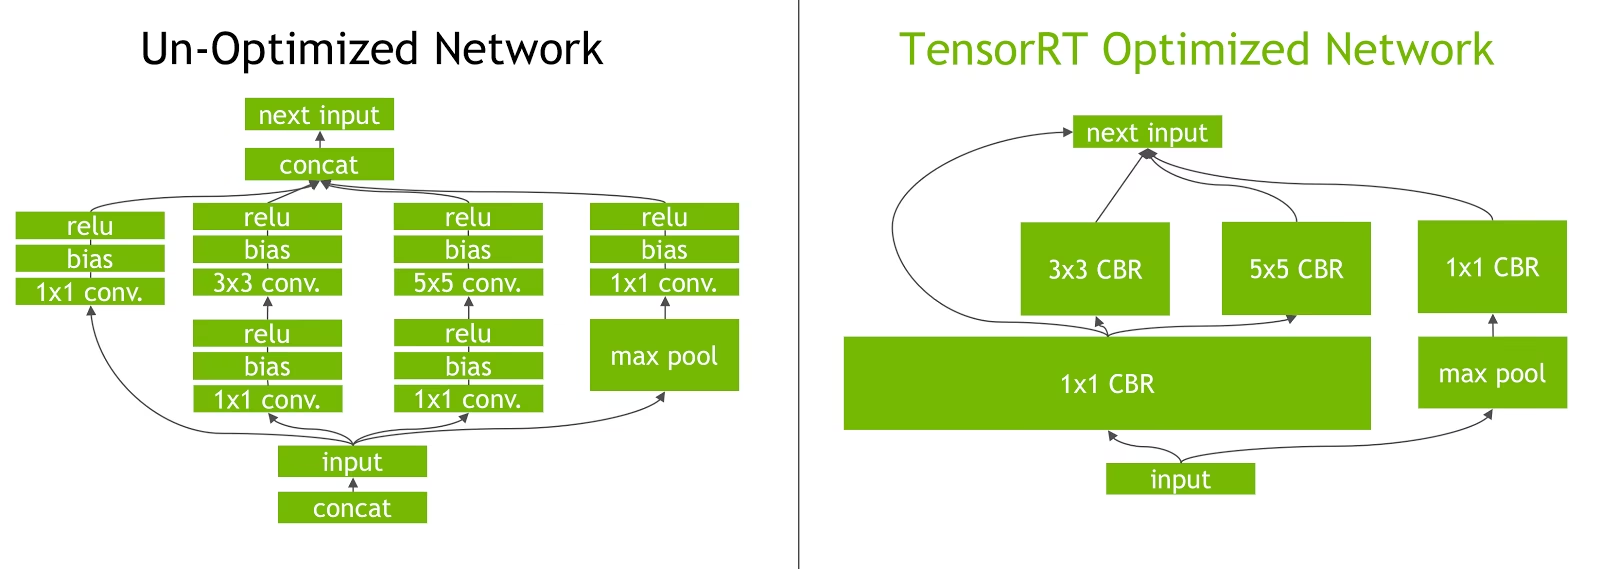
TensorRT fusionne chaque convolution, biais et ReLU dans un seul noyau (les blocs « CBR » à droite) et supprime les étapes de concaténation, ce qui réduit considérablement le nombre de noyaux lancés par le GPU et la quantité de données transférées. Dans YOLO26, cela accélère les chaînes conv-BN-activation présentes dans tout le réseau, le bloc d’attention (PSA) du backbone et les nombreuses petites opérations de la tête de détection. Si un moteur reste lent, profile-le avec trtexec ou NVIDIA Nsight : une seule couche prend souvent 30 % ou plus du temps.
Pièges#
Symptôme : INT8 perd 1 point sur COCO et 6 sur tes caméras. Solution : calibre avec une partie mise de côté de ton jeu de validation ; NVIDIA recommande au moins 500 images représentatives. Le calibrage varie également selon les appareils : effectue-le donc sur le GPU cible du déploiement.
Symptôme : le rappel baisse après le passage à INT8 avec la même valeur conf. Solution : INT8 peut modifier les valeurs de confiance ; choisis à nouveau conf à partir de la propre courbe F1 du moteur INT8.
Symptôme : le moteur ne peut pas être désérialisé ou s'exécute plus lentement que prévu sur la machine de déploiement. Solution : crée-le sur la famille de GPU de déploiement avec des versions compatibles de TensorRT et de l'environnement d'exécution CUDA, puis livre .onnx pour que les appareils puissent recompiler. Si le calibrage échoue pendant la compilation, augmente workspace ou diminue imgsz ou batch.
Sur Jetson, DeepStream exécute les moteurs obtenus dans un pipeline vidéo accéléré matériellement ; dans un centre de données, Triton Inference Server les met à disposition.
Afficher la solution
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
Un rapport satisfaisant indique : écart inférieur à 0,5 point, p95 sous le budget, décision déployer FP16. Si le p95 dépasse le budget, exporte en INT8 avec ton propre fichier YAML d’étalonnage, relance les deux mêmes lignes et ne déploie INT8 que si l’écart reste dans les limites du budget défini au préalable ; sinon, essaie le QAT ou un modèle plus petit.