Organiser, dédoublonner et partitionner
Repère les doublons entre partitions et les lacunes de classes avec deux scripts courts, partitionne selon l’unité qui compte et fige une version auditée du jeu de données.
La fiabilité d’un score de validation dépend de celle de la partition. COCO128, un jeu de données de démonstration populaire, utilise intentionnellement les mêmes 128 images pour l’entraînement et la validation. Si la même erreur se glisse dans tes propres données, tu obtiens un « excellent » modèle qui échoue dès qu’il voit la caméra suivante. Cette leçon effectue deux audits sur des données réelles : une vérification des doublons et un audit des classes par partition. Elle répartit ensuite les données par caméra et fige une version ayant réussi les deux vérifications.
Pratique
Exemple détaillé : repérer les images partagées entre partitions#
La plateforme conserve une seule copie d’une image par partition et te demande comment gérer les collisions lors du téléversement, mais rien n’empêche une même image ou scène de se retrouver à la fois dans l’entraînement et la validation. Vérifie avant le téléversement, puis de nouveau après la fusion des jeux de données :
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']Toutes les images de validation de COCO128 sont aussi des images d’entraînement. C’est intentionnel pour un jeu de données de test rapide, et c’est exactement pourquoi son mAP de validation ne dit rien sur la capacité de généralisation. Dans tes données, tout décompte non nul signale une fuite : déplace ou supprime une copie de chaque image avant l’entraînement.
Repérer les quasi-doublons avec Clustering#
Les hachages ne détectent que les octets identiques. Les images vidéo consécutives, les photos en rafale et les copies réencodées diffèrent de quelques pixels. Ouvre l’icône de nuage de points dans la barre d’outils de la galerie et clique sur Analyze Dataset (de 20 à 200 000 images, jeux de données téléversés uniquement) :
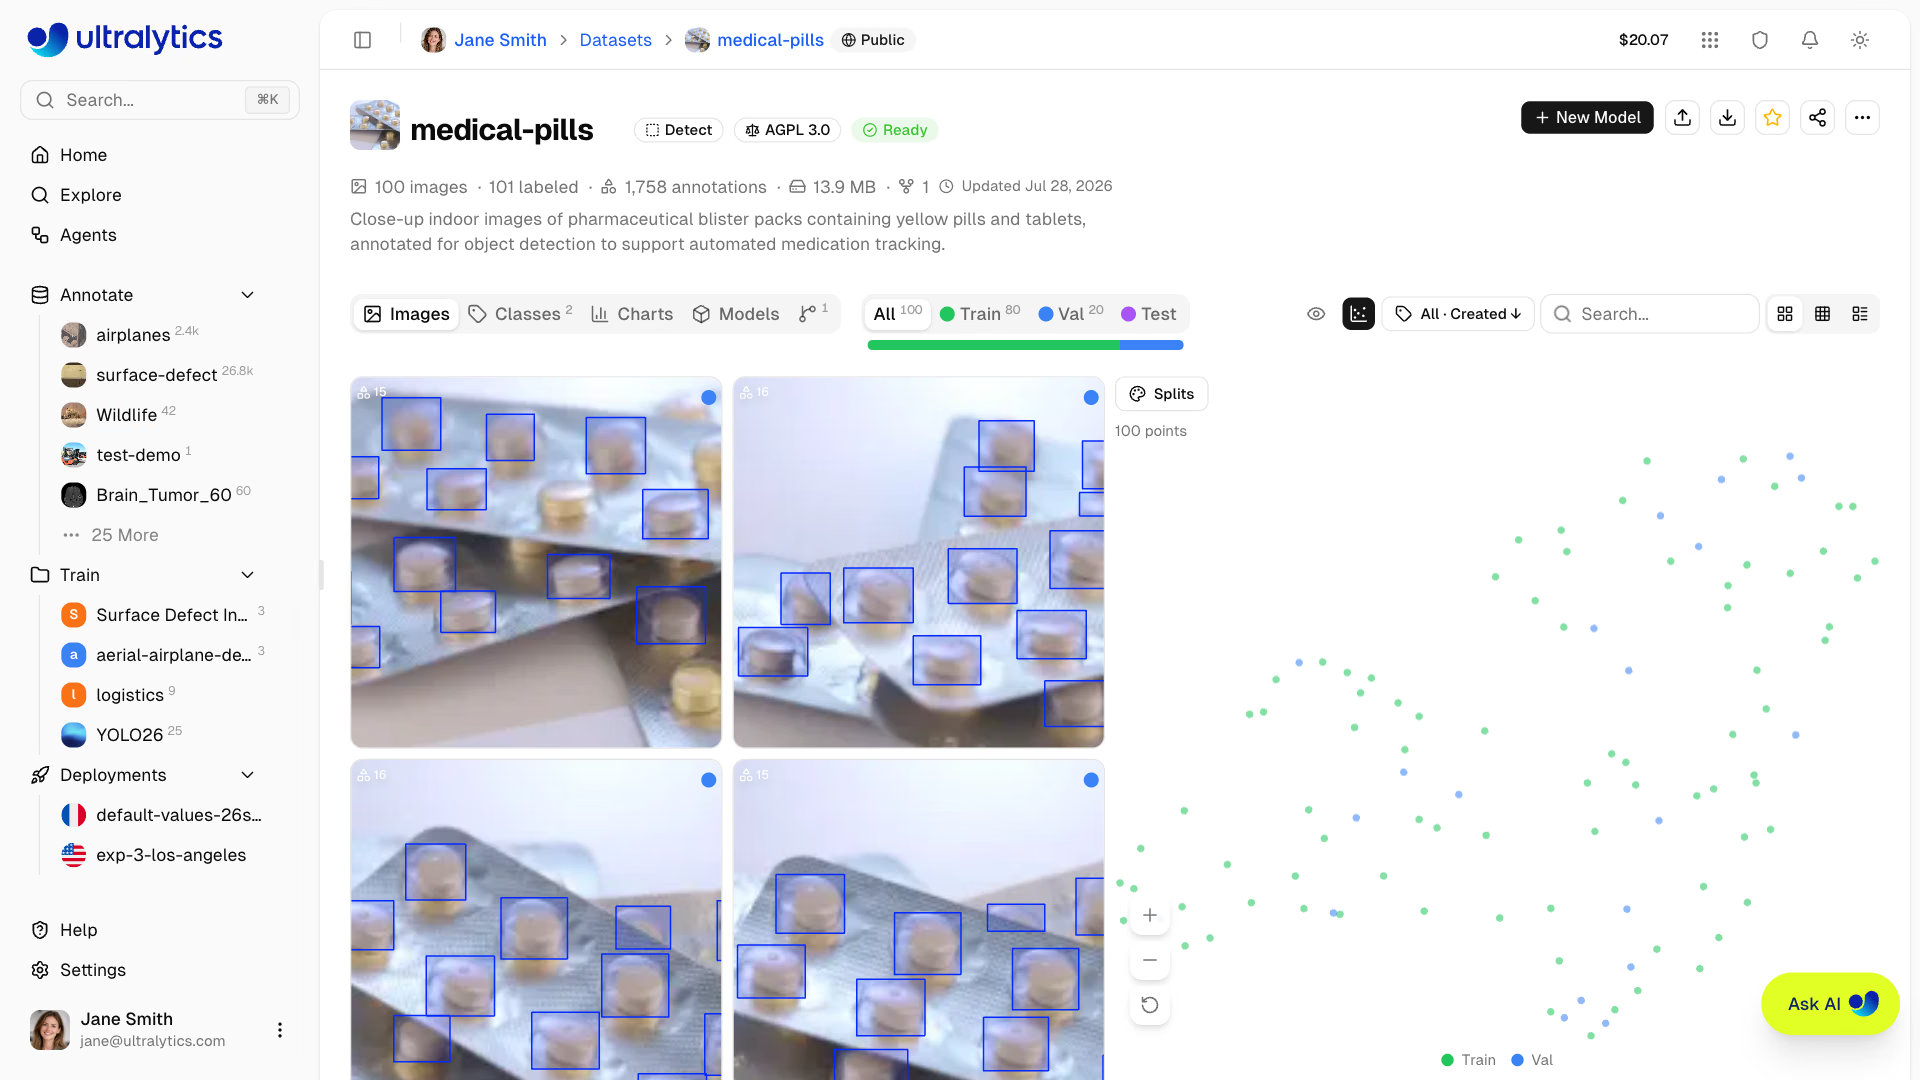
- Colorer par partition : un îlot compact qui mélange des points d’entraînement et de validation signale une fuite de quasi-doublons.
- Colorer par clusters ou classes : un grand îlot d’une seule classe révèle ce que le jeu de données surreprésente ; les points isolés sont des valeurs aberrantes (mauvaise caméra, image corrompue, image mal étiquetée).
- Trace un lasso ou clique sur une région pour filtrer la galerie et n’afficher que ces images (jusqu’à 1 000), puis supprime-les, déplace-les ou réétiquette-les.
Les mêmes plongements alimentent Rechercher des images similaires dans le menu contextuel d’une image. Cette fonction ajoute à train des images similaires provenant de jeux de données publics et d’équipe, sans étiquette : le moyen le plus rapide de combler une lacune repérée par l’audit ci-dessous.
Exemple détaillé : auditer les classes par partition#
Télécharge l’export NDJSON depuis l’en-tête du jeu de données ou l’onglet Versions. Chaque ligne suivant l’en-tête correspond à une image, avec sa partition et ses étiquettes ; quelques lignes de Python suffisent donc à compter chaque classe dans chaque partition. Voici l’exécution sur l’export public COCO8 :
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valInterprétation : la ligne d’en-tête contient class_names ; chaque boîte de détection est un [class, x, y, w, h]. Absente de l’entraînement signifie que le modèle ne peut pas du tout apprendre la classe et que son AP de validation sera nul. Trop peu d’instances dans la validation signifie que son AP variera fortement d’une exécution à l’autre : avec 7 palettes dans la validation, une palette manquée fait varier l’AP des palettes d’environ 14 points. COCO8 est un test rapide sur 8 images, donc toutes les classes échouent ; ta version de production ne devrait afficher aucun signalement. Comble les lacunes en collectant davantage d’exemples, pas en réglant les paramètres.
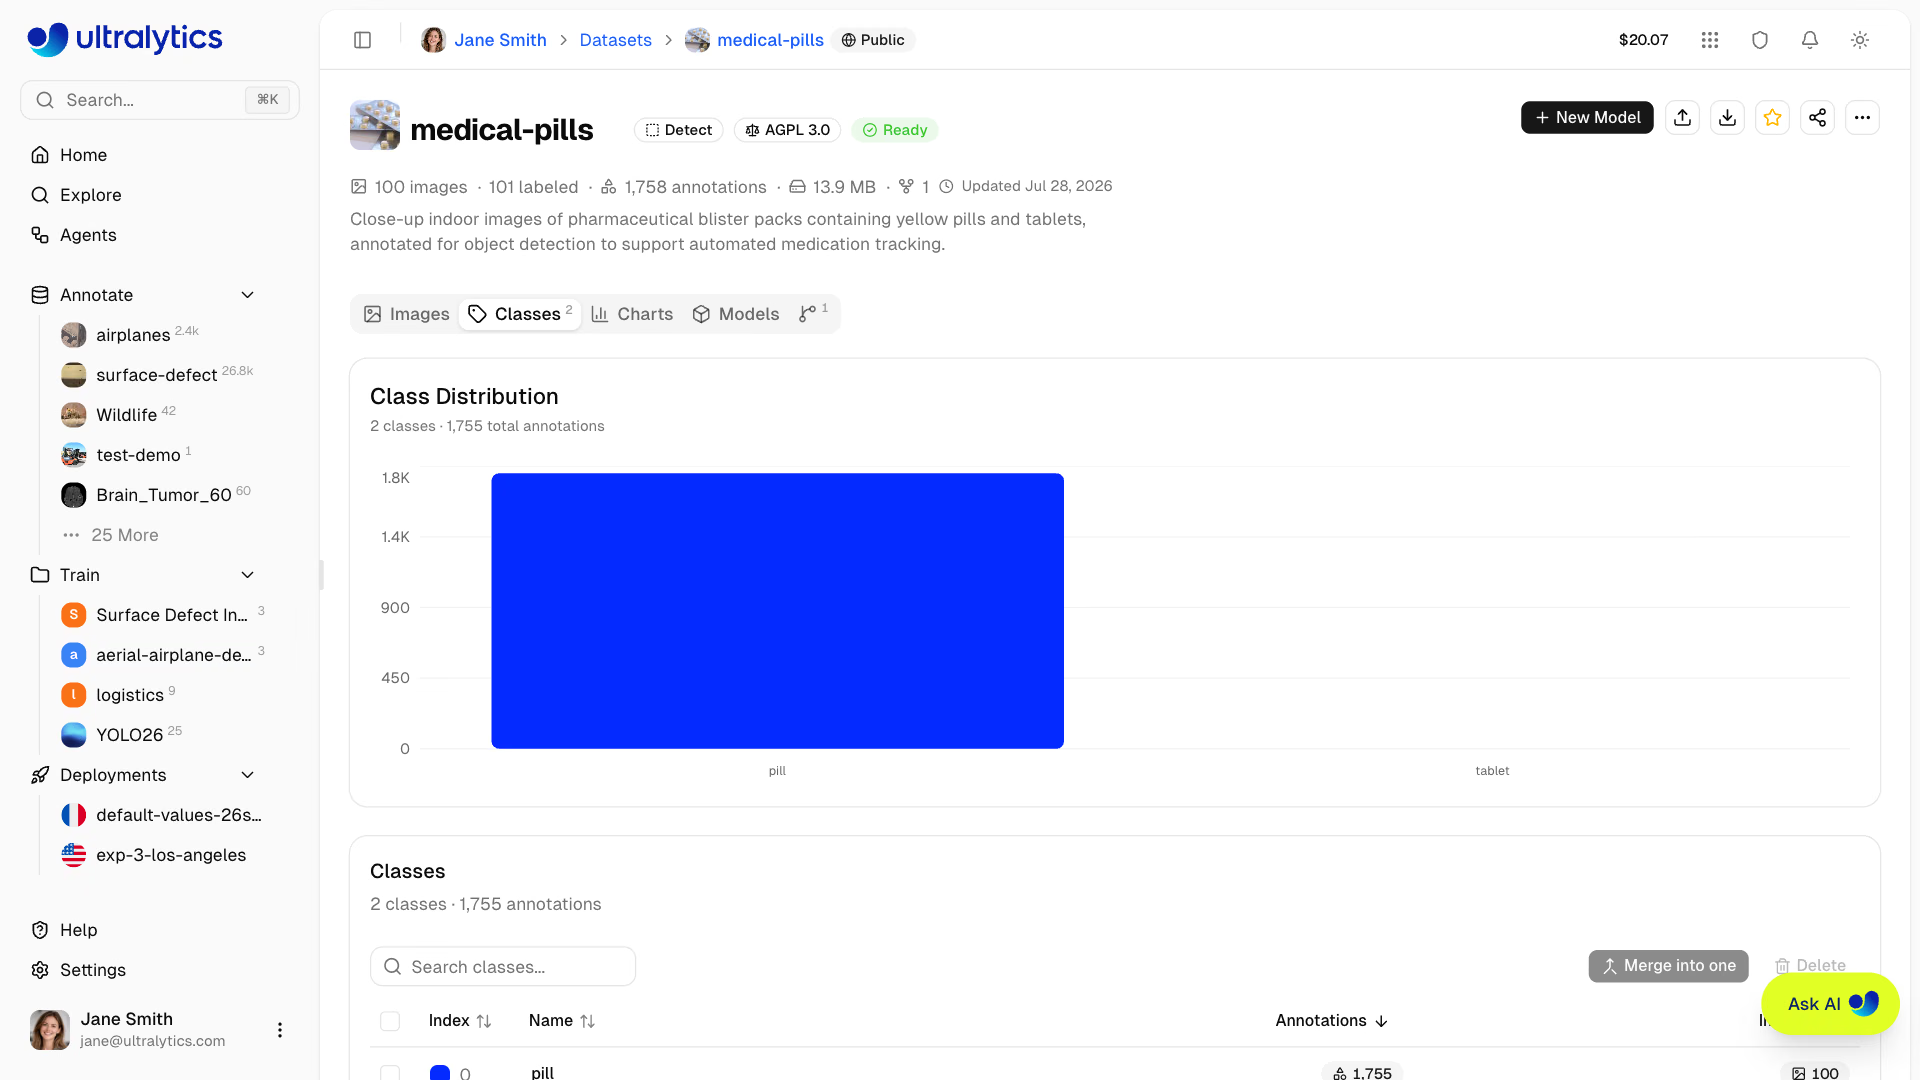
L’onglet Classes affiche les mêmes décomptes pour le jeu de données actif, avec une option d’échelle logarithmique pour les données déséquilibrées. Fusionner en une seule classe regroupe les doublons tels que car, automobile et vehicle dans une seule classe, sans perdre d’annotations ; Supprimer élimine une classe et toutes ses annotations.
Partitionner selon l’unité sur laquelle tu veux généraliser#
Les images d’une même caméra, session ou journée sont corrélées. Si elles figurent à la fois dans l’entraînement et la validation, le modèle est évalué sur des scènes qu’il a déjà vues. Réserve des unités entières correspondant aux variations en production : si tu utilises de nouvelles caméras, réserve certaines caméras ; si tu utilises les mêmes caméras à de nouvelles dates, réserve certaines journées.
Les outils de partitionnement de la plateforme se distinguent précisément sur ce point :
| Outil | Méthode d’attribution | Utilisation |
|---|---|---|
Dossiers train/, val/, test/ dans un téléversement | Conserve ton attribution | Partitions de groupes préparées hors ligne |
| Filtre de partition défini avant le téléversement | Tous les fichiers de ce téléversement sont affectés à la partition sélectionnée | Téléversement d’une caméra par partition |
| Déplacer vers la partition dans la vue Tableau | Déplace les images sélectionnées | Correction d’images spécifiques |
| Barre des partitions, Redistribuer les partitions | Réattribue aléatoirement toutes les images | Photos indépendantes uniquement |

La leçon Partitionner correctement le jeu de données traite du choix de l’unité ; pour les très petits jeux de données, la validation croisée k-fold permet de tirer davantage d’informations des données. Pour vérifier les groupes après le téléversement, ajoute une clé de groupe à l’audit des classes (par exemple record["file"].split("_")[0] pour les fichiers nommés cam07_000123.jpg, ou un champ camera dans les métadonnées des images) et signale tout groupe présent dans deux partitions.
Figer une version ayant réussi les vérifications#
L’entraînement nécessite un instantané fixe. Dans l’onglet Versions, saisis une description (« v5 : cam07 réservée, +80 images de palettes »), puis clique sur Nouvelle version. Chaque version est un instantané NDJSON numéroté et immuable que tu peux télécharger, comparer ou restaurer ; la boîte de dialogue d’entraînement propose la même opération au lancement avec Enregistrer la version du jeu de données et réutilise une version correspondante si rien n’a changé. Les versions ne sont pas disponibles pour les jeux de données connectés au cloud ou sur site.
Pièges#
Symptôme : après avoir cliqué sur Auto pour répartir les données à 80/20, le mAP de validation bondit, mais pas la précision en production. Correctif : Redistribuer les partitions réattribue aléatoirement chaque image (et supprime au passage les doublons exacts), plaçant des images voisines dans les partitions d’entraînement et de validation. Utilise des dossiers de téléversement ou Déplacer vers la partition pour les données regroupées.
Symptôme : un ancien export ou les prédictions d’un modèle portent soudain les mauvais noms de classe. Correctif : les ID de classe sont déterminés par leur position ; fusionner ou supprimer une classe décale donc tous les index supérieurs d’une position. Crée une version avant tout changement de classe et réentraîne le modèle plutôt que de réutiliser d’anciens fichiers d’annotations.
Symptôme : un nouvel entraînement obtient un score inférieur de 5 points, alors que rien d’autre n’a changé. Correctif : les métriques ne sont comparables que sur la même partition. Lorsque tu modifies la partition, note-le dans la description de la version et relance l’évaluation de référence sur la nouvelle version avant toute comparaison.
Afficher la solution
Exemple de réponse pour un jeu de données de chariots élévateurs filmés par 8 caméras. La vérification des doublons trouve 41 images identiques entre l’entraînement et la validation, toutes provenant d’un dossier retéléversé ; supprime les copies de validation. L’audit, complété par group = record['file'].split('_')[0], indique que cam02 apparaît dans l’entraînement et la validation. Sélectionne donc ses images de validation dans la vue Tableau, puis choisis Déplacer vers la partition > Entraînement. L’audit signale aussi pallet: train 63, val 7, too few in val : utilise Rechercher des images similaires sur deux images de palettes pour ajouter 40 images similaires non étiquetées, étiquette-les et déplace 15 images de palettes de cam07 vers la validation afin que cam07 reste dans une seule partition. Relance les vérifications : 0 doublon, 0 groupe en fuite, 22 palettes dans la validation. Les clusters colorés par partition ne montrent aucun îlot mixte. Enregistre v5: cam07 val, cam08 test, +40 pallets.