Comparer des exécutions et choisir la meilleure
Compare des exécutions dans un projet Platform, consigne la raison d’être de chacune et détermine si un candidat doit être déployé à l’aide d’un script de validation avant promotion.
Les modèles plus grands obtiennent généralement une meilleure métrique principale, puis échouent sur une classe que personne n’a vérifiée. Sans règle définie à l’avance, l’exécution déployée est simplement celle que quelqu’un préfère. Cette leçon consigne chaque exécution pour qu’on puisse retrouver son raisonnement plus tard, et transforme « est-ce mieux ? » en un script de validation qui renvoie PASS ou FAIL.
Pratique
Comparer des exécutions dans un projet#
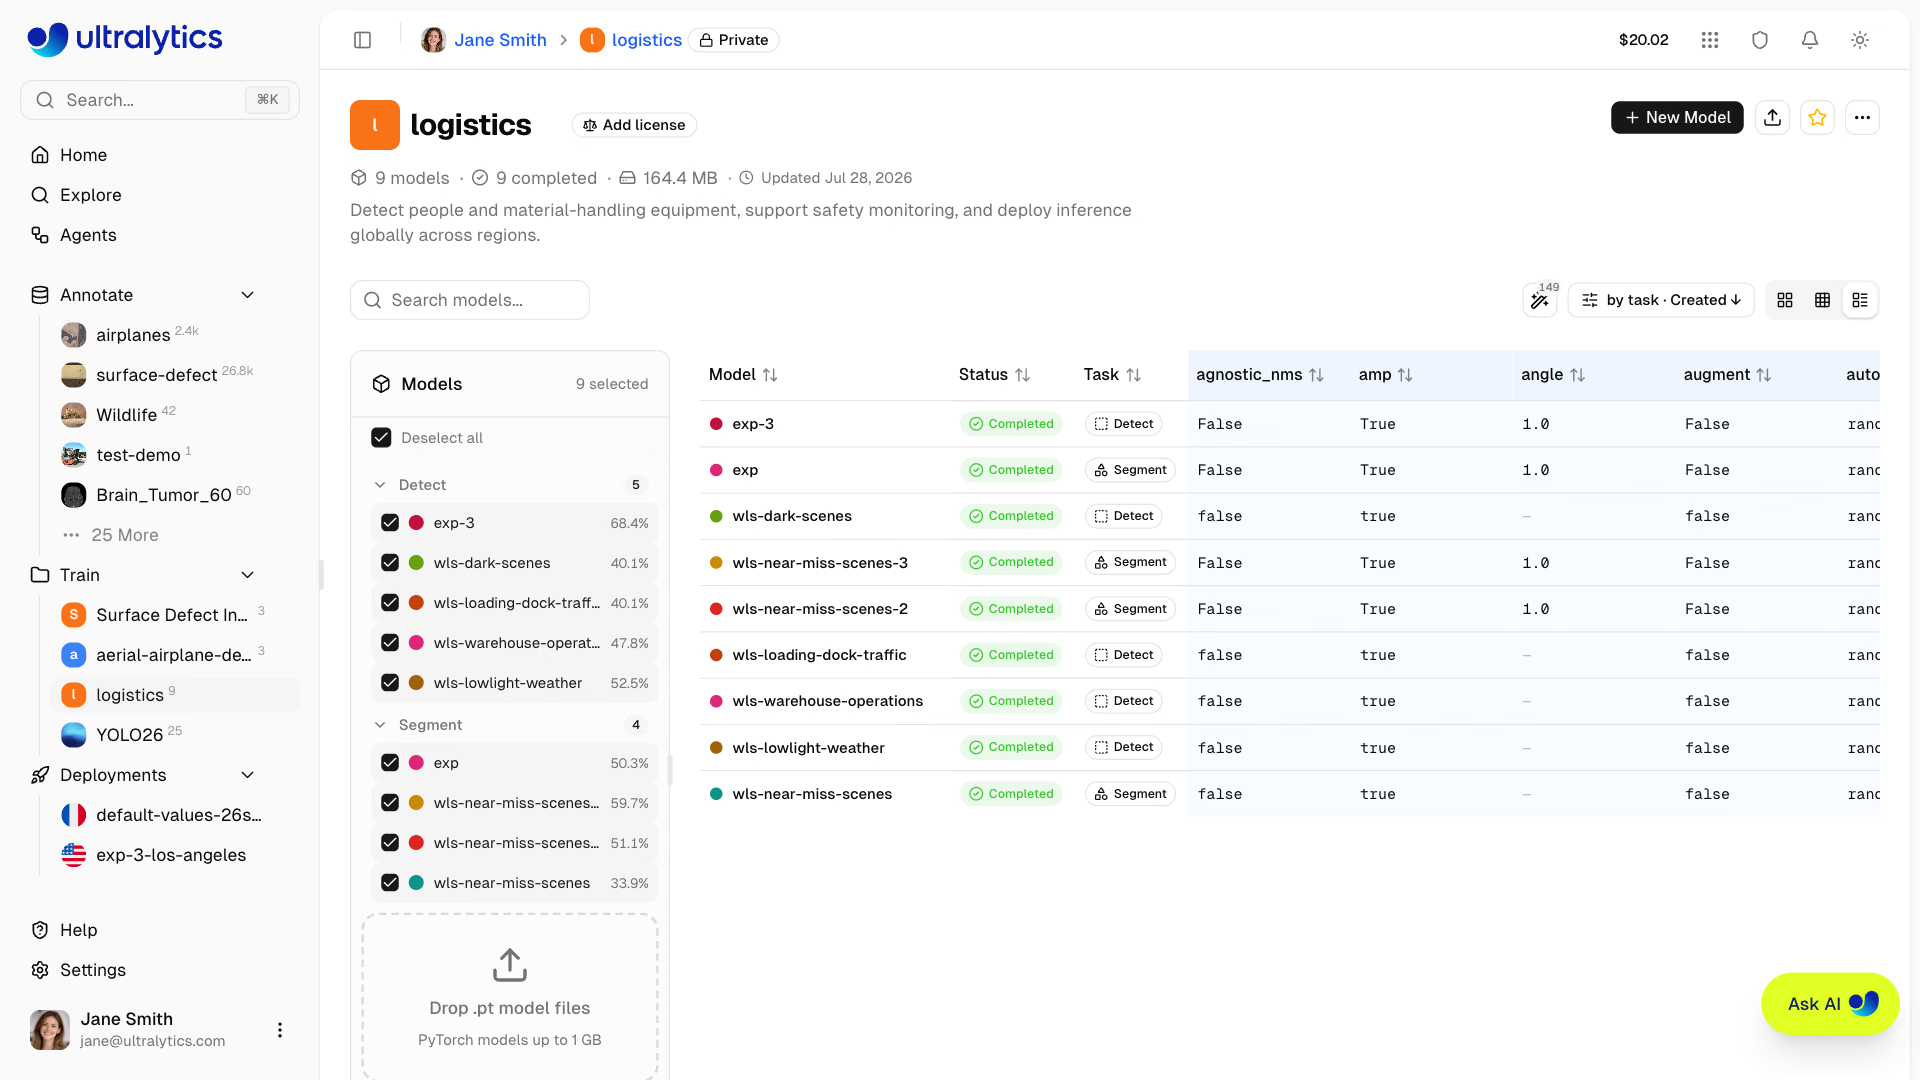
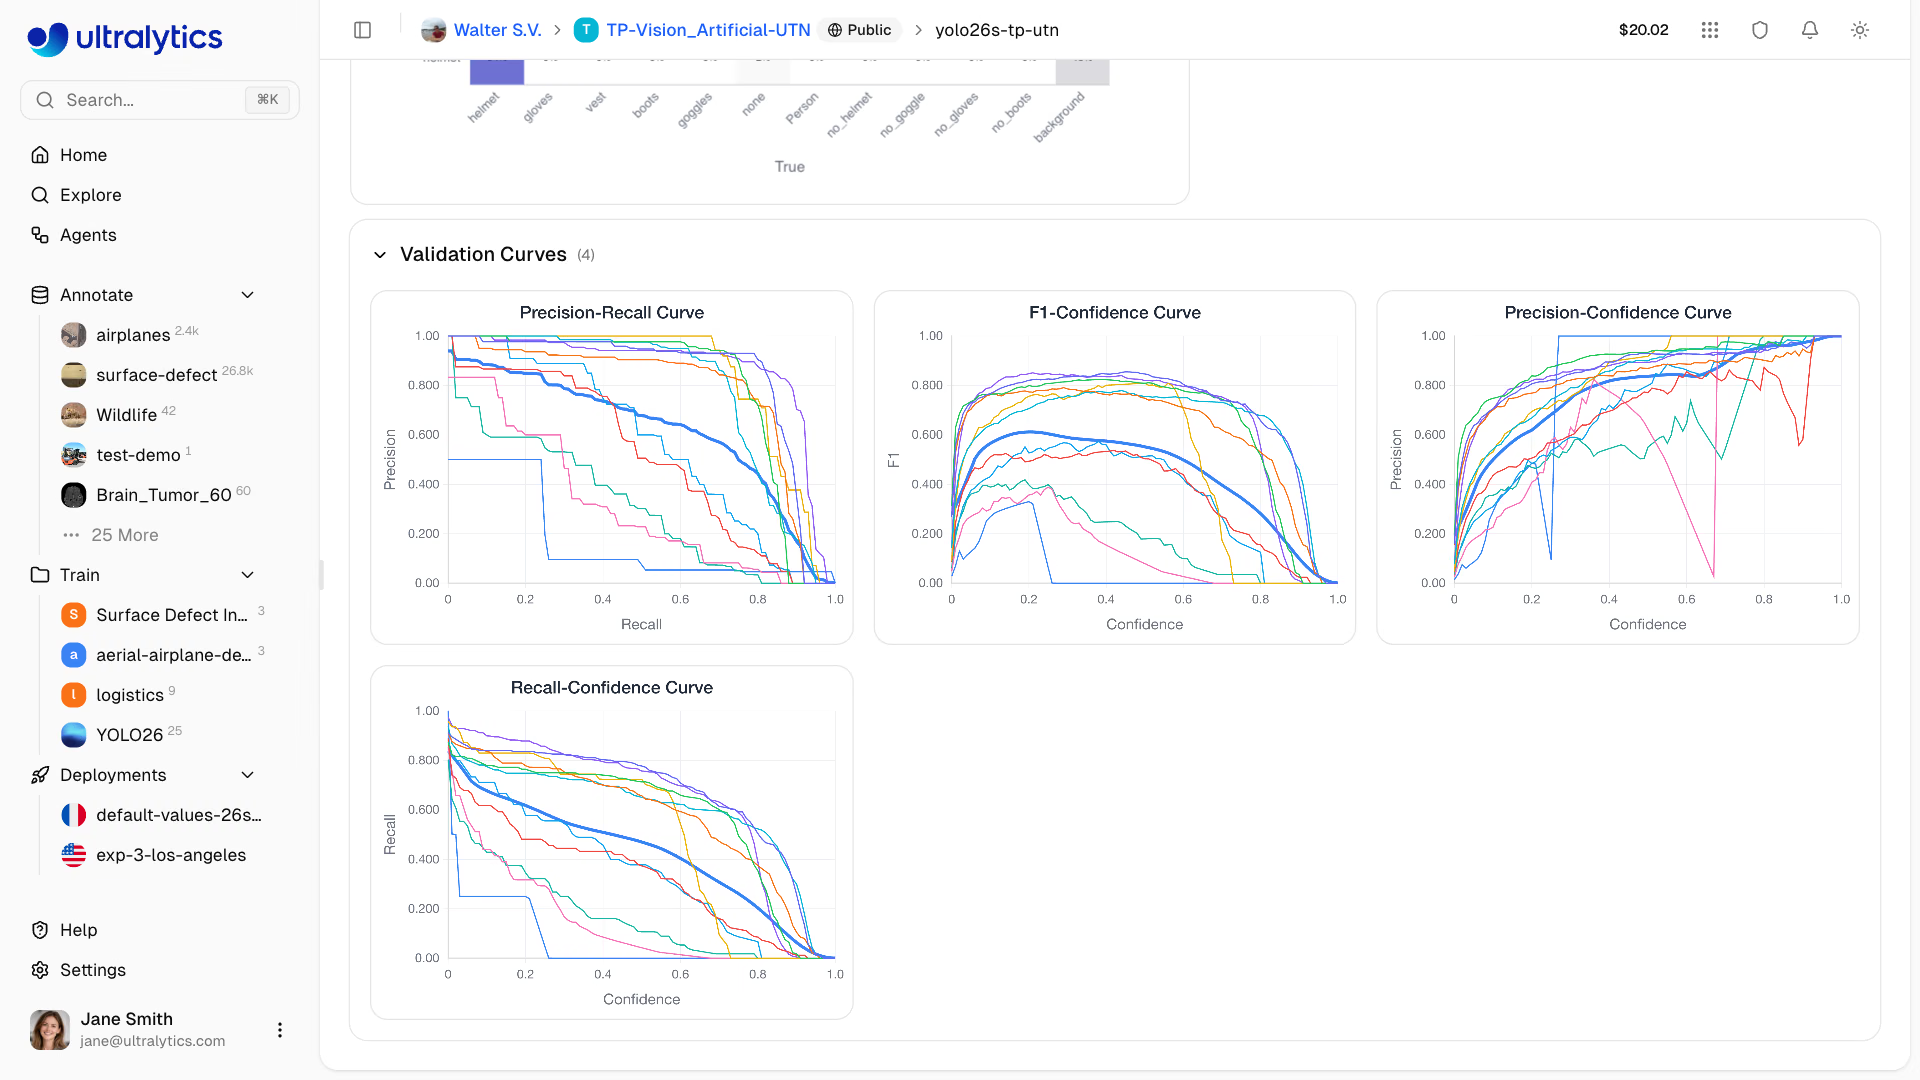
Un projet répertorie ses modèles avec des cases à cocher. Les modèles sélectionnés se superposent dans le tableau de bord Charts ; la vue Table aligne les paramètres d’entraînement et les métriques finales, et Diff masque les colonnes identiques pour que tu voies immédiatement que deux exécutions ne diffèrent que par imgsz. La comparaison s’effectue au sein d’un même projet : regroupe donc les expériences associées (les modèles peuvent être coupés et collés d’un projet à l’autre). Pour analyser les courbes, compare la valeur finale, la vitesse à laquelle chaque exécution l’a atteinte et la régularité de son évolution.

Avec au moins deux modèles terminés, Compare with AI demande à Ask AI de résumer les différences et de proposer l’expérience suivante. Considère sa proposition comme une hypothèse pour ta prochaine exécution, pas comme une conclusion.
Rendre chaque exécution explicable#
Les noms portent le sens : run_5 ne dit rien, tandis que v3_pallets_added et v4_imgsz1024 indiquent la version du jeu de données et la modification apportée. Pour consigner le raisonnement, ouvre More actions > Information sur la page du modèle et enregistre une note JSON dans Custom Metadata :
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Platform consigne le reste : la carte Run Information affiche le GPU, le tarif horaire, le coût total, la version ultralytics, l’hôte, le modèle parent, la version épinglée du jeu de données, le commit Git lorsqu’il est disponible et une commande yolo train que tu peux copier. Les comparaisons ne sont équitables qu’entre des exécutions utilisant la même version de jeu de données : chaque exécution doit donc en avoir une d’épinglée.
Choisir la métrique et les critères avant d’examiner les résultats#
| Indicateur | Quand l’utiliser |
|---|---|
| mAP50-95 | Valeur par défaut pour detect, segment, pose et OBB : récompense les boîtes bien ajustées et reste assez stable pour permettre les comparaisons |
| mAP50 | Objets volumineux et bien séparés pour lesquels l’ajustement des boîtes importe peu |
| AP par classe pour une seule classe | Une classe représente l’essentiel de la valeur commerciale |
| Rappel à précision fixe | Systèmes de sécurité et d’alarme |
| Latence d’inférence sur la cible | Toujours, comme limite stricte |
Le guide des métriques de performance YOLO explique chacune d’elles. Un candidat n’est déployé que s’il satisfait tous les critères :
Exemple pratique : un script de validation avant promotion#
Télécharge les fichiers best.pt des finalistes et évalue-les sur des données identiques avec le même code. Cet exemple utilise deux checkpoints officiels pour pouvoir être exécuté partout :
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsRésultat : le modèle le plus grand l’emporte au classement général avec 2,4 points d’avance, mais deux classes perdent plus de 10 % de leur AP ; il échoue donc. C’est la régression que masque une comparaison limitée à la métrique principale. Le dictionnaire par classe provient de ap_class_index et de ap, qui ne couvrent que les classes présentes dans les données ; la latence est mesurée sur la machine qui exécute le script. Exécute donc la validation sur du matériel similaire à ta cible de déploiement. COCO8 ne comporte que 8 images de validation, bien trop peu pour prendre une véritable décision. Utilise un jeu de données de validation mis de côté d’au moins quelques centaines d’images et transmets split="test" une seule fois, pour la décision finale.
Examiner les images problématiques#
Pour les exécutions de détection entraînées avec une version de jeu de données enregistrée, la vue Validation ajoute Validation insights : les images les plus et les moins performantes selon le F1 par image, affichées avec la vérité terrain ; un explorateur de caractéristiques qui corrèle le F1 à la taille de l’image, au rapport hauteur/largeur et au nombre d’instances ; et les classes les plus associées aux échecs. L’option Find similar sur les images les moins performantes ajoute des images similaires au jeu d’entraînement en tant qu’images non étiquetées, transformant un échec de validation en tâche concrète sur les données.
Pièges#
Symptôme : le mAP de test annoncé est excellent, mais les résultats en production sont moins bons. Correctif : règle le modèle sur la partition de validation. Si tu as comparé dix exécutions sur la partition de test, tu l’as utilisée pour le réglage et son score est optimiste. Évalue les finalistes sur la partition de test une seule fois, tout à la fin.
Symptôme : une exécution « gagne » de 4 points, et personne ne peut expliquer pourquoi. Correctif : vérifie la version épinglée du jeu de données dans la fiche Run Information de chaque exécution. Si les versions diffèrent, relance l’évaluation de référence sur la nouvelle version avant toute comparaison.
Symptôme : le gagnant change à chaque réentraînement avec une nouvelle graine. Correctif : sur la plupart des jeux de données, les écarts inférieurs à environ 0,5 point de mAP relèvent du bruit d’une exécution à l’autre. Garde le seuil de bruit dans le critère de validation et utilise un jeu de réserve plus grand lorsque les résultats sont aussi proches.
Afficher la solution
Exemple de réponse pour le modèle de pilules : comparaison de la référence v1-baseline (10 époques) au candidat v2-finetune (5 époques supplémentaires, SGD, lr0 0.001). Définis DATA = "medical-pills.yaml" et les deux poids dans gate.py. Résultat : PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms ; décision : « déployer le candidat ». Custom Metadata sur v2 : hypothèse « v1 s’améliorait encore à l’époque 10 », modification « ajustement fin de 5 époques, SGD lr0 0.001 », résultat « mAP50-95 0.659 -> 0.687 ». À noter dans les métadonnées : la validation de medical-pills a également guidé l’entraînement ; confirme donc le résultat sur un jeu de données distinct mis de côté avant la mise en production.