Ajouter et préparer les données
Vérifie un jeu de données local avant son téléversement, échantillonne les vidéos de manière réfléchie et fais en sorte qu’un jeu de données Platform atteigne l’état Ready du premier coup.
Le bogue le moins coûteux dans un jeu de données est celui que tu repères avant le téléversement. Les étiquettes Pascal VOC sont ignorées sans avertissement, les images de moins de 28 pixels sont rejetées et une vidéo de 30 minutes ne fournit que 100 images, dont la plupart montrent une scène vide. Dans cette leçon, tu effectues une vérification de deux minutes avant le téléversement, échantillonnes les vidéos de manière réfléchie et consultes les indicateurs de traitement de Platform pour que tes données d’entraînement arrivent au complet.
Pratique
Créer le jeu de données#
Ouvre Annotate dans la barre latérale et clique sur New Dataset. La boîte de dialogue demande une source, un nom, le type de tâche, une licence facultative, le floutage des visages et la visibilité :

| Source | À utiliser lorsque | Plan |
|---|---|---|
| Téléversement | Les fichiers se trouvent sur ta machine : images, vidéos, archives ou exportations NDJSON | Toutes |
| URL | Il existe un lien public .zip, .tar, .tar.gz, .tgz ou .ndjson ; Platform le télécharge côté serveur | Toutes |
| Cloud | Les données se trouvent déjà dans Google Cloud Storage, Amazon S3 ou Azure Blob Storage et doivent y rester | Pro, Enterprise |
| Sur site | Les pixels ne doivent jamais quitter tes machines | Enterprise |
Règle de décision : téléverse une copie pour ce cours. Les jeux de données Cloud et sur site gardent les pixels en dehors de Platform ; l’annotation intelligente, le regroupement, le clonage et les instantanés de versions ne sont donc pas disponibles.
Le type de tâche détermine les outils et les modèles qui s’affichent. Platform prend en charge les sept tâches Ultralytics YOLO :
| Tâche | Comment l’étiqueter |
|---|---|
| Détection | Rectangle, ou annotation intelligente avec SAM et YOLO |
| Segmentation | Polygone, ou annotation intelligente avec SAM et YOLO |
| Sémantique | Polygone, ou annotation intelligente avec SAM et YOLO ; importation directe des masques PNG |
| Pose | Points clés sur des squelettes prédéfinis ou personnalisés ; modèles YOLO de pose pour l’annotation intelligente |
| OBB | Boîte orientée, ou annotation intelligente avec SAM et YOLO |
| Classification | Sélecteur de classe dans la barre latérale |
| Profondeur | Pas de dessin : téléverse des images avec leurs cartes de profondeur associées (téléversement ou URL uniquement) |
Exemple pratique : vérifier le jeu de données avant le téléversement#
La plateforme accepte les images JPEG, PNG, WebP, BMP, TIFF, HEIC, AVIF, JP2, DNG et MPO jusqu’à 50 Mo et d’au moins 28 px sur le côté le plus court. Elle lit également les annotations YOLO, COCO, LabelMe, Ultralytics ou Labelbox NDJSON, ainsi que les masques sémantiques PNG. Les fichiers XML Pascal VOC sont détectés, mais ne sont pas importés. Ce script vérifie qu’un jeu de données YOLO local respecte ces règles ; voici le jeu de données public de pilules médicales :
from collections import Counter
from pathlib import Path

from PIL import Image

from ultralytics.data.utils import check_det_dataset

ACCEPTED = {".jpg", ".jpeg", ".png", ".webp", ".bmp", ".tif", ".tiff", ".heic", ".avif", ".jp2", ".dng", ".mpo"}
data = check_det_dataset("medical-pills.yaml")  # your local dataset YAML
root = Path(data["path"])

problems = Counter()
for split in ("train", "val", "test"):
    if not data.get(split):
        continue
    files = [p for p in Path(data[split]).rglob("*") if p.is_file()]
    images = [p for p in files if p.suffix.lower() in ACCEPTED]
    labeled = 0
    for img in images:
        label = Path(str(img).replace("images", "labels")).with_suffix(".txt")
        labeled += label.exists() and label.stat().st_size > 0
        if min(Image.open(img).size) < 28:
            problems["under 28 px (rejected)"] += 1
        if img.stat().st_size > 50 * 1024**2:
            problems["over 50 MB (rejected)"] += 1
    problems["unsupported files (skipped)"] += len(files) - len(images)
    print(f"{split:<5} {len(images):>4} images, {labeled:>4} labeled, {len(images) - labeled:>3} background")
problems["Pascal VOC .xml labels (not imported)"] += len(list(root.rglob("*.xml")))
print("classes:", data["names"])
print("problems:", {k: v for k, v in problems.items() if v} or "none")
train 92 images, 92 labeled, 0 background
val 23 images, 23 labeled, 0 background
classes: {0: 'pill'}
problems: noneCe que les résultats t’indiquent :
- Nombre d’éléments par partition. Les images situées dans les dossiers
train/,val/ettest/conservent cette partition lors du téléversement ; ces nombres correspondent donc à ce que la plateforme affichera. Si la lignevalest absente, la plateforme créera pour toi une partition de validation aléatoire (voir le piège ci-dessous). - Les images d’arrière-plan (sans fichier d’annotation) sont acceptables avec modération ; elles apprennent au modèle à reconnaître l’absence d’objet. Si tu en as des centaines, c’est généralement que les annotations n’ont pas été exportées.
problems: nonesignifie que chaque image sera traitée. Tout nombre affiché ici correspond à un fichier qui se retrouvera dans l’ongletErrorsou qui n’arrivera jamais.
Compresse le dossier du jeu de données avec son data.yaml, puis fais glisser l’archive dans la galerie. La plateforme détecte automatiquement le format, ne stocke qu’une seule copie des images identiques et te demande de choisir entre Ignorer, Conserver les deux ou Remplacer lorsqu’un téléversement entre en conflit avec des images déjà présentes dans le jeu de données.
Exemple pratique : échantillonner une vidéo avant que la plateforme ne le fasse#
La plateforme échantillonne chaque vidéo à raison d’une image par seconde et conserve au maximum 100 images ; pour les clips de plus de 100 secondes, elle augmente l’intervalle :
| Durée du clip | Images conservées | Intervalle |
|---|---|---|
| 60 secondes | 60 | 1 seconde |
| 100 secondes | 100 | 1 seconde |
| 30 minutes (54 000 images à 30 fps) | 100 | 18 secondes |
Cette méthode convient pour un aperçu rapide, mais échoue dans la plupart des projets réels : un enregistrement de 30 minutes d’un poste de travail devient 100 images, principalement d’une allée vide. Échantillonne toi-même les longues séquences, puis téléverse les images :
Pour un échantillonnage uniforme, FFmpeg suffit :
mkdir -p frames
ffmpeg -i source.mp4 -vf fps=1 frames/%06d.jpg
Pour un échantillonnage basé sur les événements, laisse un modèle Ultralytics YOLO préentraîné ne conserver que les images où figure ton objet :
from pathlib import Path

import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or your latest fine-tune
out = Path("frames")
out.mkdir(exist_ok=True)

source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
seen = kept = 0
for i, result in enumerate(model.predict(source, stream=True, vid_stride=5, classes=[0], conf=0.5, verbose=False)):
    seen += 1
    if len(result.boxes):  # keep only frames where a person was detected
        cv2.imwrite(str(out / f"frame_{i:05d}.jpg"), result.orig_img)
        kept += 1
print(f"Kept {kept} of {seen} sampled frames")
Kept 12 of 12 sampled framesvid_stride=5 examine une image sur cinq, classes=[0] limite la détection aux personnes et conf=0.5 ignore les détections peu fiables. Ce clip de démonstration animé contient des personnes dans chaque image échantillonnée ; dans un enregistrement d’une scène presque vide, la proportion d’images conservées chute fortement, tout comme le coût de l’annotation. Augmente vid_stride jusqu’à ce que les images conservées voisines cessent de se ressembler.
Interpréter les indicateurs de traitement de la plateforme#
Après le téléversement, la plateforme valide et normalise les images (celles de plus de 4 096 px sont redimensionnées), crée des vignettes, analyse les annotations et calcule des statistiques. Vérifie ces trois éléments :
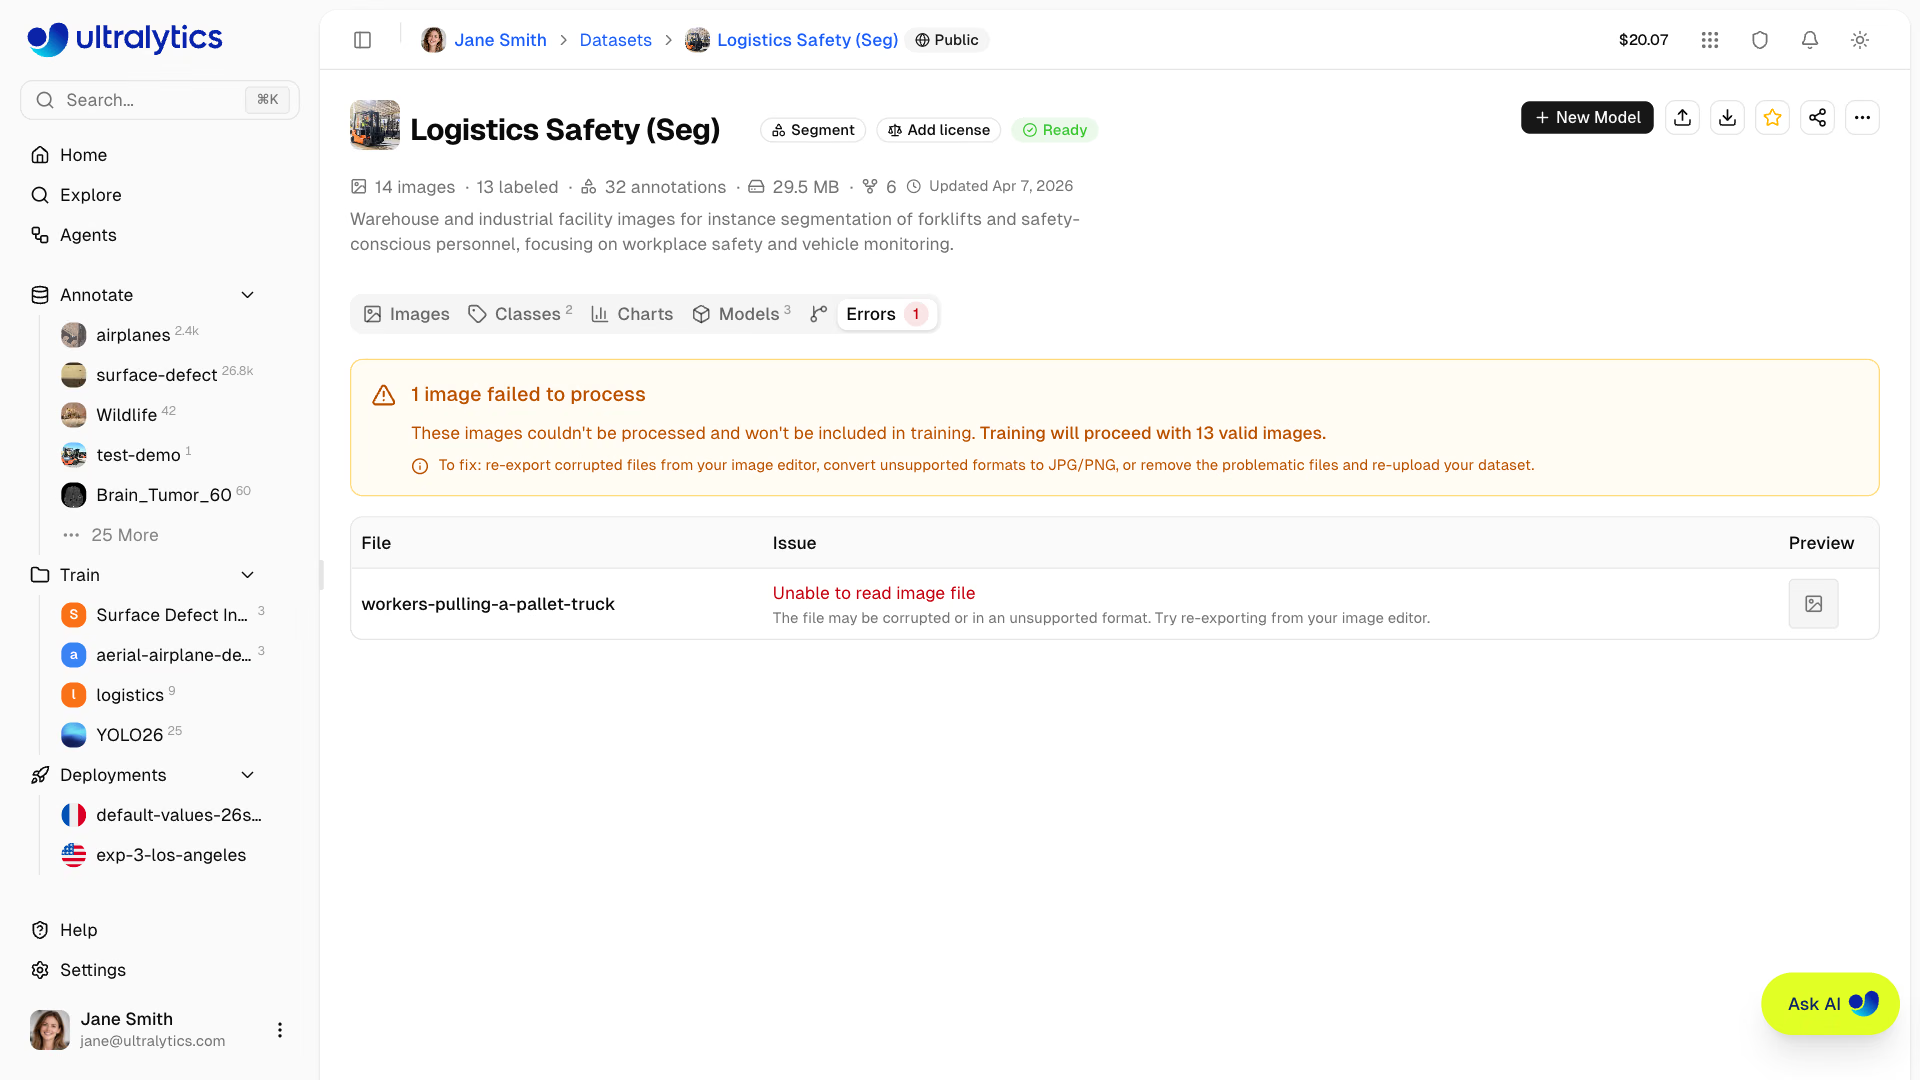
- L’onglet
Errorsn’apparaît que lorsque des fichiers échouent : fichiers corrompus, formats non pris en charge, images de moins de 28 px ou modes colorimétriques CMYK et indexés. Une suggestion de correction est indiquée pour chacun. Réexporte-les ou téléverse-les à nouveau. - L’onglet
Chartsaffiche la répartition des partitions, les classes principales, les dimensions des images, la taille des fichiers, l’emplacement des annotations, la taille des boîtes et le nombre d’objets par image. Repère les classes qui apparaissent rarement, les petites images ou les boîtes regroupées dans un coin. - Le badge dans l’en-tête du jeu de données affiche
Readyune fois le traitement terminé et dès que le jeu de données contient au moins une imagetrain, une imagevaloutest, et une image annotée. Clique surNot Readypour voir quelle condition n’est pas remplie.

Commencer avec un jeu de données public#
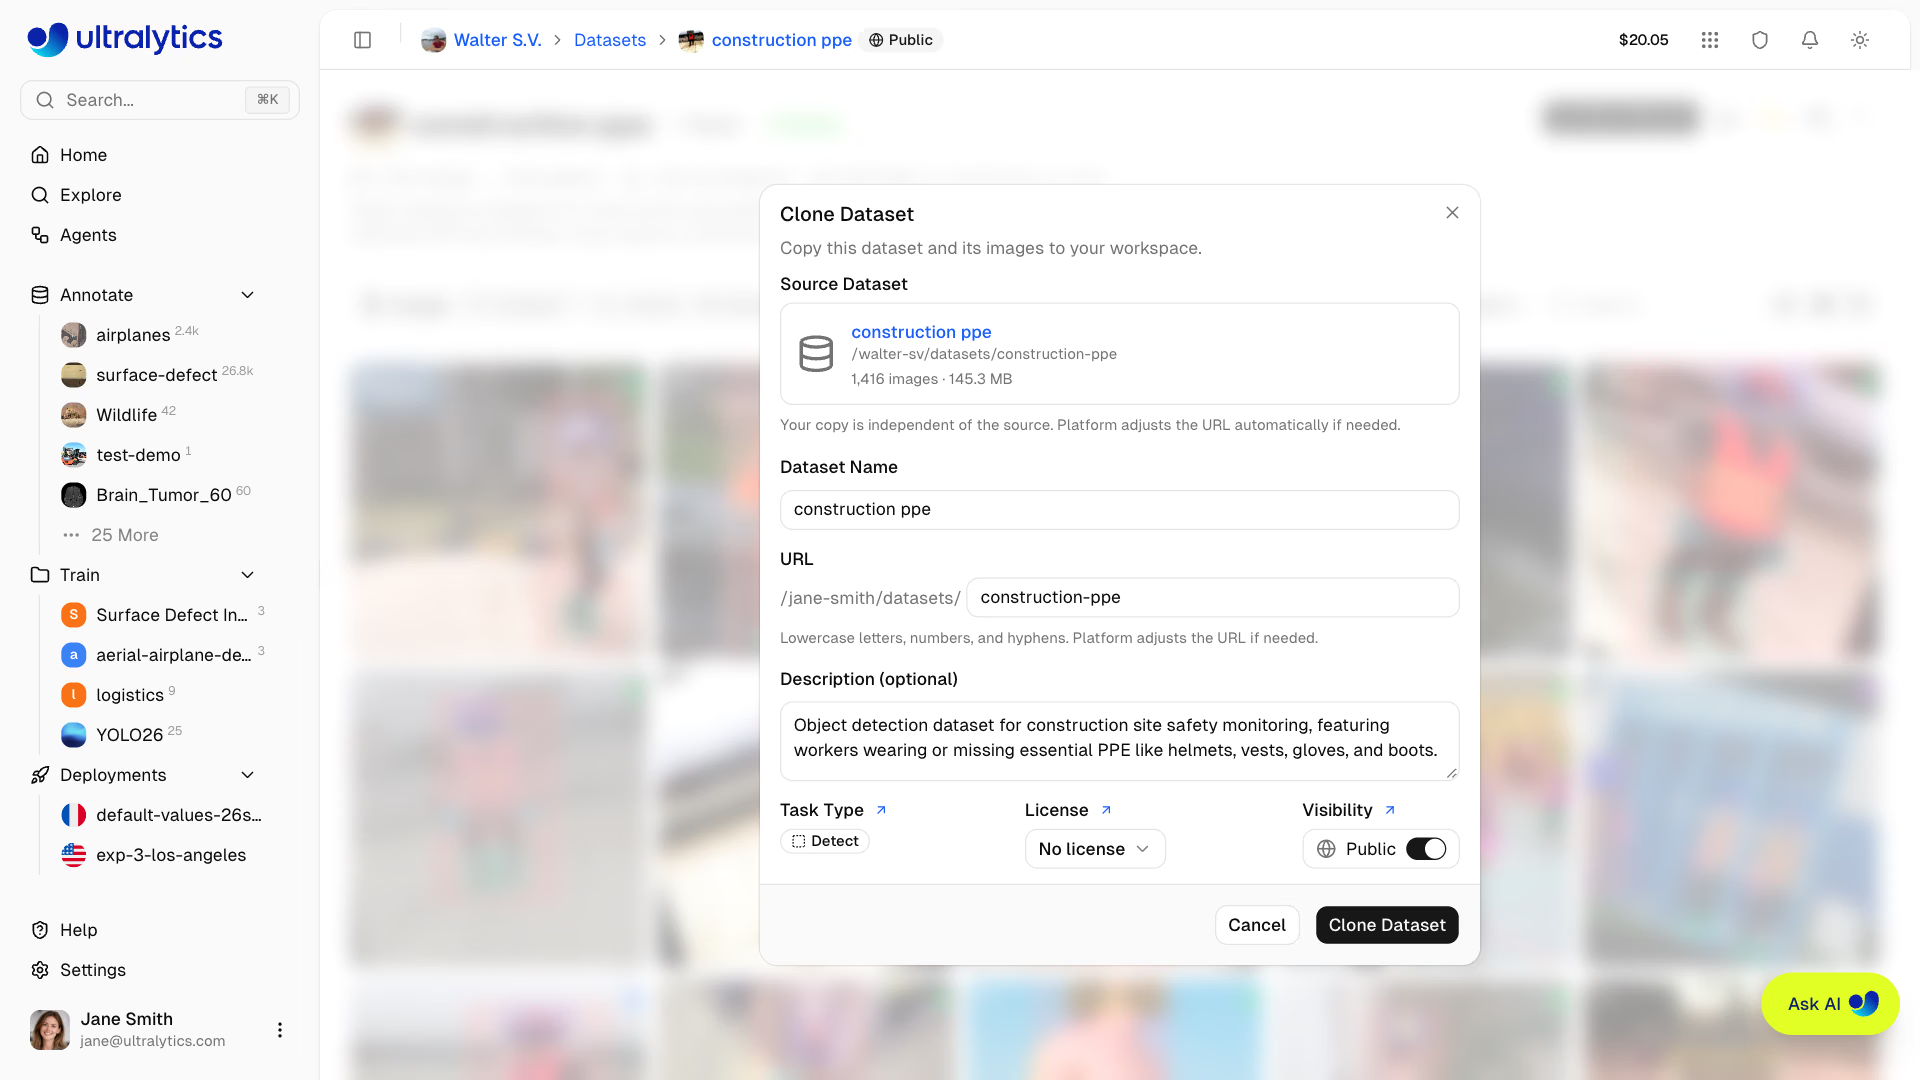
Pas encore de données ? La page Explorer répertorie les jeux de données officiels et communautaires. Cloner le jeu de données copie les images, les annotations et les classes dans ton espace de travail, compte dans ton espace de stockage et conserve par défaut la visibilité publique de la source ; si tu ajoutes des éléments sensibles, désactive l’option dans la boîte de dialogue.
Pièges#
Symptôme : le téléversement réussit, mais toutes les images arrivent sans étiquette. Solution : Platform détecte les fichiers XML Pascal VOC et ne les importe pas. Convertis-les d'abord en étiquettes YOLO .txt ou en JSON COCO ; la vérification avant téléversement compte les fichiers .xml pour que tu détectes le problème avant l'envoi.
Symptôme : la mAP de validation est excellente, mais pas celle du modèle déployé. Solution : si un téléversement sans répartition sélectionnée laisse val vide, Platform déplace aléatoirement environ 20 % des images d'entraînement vers val. Pour des images vidéo, cela place des images voisines quasi identiques dans les deux répartitions. Téléverse plutôt les dossiers train/ et val/, répartis par vidéo ou par caméra (leçon 4).
Symptôme : tu ne trouves pas l'outil polygone ou les points clés. Solution : le type de tâche détermine les outils disponibles. Modifie-le depuis l'en-tête du jeu de données ; chaque image stocke les étiquettes de toutes les tâches, donc le changement masque les étiquettes des autres tâches sans les supprimer.
Afficher la solution
Exemple résolu : jeu de données de pilules médicales et vidéo de 4 minutes filmée par une caméra de chaîne de production. Vérification avant téléversement : 92 images d’entraînement et 23 images de validation, toutes annotées, aucun problème. Vidéo : sa durée de 240 secondes dépasse 100 secondes ; l’intervalle passe donc à ceil(240 / 100) = 3 secondes et la plateforme conserve 80 images (une à 0 s, 3 s, …, 237 s). Nombre d’images attendu dans la galerie : 92 + 23 + 80 = 195. Les images extraites de la vidéo arrivent sans annotation dans la partition sélectionnée dans le filtre de la galerie. Sélectionne donc Entraînement avant de déposer la vidéo pour éviter de les ajouter à la validation. Le badge affiche Ready puisque les partitions d’entraînement et de validation contiennent des images et que des images sont annotées. Si tu n’avais téléversé que la vidéo, le badge afficherait Not Ready : aucune image n’est encore annotée.