Annotation intelligente et annotation par lots
Choisis un modèle d’annotation et un seuil de confiance en mesurant le travail de vérification, puis lance l’annotation par lots et évalue-la à l’aide du taux de modification.
Tracer des boîtes à la main prend environ 100 images par heure ; vérifier de bonnes préannotations peut être plusieurs fois plus rapide. Mais si le seuil de confiance d’un modèle d’annotation est mal choisi, le modèle peut créer plus de travail qu’il n’en économise. Et sans vérification, le modèle suivant apprendra ses erreurs. Cette leçon mesure le travail de vérification nécessaire à chaque seuil sur des données réellement annotées, pour que tu choisisses le seuil en fonction des chiffres plutôt que de faire une supposition.
Pratique
Trois façons de préannoter#
Dans l’éditeur d’annotation, le mode Draw (V) est manuel, tandis que le mode Smart (S) permet à un modèle de proposer des annotations :
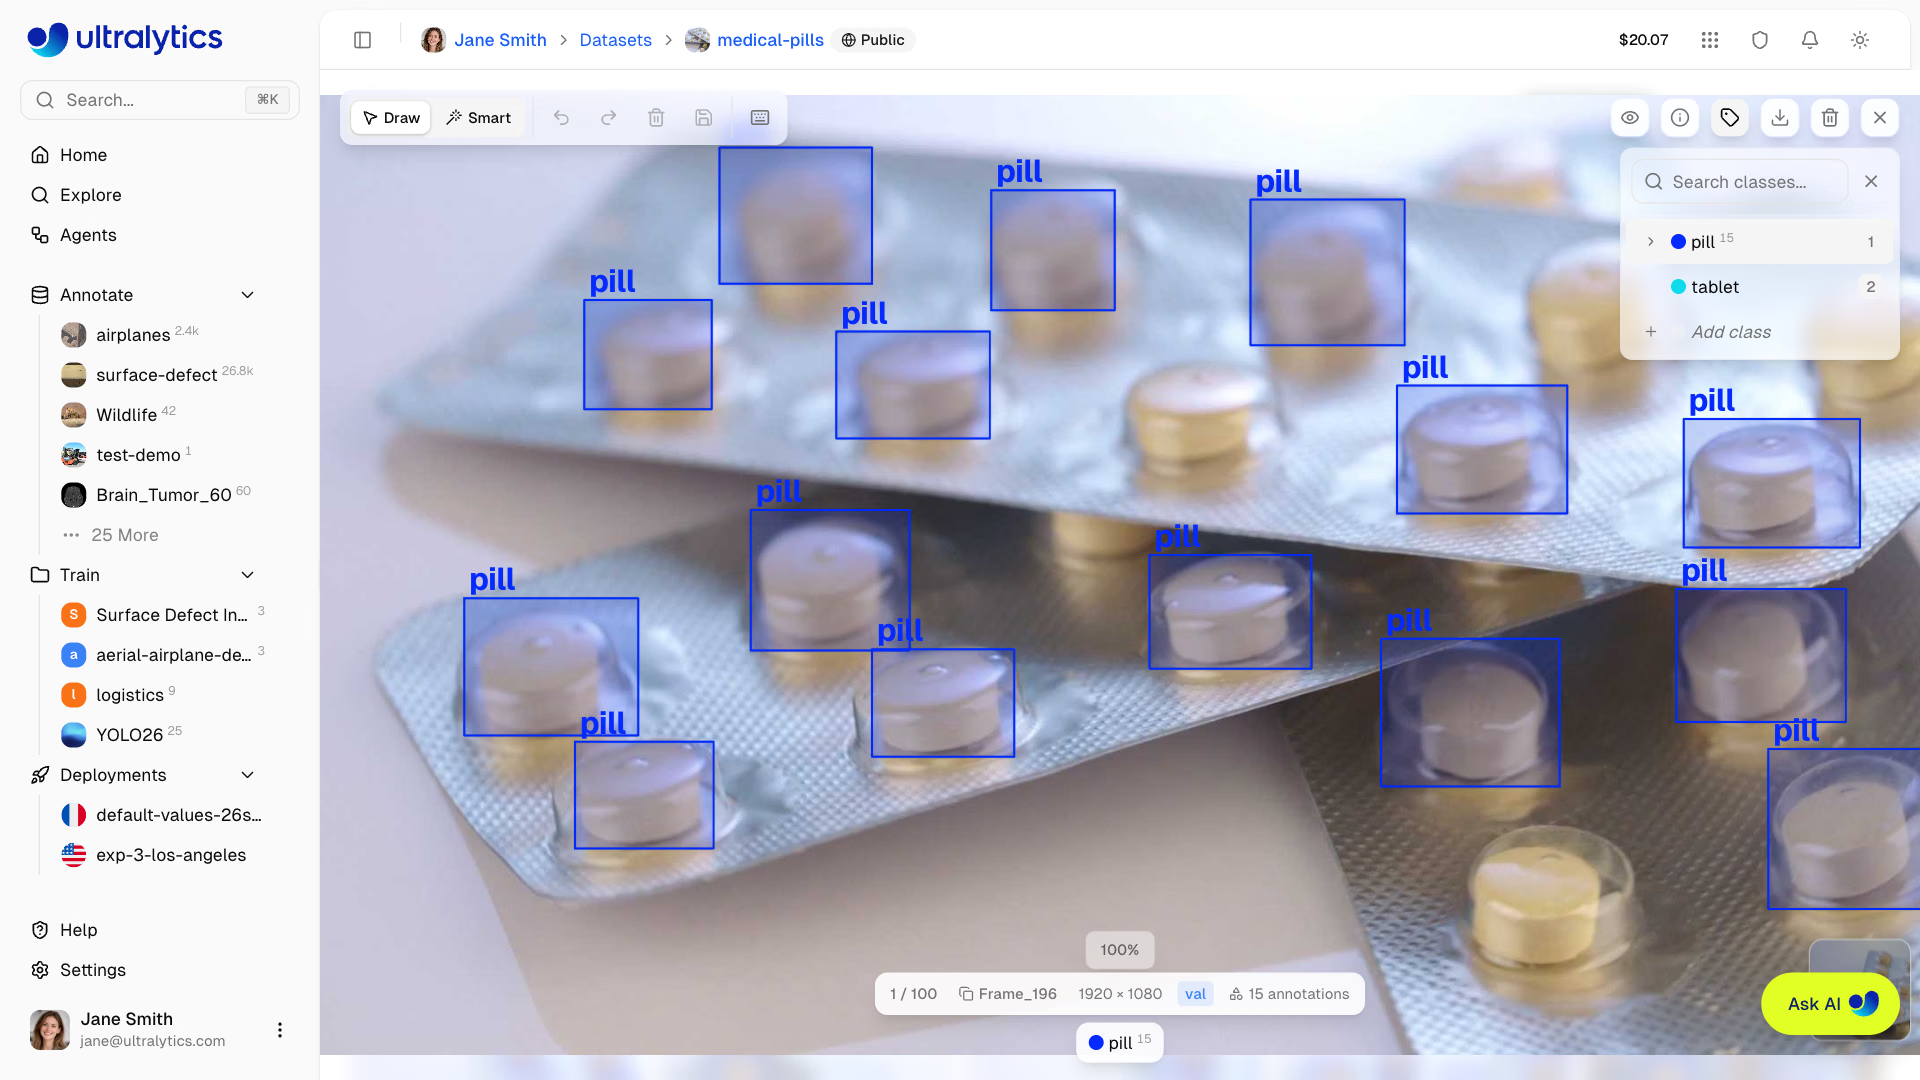
| Famille | Fonctionnement | Tâches | Coût |
|---|---|---|---|
| SAM (SAM 2.1 Tiny à Large, SAM 3, SAM 3.1 par défaut) | Clique sur un objet pour créer un masque ; clique à l’extérieur pour en ajouter, à l’intérieur pour en soustraire ; A active ou désactive l’application automatique | Détection, segmentation, sémantique, OBB | Free |
| YOLO (modèles officiels ou personnalisés) | Predict ajoute les détections du modèle ; Map classes aligne les classes du modèle sur celles du jeu de données ; les doublons avec un IoU de 0.7 ou plus sont ignorés | Détection, segmentation, sémantique, OBB, pose | Gratuit dans l’éditeur |
| Guidé par des classes (Moondream 3.1 par défaut, YOLOE-26x, SAM 3 Text et autres) | Repère dans l’image les noms de classes du jeu de données ; les modèles payants de fournisseurs s’exécutent avec ta propre clé API | Jeux de données de détection comptant de 1 à 200 classes | Modèles hébergés gratuits |
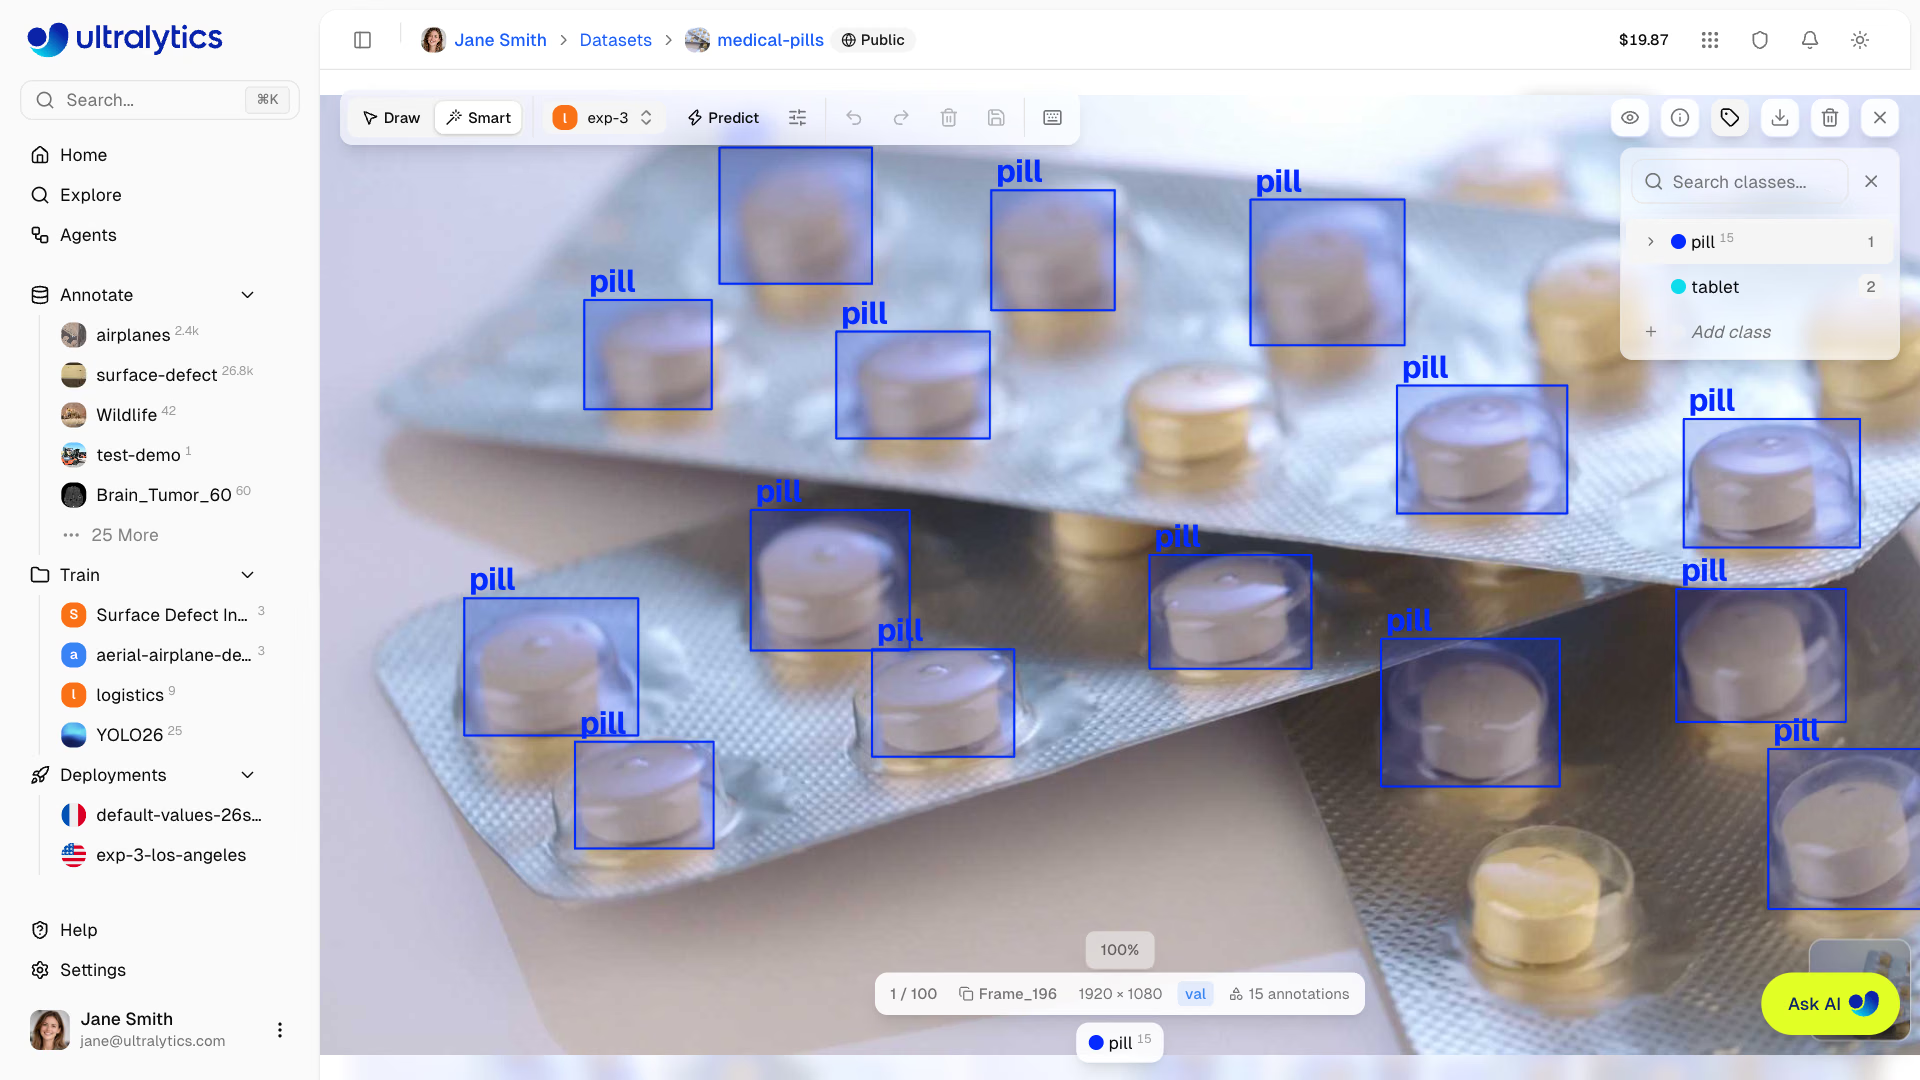
SAM nécessite un clic par objet et produit les formes les plus précises. Les prédictions du modèle nécessitent un clic par image et leur qualité dépend du modèle ; le reste de cette leçon porte donc sur le choix et le réglage de ce modèle.
Choisir le modèle d’annotation#
Un modèle v0 peu performant, entraîné sur 100 à 200 annotations manuelles, reste préférable au traçage à partir de zéro et, dès la v1, devient généralement un partenaire utile d’apprentissage actif. Les performances des modèles guidés par des classes varient énormément selon le domaine : certains repèrent presque tout dans des photos courantes, mais manquent la plupart des objets dans les images de PCB, de radiographies ou de vente au détail. Vérifie donc dix prédictions avant de faire confiance à un modèle.
Exemple pratique : mesurer le travail de vérification pour chaque seuil#
Le seuil de confiance détermine le travail des personnes chargées de la vérification : trop bas, elles suppriment les fausses boîtes ; trop haut, elles tracent les boîtes ignorées par le modèle. Mesure le travail sur des images déjà correctement annotées, ici les 128 images annotées de COCO128, avec YOLO26n préentraîné comme modèle d’annotation :
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Fonctionnement et interprétation des résultats :
- Le modèle effectue une seule prédiction avec une
conf=0.05basse ; chaque seuil filtre ensuite les mêmes prédictions, ce qui rend le balayage rapide. review_workassocie chaque prédiction à une boîte de référence de la même classe avec un IoU d’au moins 0.5. Les prédictions non associées sont des boîtes que la personne chargée de la vérification supprime ; les annotations de référence non associées correspondent aux objets qu’elle trace.- Le nombre de modifications par image est minimal entre 0.25 et 0.4 (4.7). En dessous, les suppressions explosent ; au-dessus, ce sont les objets manqués.
- Même avec le meilleur seuil, les personnes chargées de la vérification tracent environ 3.6 boîtes par image, car les nombreux petits objets de COCO sont difficiles à repérer pour un modèle nano.
Règles de décision : choisis le seuil qui entraîne le moins de modifications par image. Si tracer domine à tous les seuils, le modèle d’annotation est trop faible pour les données : utilise un modèle plus grand ou ton modèle affiné. Si supprimer domine même à 0.5, le modèle confond des classes qui se ressemblent ; examine la matrice de confusion avant de poursuivre l’annotation. Pour ton propre projet, effectue ce balayage avec ton modèle affiné sur 50 à 100 images que tu as déjà annotées.
Lancer l’annotation par lots#
L’annotation par lots applique un modèle YOLO ou guidé par des classes à l’ensemble du jeu de données. Ouvre-la depuis Plus d’actions > Annotation par lots, ou clique sur Tout annoter dans la notification après une prédiction dans l’éditeur :
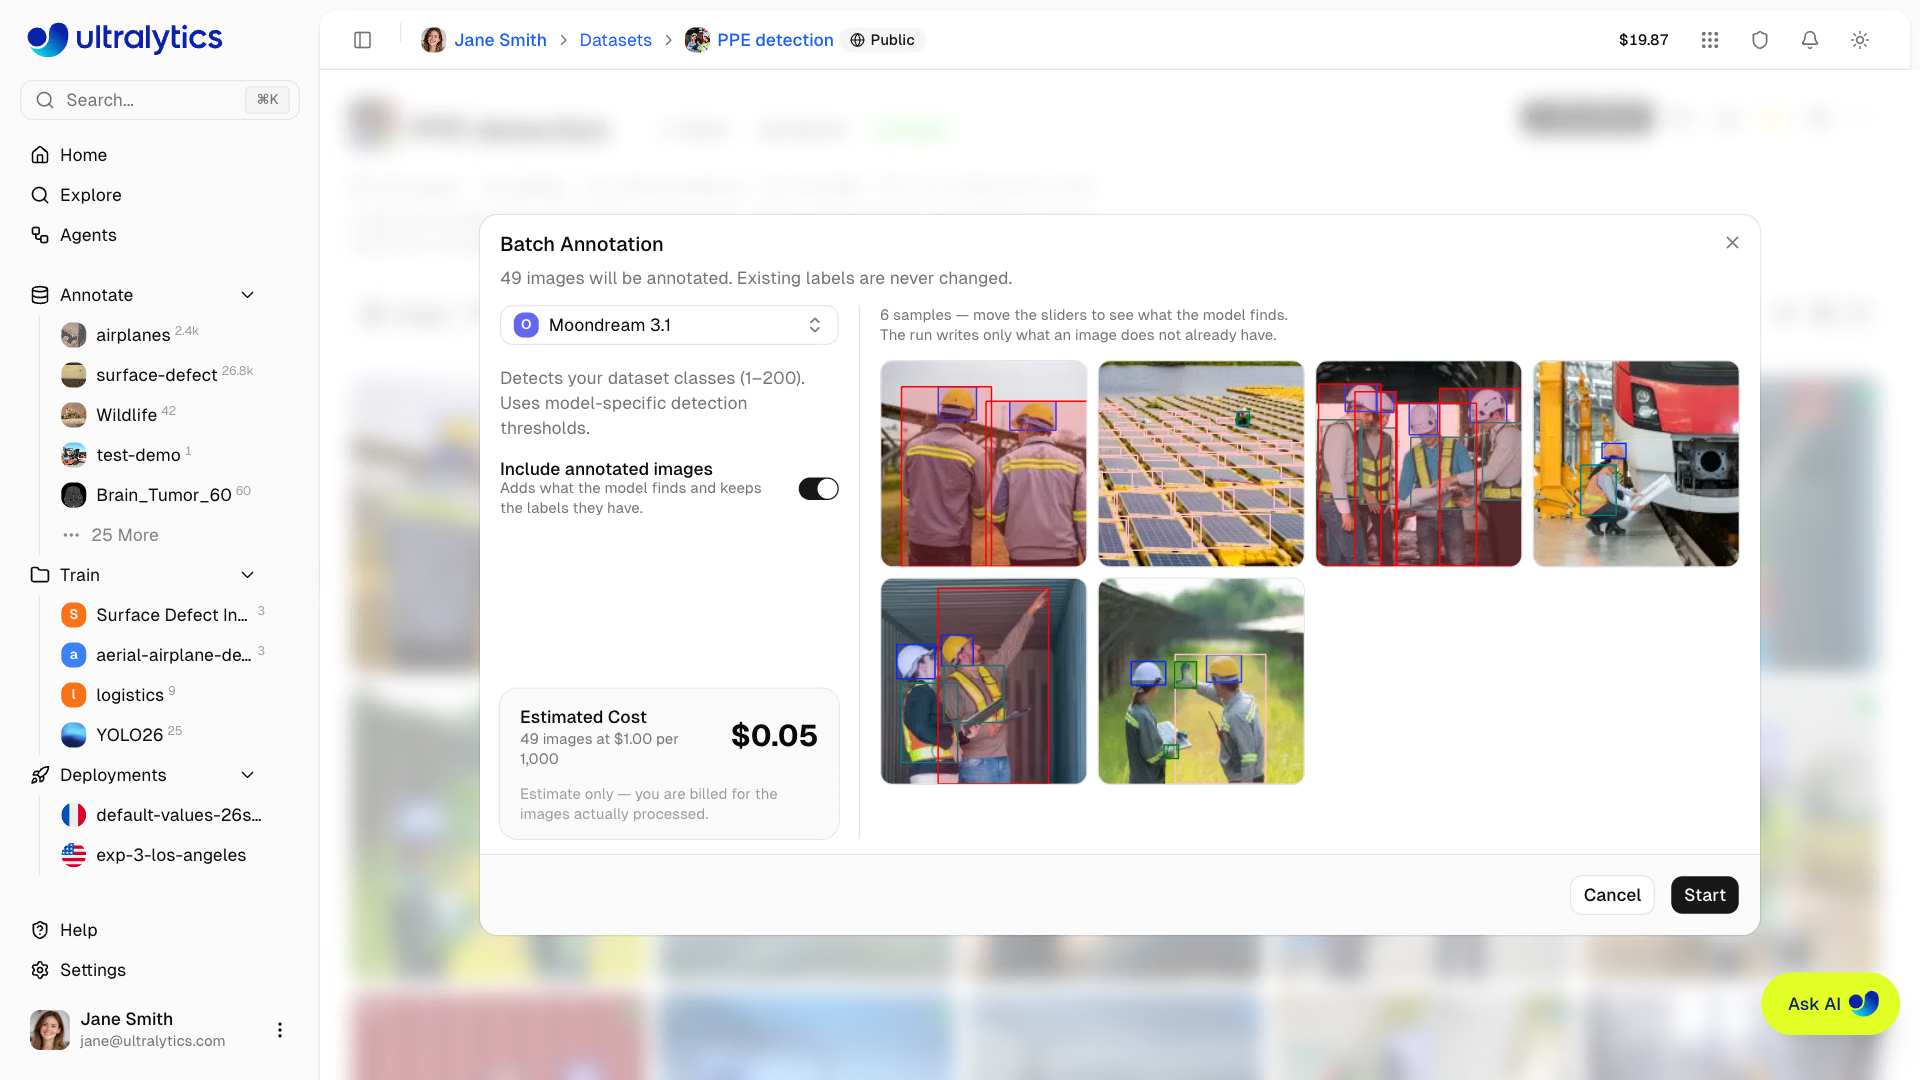
- Choisis le modèle. Pour les jeux de données de détection, Moondream 3.1 est sélectionné par défaut ; choisis plutôt ton modèle affiné ou ton modèle YOLO.
- Pour un modèle YOLO, règle le seuil de confiance sur la valeur choisie lors du balayage (la valeur par défaut est
0.25) ainsi que l’IoU (0.7), puis vérifie les aperçus des échantillons. - Laisse l’option Inclure les images annotées désactivée pour n’annoter que les images sans annotation.
- Vérifie le coût estimé (1,00 $ pour 1 000 images, minimum de 0,01 $), puis clique sur Démarrer.
Le lancement d’une exécution enregistre d’abord une version du jeu de données, ce qui te permet de restaurer son état initial. Arrêter conserve les images déjà traitées et les facture.
Vérifier, puis mesurer le taux de modification#
Les prédictions sont enregistrées comme des annotations ordinaires ; rien n’indique donc qu’elles n’ont pas été vérifiées. Filtre par classe pour examiner d’abord les classes rares, puis trie par Annotations en ordre croissant (objets probablement manqués) et décroissant (scènes encombrées où les boîtes fusionnent). Crée ensuite une version, ouvre Comparer les versions dans l’onglet Versions et sélectionne v_auto comme version De :
| Nombre | Signification |
|---|---|
| Ajoutés | Objets manqués par le modèle, plus la copie corrigée de chaque boîte modifiée |
| Supprimés | Faux positifs, plus l’original de chaque boîte modifiée |
| Taux de modification | (ajoutés + supprimés) ÷ annotations dans v_auto, valeur maximale, car une boîte corrigée est comptée deux fois |
Suis le taux de modification pour chaque lot. Une hausse est le premier signe que les nouvelles images s’écartent de ce que connaît le modèle d’annotation. La leçon sur les bonnes pratiques d’annotation aborde les guides d’annotation et la concordance entre les personnes chargées de la vérification.
Pièges#
Symptôme : chaque nouvel entraînement obtient à peu près le même score, et les mêmes objets ne sont jamais détectés. Solution : les pré-étiquettes non vérifiées inscrivent les erreurs systématiques du modèle d'annotation comme des vérités dans le jeu de données : une classe ressemblante, un bord de boîte systématiquement trop lâche, des objets qu'il ne détecte jamais. Vérifie chaque image avant qu'elle n'entre dans une version d'entraînement.
Symptôme : l'annotation par lots se termine, mais la plupart des objets restent sans étiquette. Solution : exécute d'abord le modèle dans l'éditeur sur dix images représentatives. S'il manque plus que quelques objets, annote manuellement un jeu initial et entraîne plutôt une version v0.
Symptôme : les boîtes prédites portent les mauvais noms de classe. Correctif : lorsque les classes du modèle diffèrent de celles du jeu de données, l’étape Mapper les classes associe chaque classe du modèle à une classe du jeu de données ou l’ignore. Fais les associations avec soin : une mauvaise association renomme toutes les boîtes de cette classe.
Afficher la solution
Exemple détaillé : le balayage sélectionne 0.35 pour un ajustement fin destiné à l’inspection de pilules. L’annotation par lots enregistre v4 avec 1 240 annotations. Après vérification, Comparer les versions v4 → v5 indique 96 ajouts et 152 suppressions ; le taux de modification est donc (96 + 152) ÷ 1 240 = 20 %. Comme les suppressions sont plus nombreuses que les ajouts, le modèle surestime : l’inspection des boîtes supprimées montre qu’il prend les reflets des plaquettes pour des pilules. Deux mesures s’imposent : augmenter la confiance d’un cran (0.35 → 0.45) pour le prochain lot et vérifier que le taux baisse, puis ajouter 30 images vérifiées de plaquettes brillantes à la prochaine version d’entraînement pour que l’ajustement fin apprenne à faire la différence.