Déployer et appeler un point de terminaison
Crée un point de terminaison dédié dans l’une des 42 régions, dimensionne-le en fonction de ton trafic et appelle-le avec un client qui gère les démarrages à froid, les erreurs 429 et les clés invalides.
Un point de terminaison gratuit qui passe à zéro peut mettre jusqu’à une minute à répondre à sa première requête, et un client naïf transforme ce délai en expiration visible par l’utilisateur. Une clé divulguée continue de fonctionner même après sa suppression. Cette leçon déploie ton modèle gagnant, dimensionne délibérément le point de terminaison et crée le petit client dont toute intégration de production a besoin.
Pratique
Inférence partagée ou point de terminaison dédié#
Chaque modèle peut déjà être appelé via l’API d’inférence partagée de Platform, adaptée aux tests. Le trafic de production doit passer par un point de terminaison dédié :
| Inférence partagée | Point de terminaison dédié | |
|---|---|---|
| Service | Partagé entre les utilisateurs de Platform | Un modèle, un seul locataire |
| Régions | Ta région de données (US, EU ou AP) | L’une des 42 régions |
| Limite de débit | 20 requêtes par minute et par clé | Aucune limite Platform pour les appels directs |
| Taille de la requête | Environ 4,5 MB | 32 MB, jusqu’à 1 heure par requête (la vidéo est prise en charge) |
| Authentification | N’importe quelle clé API de l’espace de travail | Uniquement la clé associée au déploiement |
Créer et dimensionner le point de terminaison#
Ouvre l’onglet Deploy du modèle. Ton navigateur mesure la latence vers les 42 régions (14 dans les Amériques, 13 en Europe, 12 en Asie-Pacifique, 3 au Moyen-Orient et en Afrique), puis trie le tableau en fonction de celle-ci :
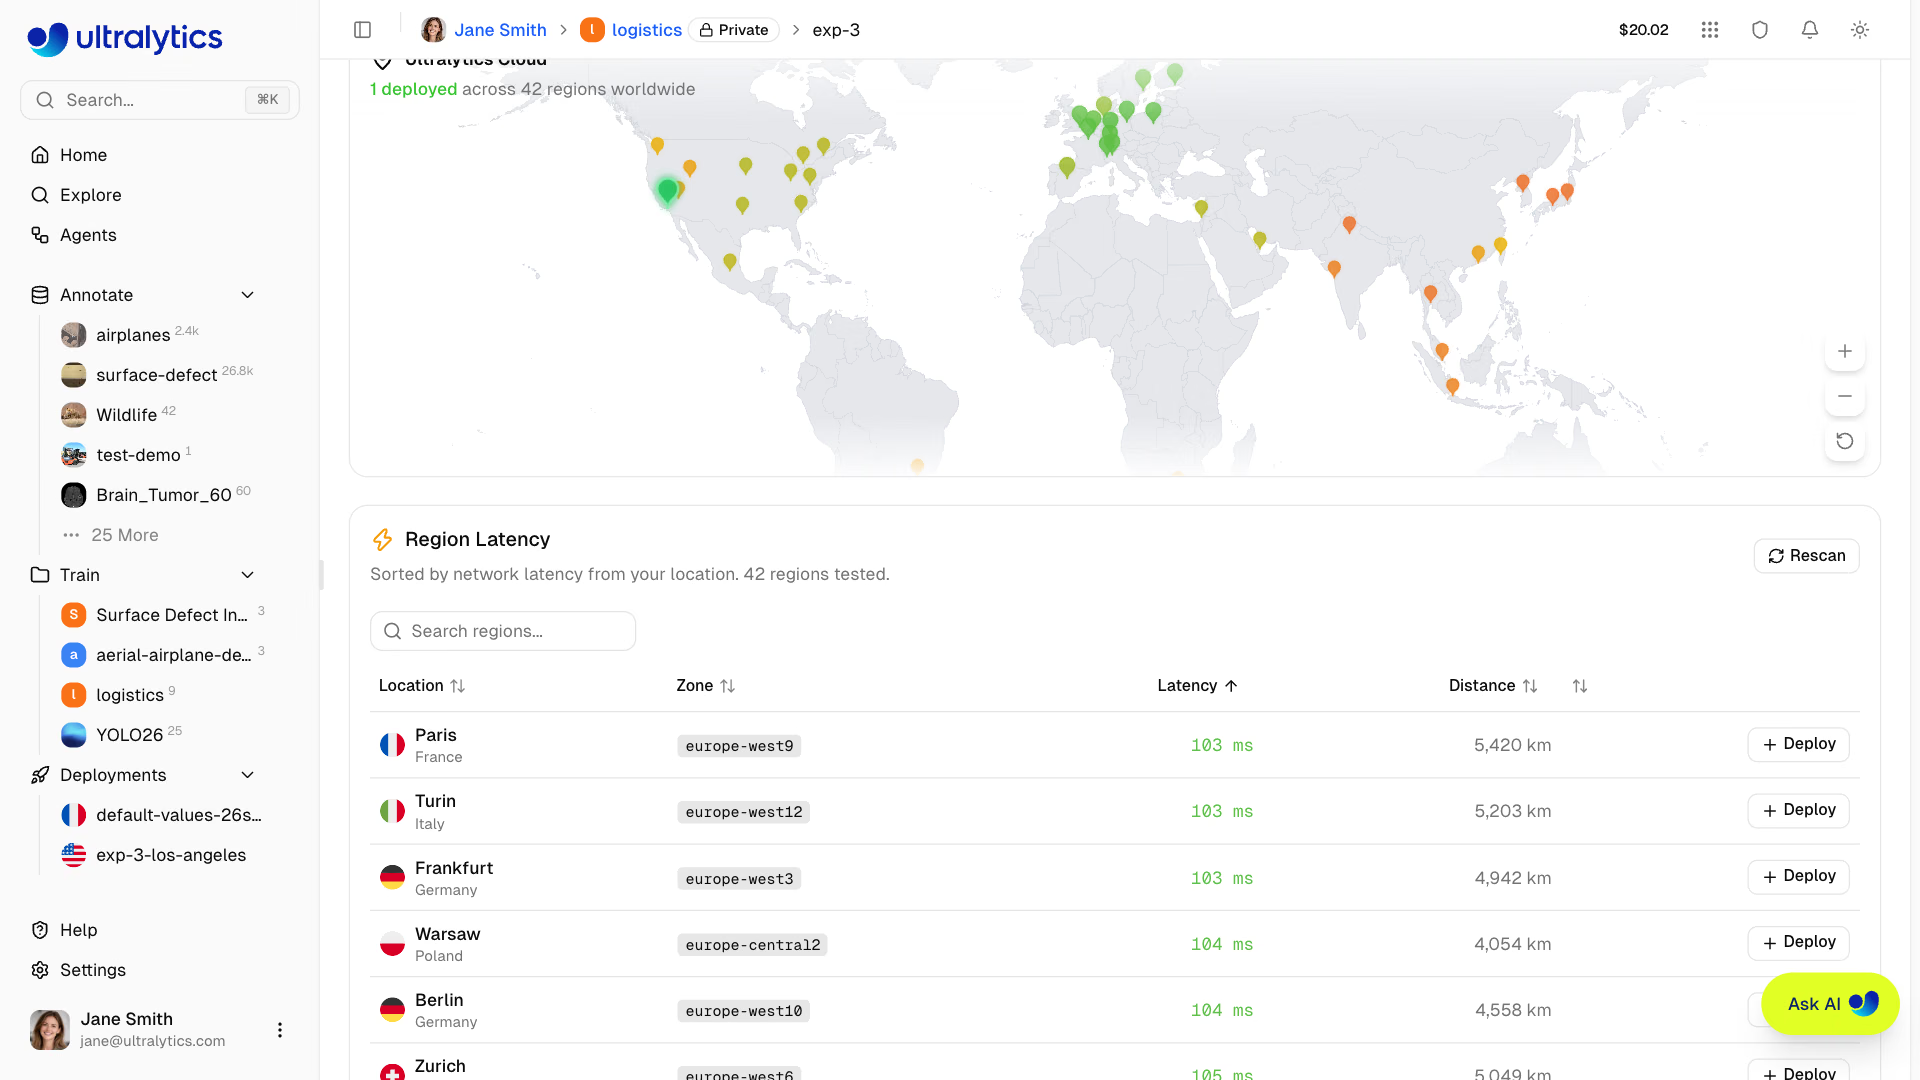
Clique sur Deploy sur la ligne correspondant à la région la plus proche de tes utilisateurs, vérifie le CPU, la mémoire, le prix et le nom généré (par exemple yolo26n-iowa), puis clique sur Create Deployment. Tu peux aussi commencer avec New Deployment dans l’onglet Deployments de ton profil :
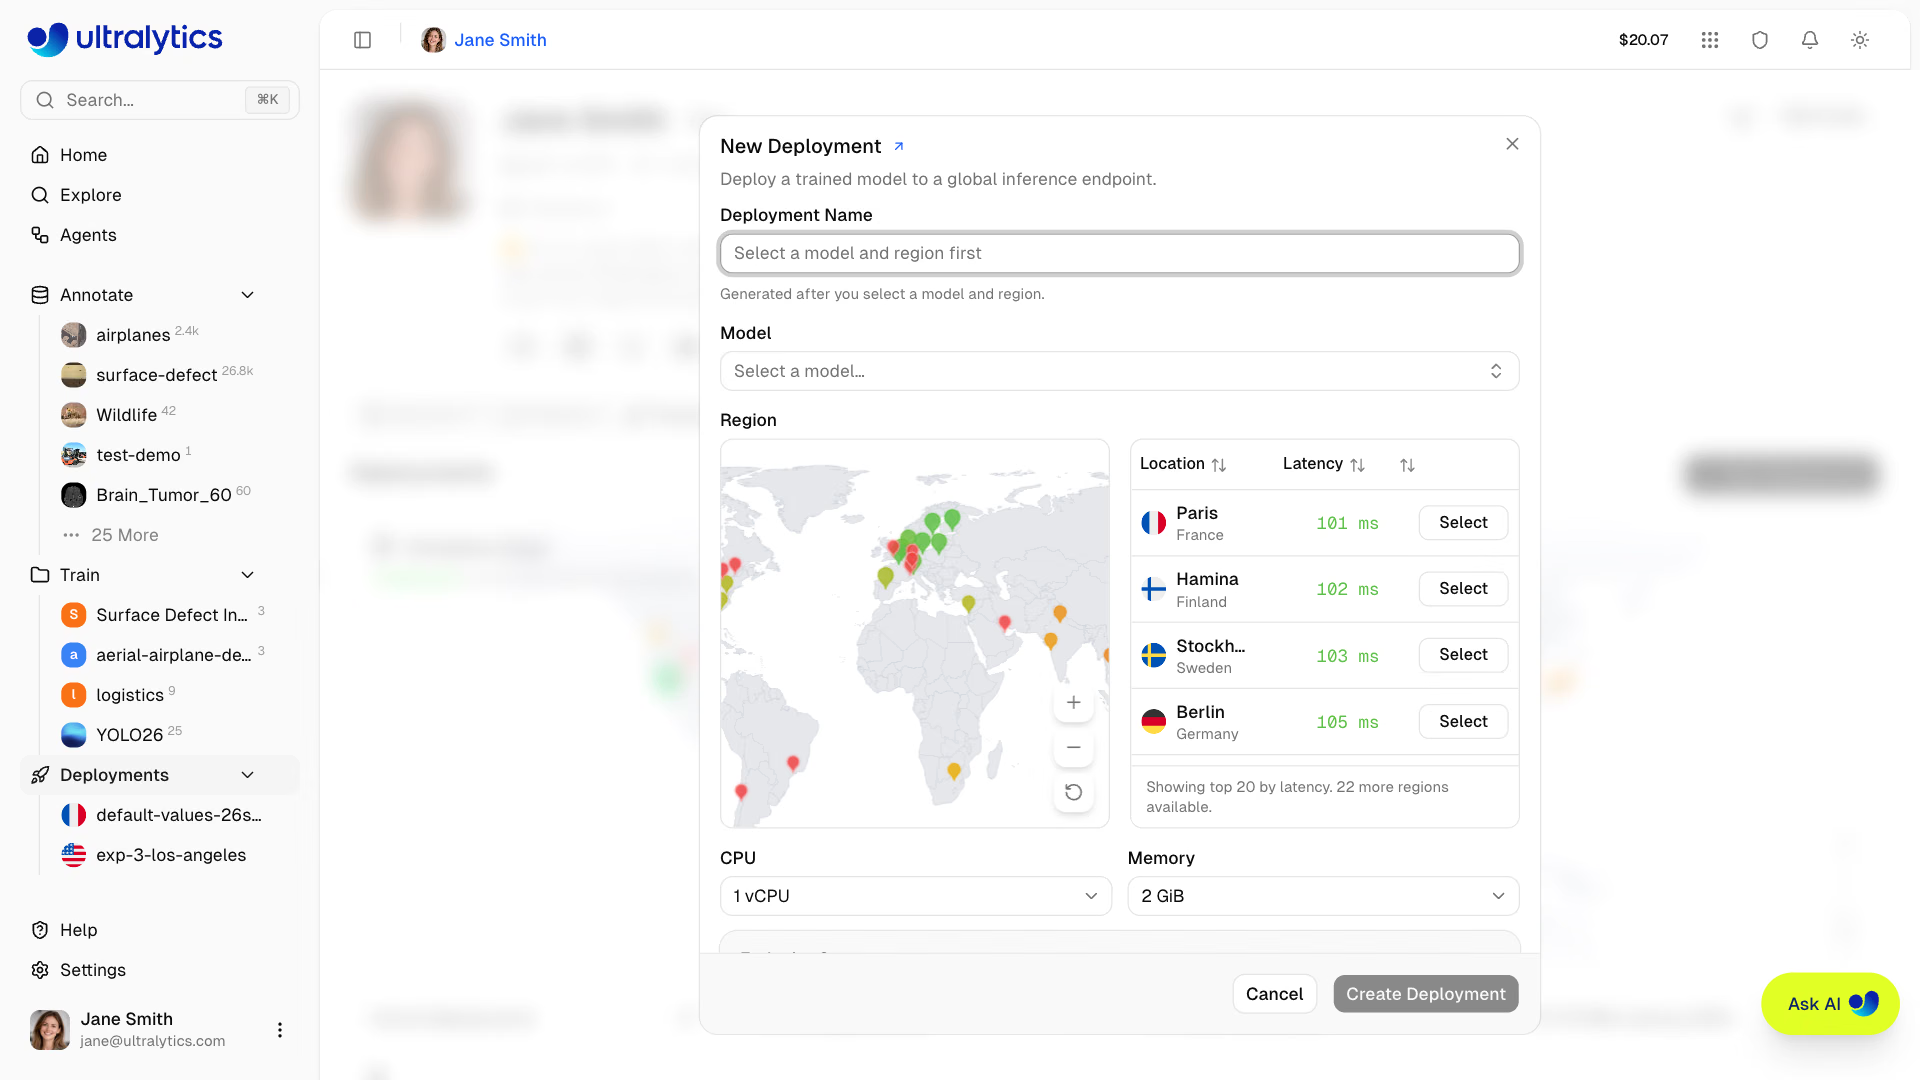
Dimensionne selon le profil de trafic :
| Trafic | Volume | Coût |
|---|---|---|
| Traitements par lots, outils internes, démonstrations avec des pics de trafic | Valeurs par défaut : 1 vCPU, 2 GiB ; mise à l’échelle jusqu’à zéro | Gratuit avec tous les forfaits |
| Trafic temps réel continu qui ne peut pas attendre un démarrage à froid | Taille personnalisée (1–8 vCPU, 2–32 GiB) avec une instance toujours active | Facturation horaire dès que l’instance est prête et jusqu’à son arrêt, y compris lorsqu’elle est inactive : environ 0,12 $/h pour 1 vCPU et 4 GiB dans l’Iowa |
| Utilisateurs répartis sur plusieurs continents | Un point de terminaison par région, derrière ton propre routeur | Chaque point de terminaison est facturé selon sa taille |
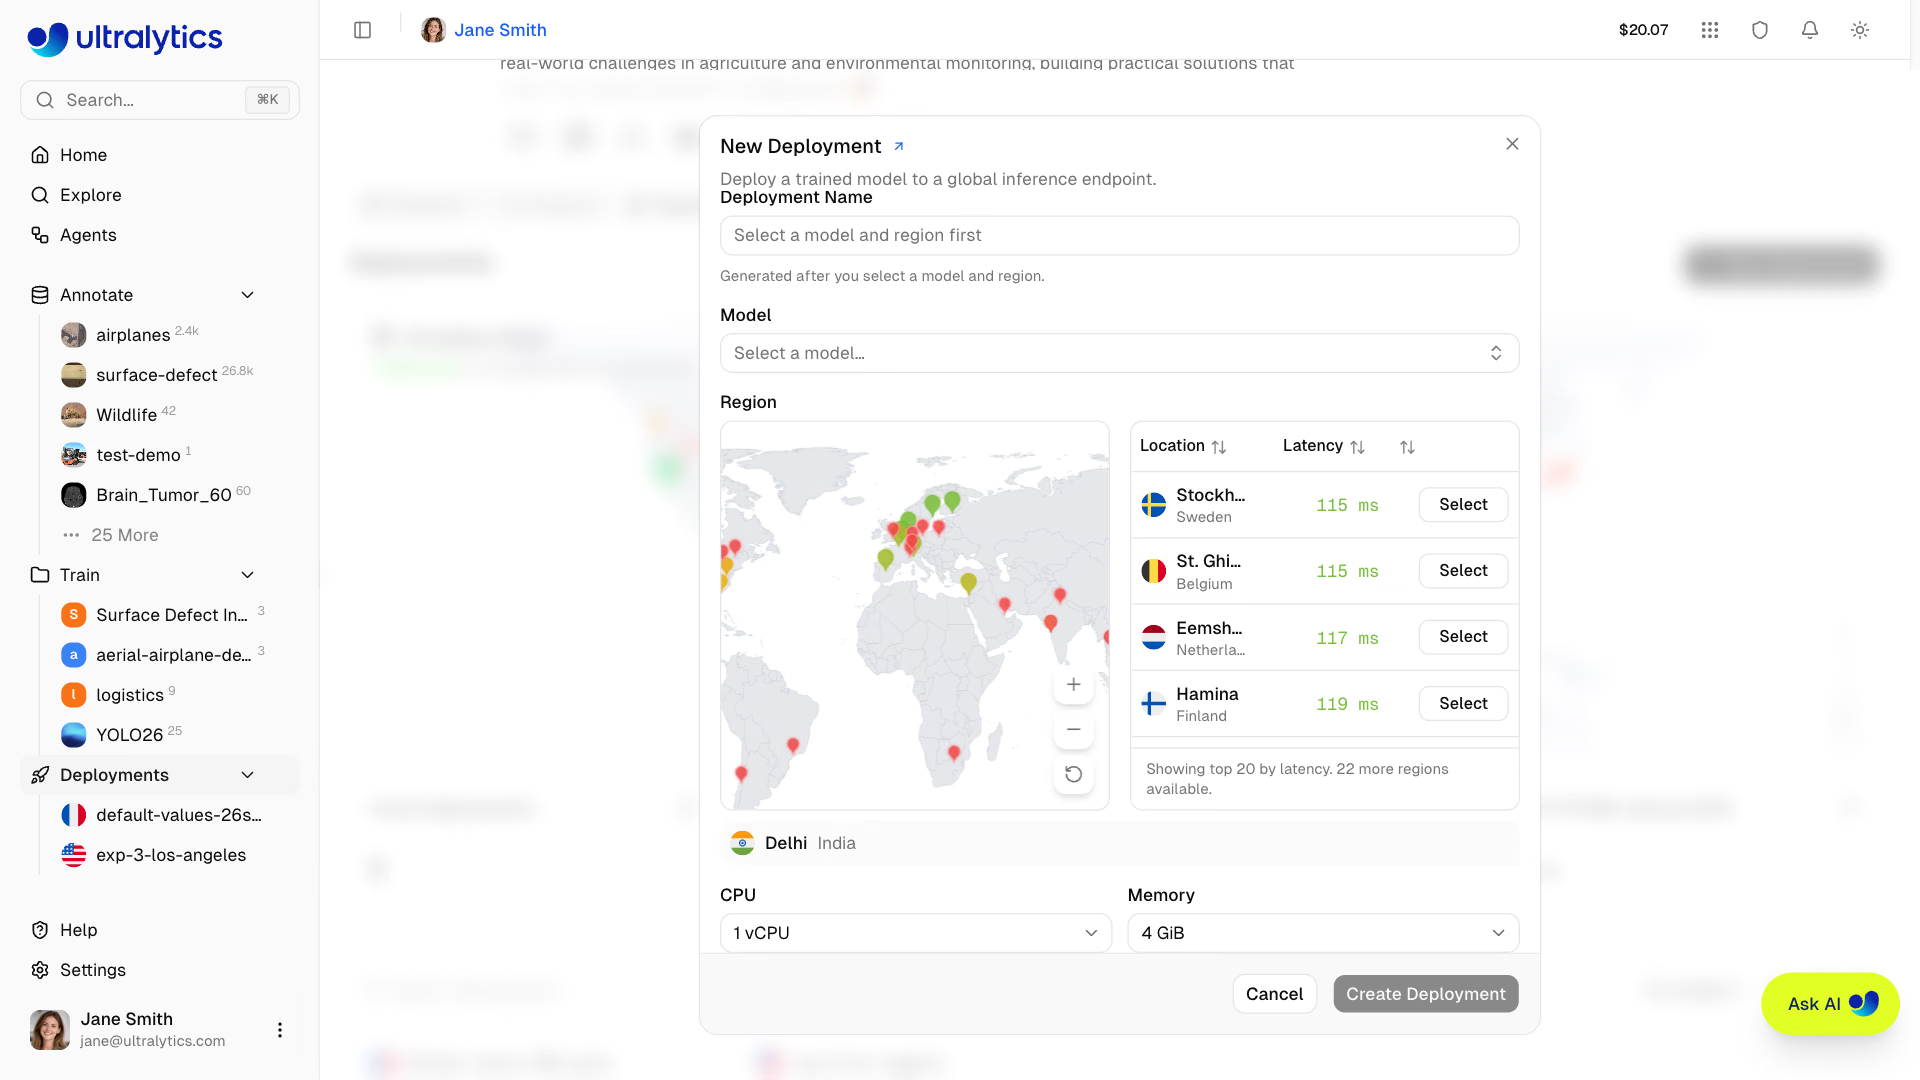
Les forfaits autorisent 3 (Free), 10 (Pro) ou un nombre illimité (Enterprise) de déploiements, et les points de terminaison arrêtés sont aussi comptabilisés. Le point de terminaison accepte le trafic dès que son badge indique Ready :
Exemple détaillé : un client prêt pour la production#
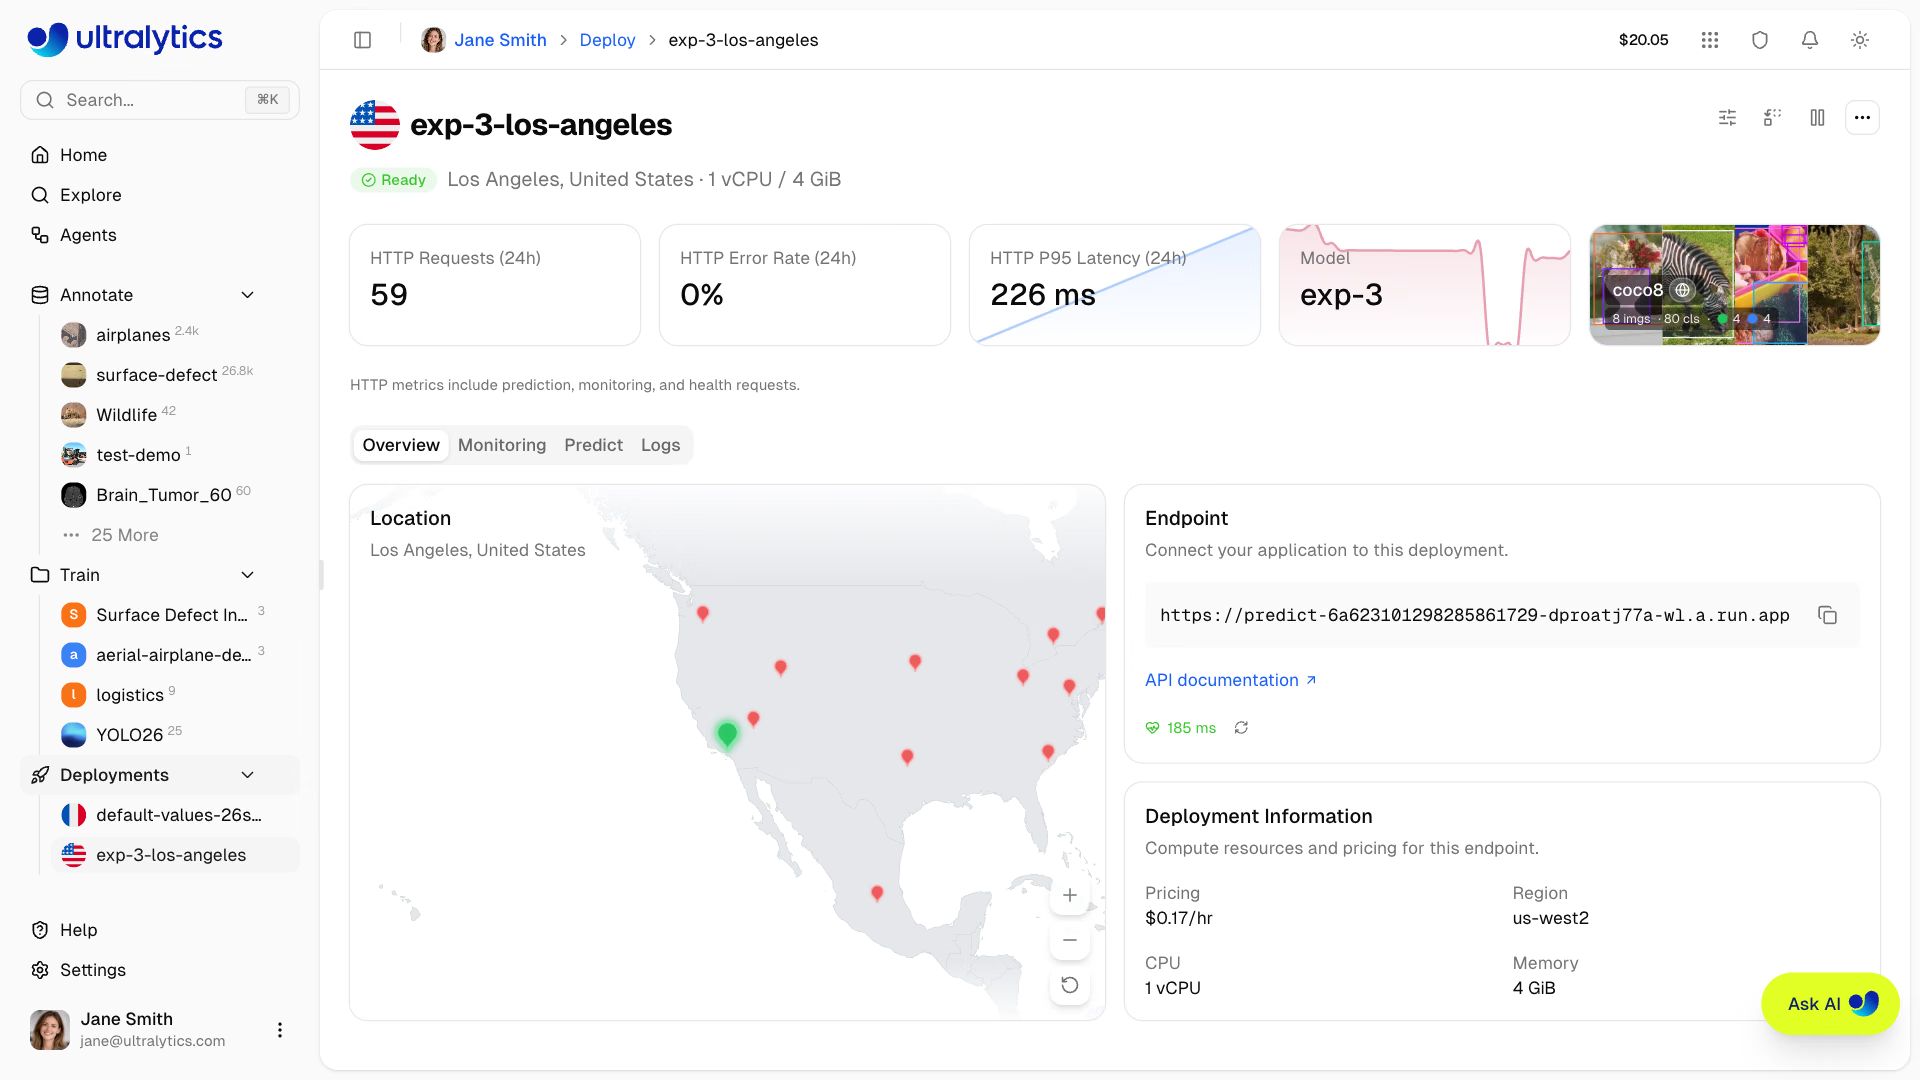
Chaque point de terminaison dispose d’une URL comme https://predict-<id>-<hash>-<region>.a.run.app qui sert /predict (POST), /health et une page interactive /docs. Il n’accepte que la clé API associée lors de sa création ; les propriétaires de l’espace de travail voient cette clé préremplie dans l’onglet Predict du déploiement, sous Docs, à côté des extraits Python, JavaScript et cURL. Ces extraits effectuent une seule requête ; le code de production doit aussi gérer un démarrage à froid et une instance très sollicitée :
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Nous l’avons testé avec un serveur factice local qui répond une fois à 429, puis renvoie un véritable résultat YOLO26n pour bus.jpg dans le format de réponse du point de terminaison :
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
Voici, ligne par ligne, les décisions importantes :
timeout=90couvre un démarrage à froid pouvant durer environ une minute ; les délais d’attente par défaut de la plupart des clients HTTP sont bien plus courts.- Les erreurs 429 et 5xx font l’objet de nouvelles tentatives, en respectant
Retry-Afterlorsque le point de terminaison l’envoie. Chaque point de terminaison traite les requêtes depuis une seule instance et rejette les requêtes excédentaires avec429lorsqu’il est surchargé. - Les autres erreurs 4xx entraînent un échec immédiat :
401indique une clé incorrecte et413un corps de requête dépassant 32 MB ; aucune de ces erreurs ne se corrige d’elle-même. - La réponse contient une entrée par image (ou par image vidéo) dans
images, chacune avecresults(class,name,confidence,boxavecx1,y1,x2,y2) etspeeden millisecondes.
Les champs de formulaire facultatifs sont conf (valeur par défaut : 0.25), iou (0.7), imgsz (la taille utilisée pour entraîner le modèle), vid_stride pour la vidéo et normalize=true pour des coordonnées comprises entre 0 et 1. L’équivalent cURL utilise une ligne par champ :
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Déployer de nouvelles versions sans changer l’URL#
Replace model sur la page du déploiement remplace le modèle par un autre modèle terminé du même espace de travail. L’ancien modèle continue de répondre jusqu’à ce que le nouveau soit prêt, l’URL, la région et la clé restent identiques et, si le déploiement échoue, l’ancien modèle reste actif. Pour revenir en arrière, effectue la même action en sélectionnant le modèle précédent ; garde-le donc dans le projet. Update configuration redimensionne le déploiement sur place, et Stop suspend la facturation tout en conservant l’URL.
Certains changements nécessitent un nouveau point de terminaison : les régions sont fixes (pour en changer, supprime le point de terminaison et recrée-le avec une nouvelle URL) et les domaines personnalisés ne sont pas pris en charge. Si tes clients ont besoin d’un nom d’hôte de marque stable, place ta propre passerelle devant le point de terminaison. Pour exécuter le modèle en dehors de Platform, exporte-le (Exporter pour le déploiement) ou héberge-le toi-même derrière Triton Inference Server.
Pièges#
Symptôme : ton point de terminaison reçoit du trafic que tu ne peux pas expliquer. Correctif : ne mets jamais la clé dans une application Web ou mobile ; appelle le point de terminaison depuis ton backend. Supprimer ou désactiver la clé associée ne verrouille pas le point de terminaison, car celui-ci accepte toujours cette chaîne de clé. Pour révoquer l’accès, arrête ou supprime le déploiement, puis crée-en un nouveau associé à une clé neuve.
Symptôme : la première requête du matin échoue, mais la nouvelle tentative réussit. Correctif : les points de terminaison de taille par défaut passent à zéro. Utilise un délai d’expiration d’au moins 90 secondes, préchauffe le point de terminaison avec un appel /health avant le trafic attendu, ou passe à une taille personnalisée si chaque requête doit être rapide.
Symptôme : les téléversements échouent avec 413. Correctif : les points de terminaison dédiés acceptent des corps de requête allant jusqu’à 32 MB. Découpe les longues vidéos en clips plus courts ou envoie des images échantillonnées, et transmets vid_stride pour ignorer des images côté serveur.
Afficher la solution
Exemple de réponse pour la caméra de la ligne de production des pilules : déploie v2-finetune dans europe-west1 (Saint-Ghislain, la région présentant la latence la plus faible depuis l’usine allemande) avec la taille par défaut. Requête à froid après une heure d’inactivité : 38 s, absorbées par le délai d’attente de 90 secondes ; requête à chaud : 0,3 s. Décision : l’automate programmable industriel (PLC) de la ligne envoie une image toutes les 30 secondes pendant les équipes, donc le point de terminaison reste chaud toute la durée de l’équipe et seule la première image entraîne un démarrage à froid. Un appel /health depuis le contrôleur de la ligne, 2 minutes avant chaque équipe, élimine aussi ce délai ; on conserve donc la taille par défaut gratuite, ce qui permet d’économiser environ 90 $ par mois par rapport à une instance personnalisée de 1 vCPU et 4 GiB. En remplaçant le modèle par v1-baseline, la même URL renvoie les résultats de v1 ; remplace-le à nouveau par v2 pour terminer.