Boîtes et masques : quand as-tu vraiment besoin de la segmentation ?
Mesure ce que le masque apporte par rapport à la boîte sur une image réelle, puis détermine si ton projet a réellement besoin de la forme en fonction du composant qui exploite les données.
Les masques correspondent à ce que la plupart des gens imaginent lorsqu'ils pensent à la vision par IA, et c'est là que les équipes consacrent le plus gros budget à l'annotation. Un masque indique la forme exacte d'un objet ; une boîte indique seulement où il se trouve. Cette différence détermine entièrement certains produits — et ne change rien pour la plupart d'entre eux.
Pratique
Ce qu'apporte un masque#
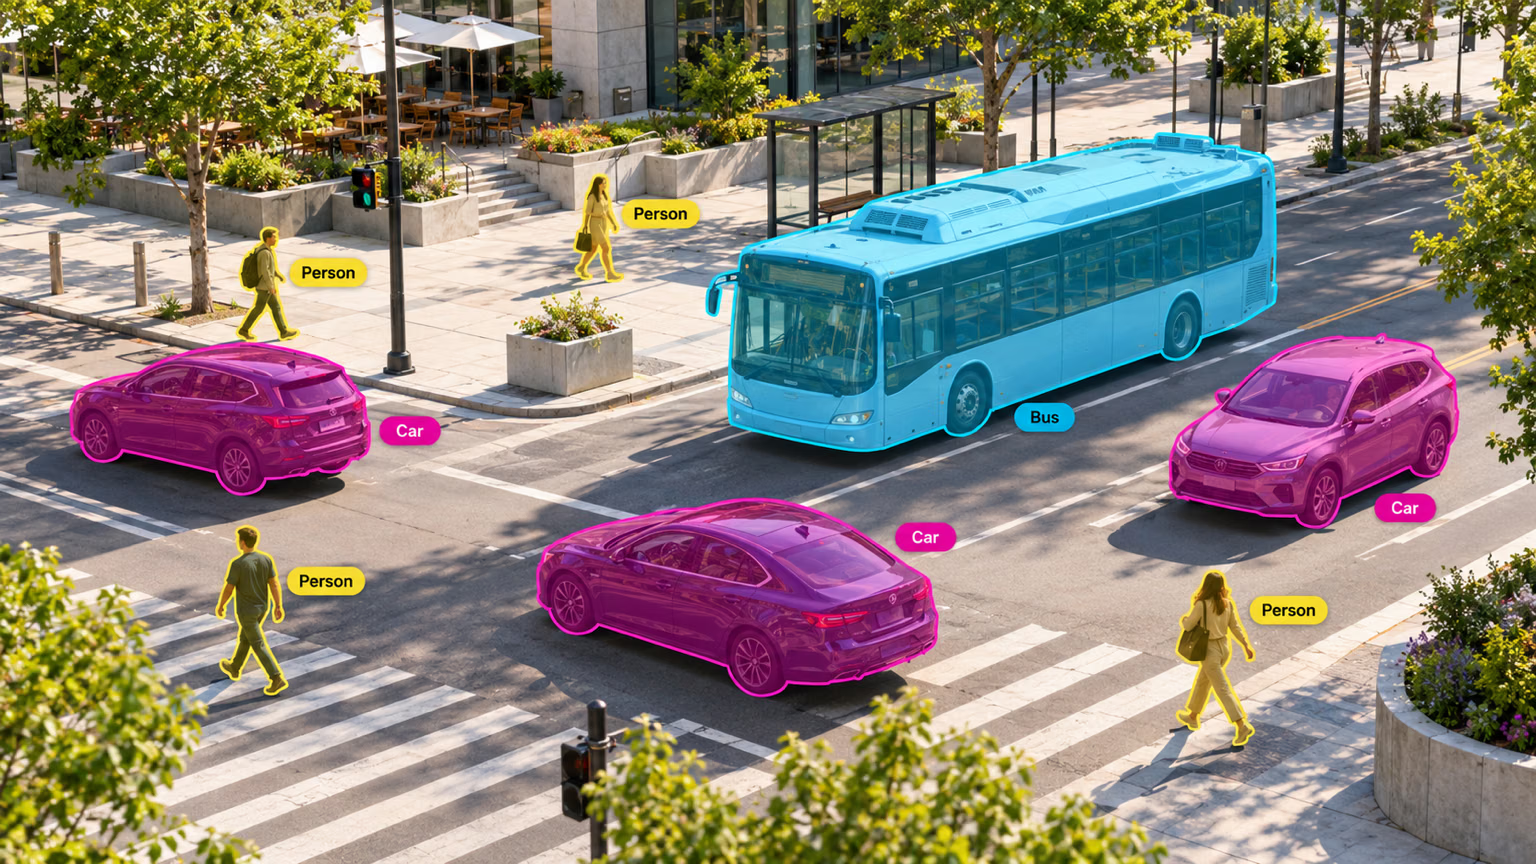
Pour chaque objet, la tâche Segment renvoie tout ce qu'un détecteur renvoie — classe, boîte, confiance — ainsi que les pixels qui appartiennent à l'objet ; chaque voiture ci-dessus a donc son propre contour, distinct du bus et des piétons. Lis le masque sous forme de polygone (masks.xy) ou d'image binaire (masks.data).
Dans quelle mesure la forme change-t-elle les chiffres ? Compare la surface de la boîte de chaque objet à celle de son masque :
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)Le bus n'occupe que 62 % de sa boîte, et une personne n'en occupe que 31 %. Toute valeur calculée à partir des seules boîtes — surface peinte, taille d'un déversement, espace vide sur une étagère — serait faussée dans cette proportion. Si ton produit communique un chiffre de ce type, tu as besoin de masques. S'il ne fait que compter ou localiser, les pixels supplémentaires ne changent rien.
Symptôme : des zones de masque qui semblent 3 à 4 fois trop petites par rapport aux zones des boîtes. Cause : par défaut, masks.data est renvoyé à la taille d’inférence (ici, 640×480), tandis que les boîtes sont exprimées en pixels de l’image d’origine (1080×810). Solution : passe retina_masks=True, comme ci-dessus, ou mets toi-même les nombres à l’échelle.
Décide en fonction de l'utilisation en aval, pas de la démo#
| Besoin en aval | Les boîtes suffisent ? | Pourquoi |
|---|---|---|
| Compter les objets ou vérifier leur présence | Oui | L'emplacement suffit à répondre |
| Déclencher une alerte lorsqu'un objet entre dans une zone | Oui | Il suffit qu'une boîte franchisse une ligne |
| Suivre les objets d'une image à l'autre | Oui | Les traqueurs associent les boîtes |
| Recadrer pour un second classificateur | Oui | Le recadrage nécessite uniquement la boîte |
| Mesurer la surface ou la couverture (mauvaises herbes, rouille, déversements) | Non | Avec des formes irrégulières, la surface de la boîte n'a pas de sens |
| Détourer l'objet (suppression de l'arrière-plan, RA) | Non | Tu as besoin du contour exact |
| Vérifier le dégagement ou le contact (préhension robotique, collision) | Non | La boîte surestime la taille de l'objet |
| Séparer des objets irréguliers qui se touchent | Souvent, non | Les boîtes qui se chevauchent rendent floue l'attribution des pixels |
Si chaque ligne dont ton produit a besoin indique « oui », déploie un détecteur. Opte pour la segmentation YOLO26 uniquement si la forme apporte une réelle valeur.
Segmentation d'instances ou sémantique#
La segmentation d'instances attribue un masque à chaque objet ; trois voitures qui se chevauchent restent donc trois voitures. La segmentation sémantique attribue une classe à chaque pixel, et rien de plus : tous les pixels des voitures forment une seule région « voiture », et le décompte disparaît. Utilise la segmentation d'instances pour compter ou mesurer des objets individuels — cellules, fruits, défauts. Utilise la segmentation sémantique pour mesurer la couverture de régions — route et trottoir, cultures et sol.
Le coût d'annotation de la forme#
Une boîte nécessite deux clics. Un bon polygone peut en nécessiter des dizaines, et chaque contour est une source de désaccord entre annotateurs : le sac fait-il partie de la personne, l'ombre fait-elle partie de la voiture ? Mesure ton coût réel au lieu de te fier à une règle empirique : chronomètre l'annotation de 20 objets sous forme de boîtes, puis des mêmes 20 objets sous forme de polygones, et multiplie la différence par la taille de ton jeu de données.
Les outils d'annotation assistée par l'IA réduisent considérablement l'écart. Smart Annotation et Batch Labeling propose un masque à partir d'un clic ou d'une boîte, de sorte que les annotateurs corrigent les contours au lieu de les tracer — mais quelqu'un doit toujours vérifier chaque limite.
Décide comment traiter les occultations, les objets transparents, les ombres, les objets coupés par le bord de l’image et les éléments attachés (sacs, poignées, charges) avant de commencer l’étiquetage, et remets le même document aux annotateurs et aux réviseurs. Bonnes pratiques d’annotation explique comment les faire respecter ; le jeu de données COCO-Seg montre des masques cohérents à grande échelle.
Lors de la vérification ponctuelle des masques, recherche les débordements (le masque dépasse le contour), les trous (des régions à l'intérieur de l'objet sont oubliées), les contours fantômes (le masque suit un artefact JPEG) et les parties ambiguës (la poignée de la valise fait-elle partie du masque de la valise ?).
Afficher la solution
Supposons que deux produits partagent la caméra du bus : un compteur de personnes et un rapport d'occupation de la rue qui indique quelle proportion de la scène est occupée par les véhicules. Mesure les deux résultats à partir de la même exécution :
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- Compteur de personnes → boîtes. Le compte est de 4 dans les deux cas ; les masques augmentent le coût d'annotation sans rien changer.
- Rapport d'occupation → masques. Les boîtes indiquent que le bus occupe 47 % de la scène ; en réalité, il en occupe 29 %. Un rapport fondé sur les boîtes serait erroné de plus de moitié.