첫 번째 모델 학습하기
한 번의 호출로 데이터셋에 YOLO26을 파인튜닝하고, 실시간 학습 로그를 한 줄씩 읽은 다음, 실행 폴더에서 best.pt와 주요 플롯을 찾으세요.
객체 감지 모델을 처음부터 학습하려면 며칠이 걸리고 대규모 데이터셋이 필요합니다. 약 100개의 이미지로 사전 학습된 YOLO26을 파인튜닝하면 노트북 CPU에서 약 1분이면 됩니다. 전이 학습이 모델이 모서리, 형태, 객체에 대해 이미 학습한 내용을 재사용하기 때문입니다.
이 강의에서는 pill 데이터셋으로 학습하고, mAP50-95가 거의 0인 기준값에서 10 에포크 동안 0.66까지 상승하는 것을 확인하며, 실행이 정상적으로 진행되는지 아니면 시간을 낭비하는지 로그를 통해 초기에 판단하는 방법을 알아봅니다.
실습형
예제: 알약 감지 모델 학습#
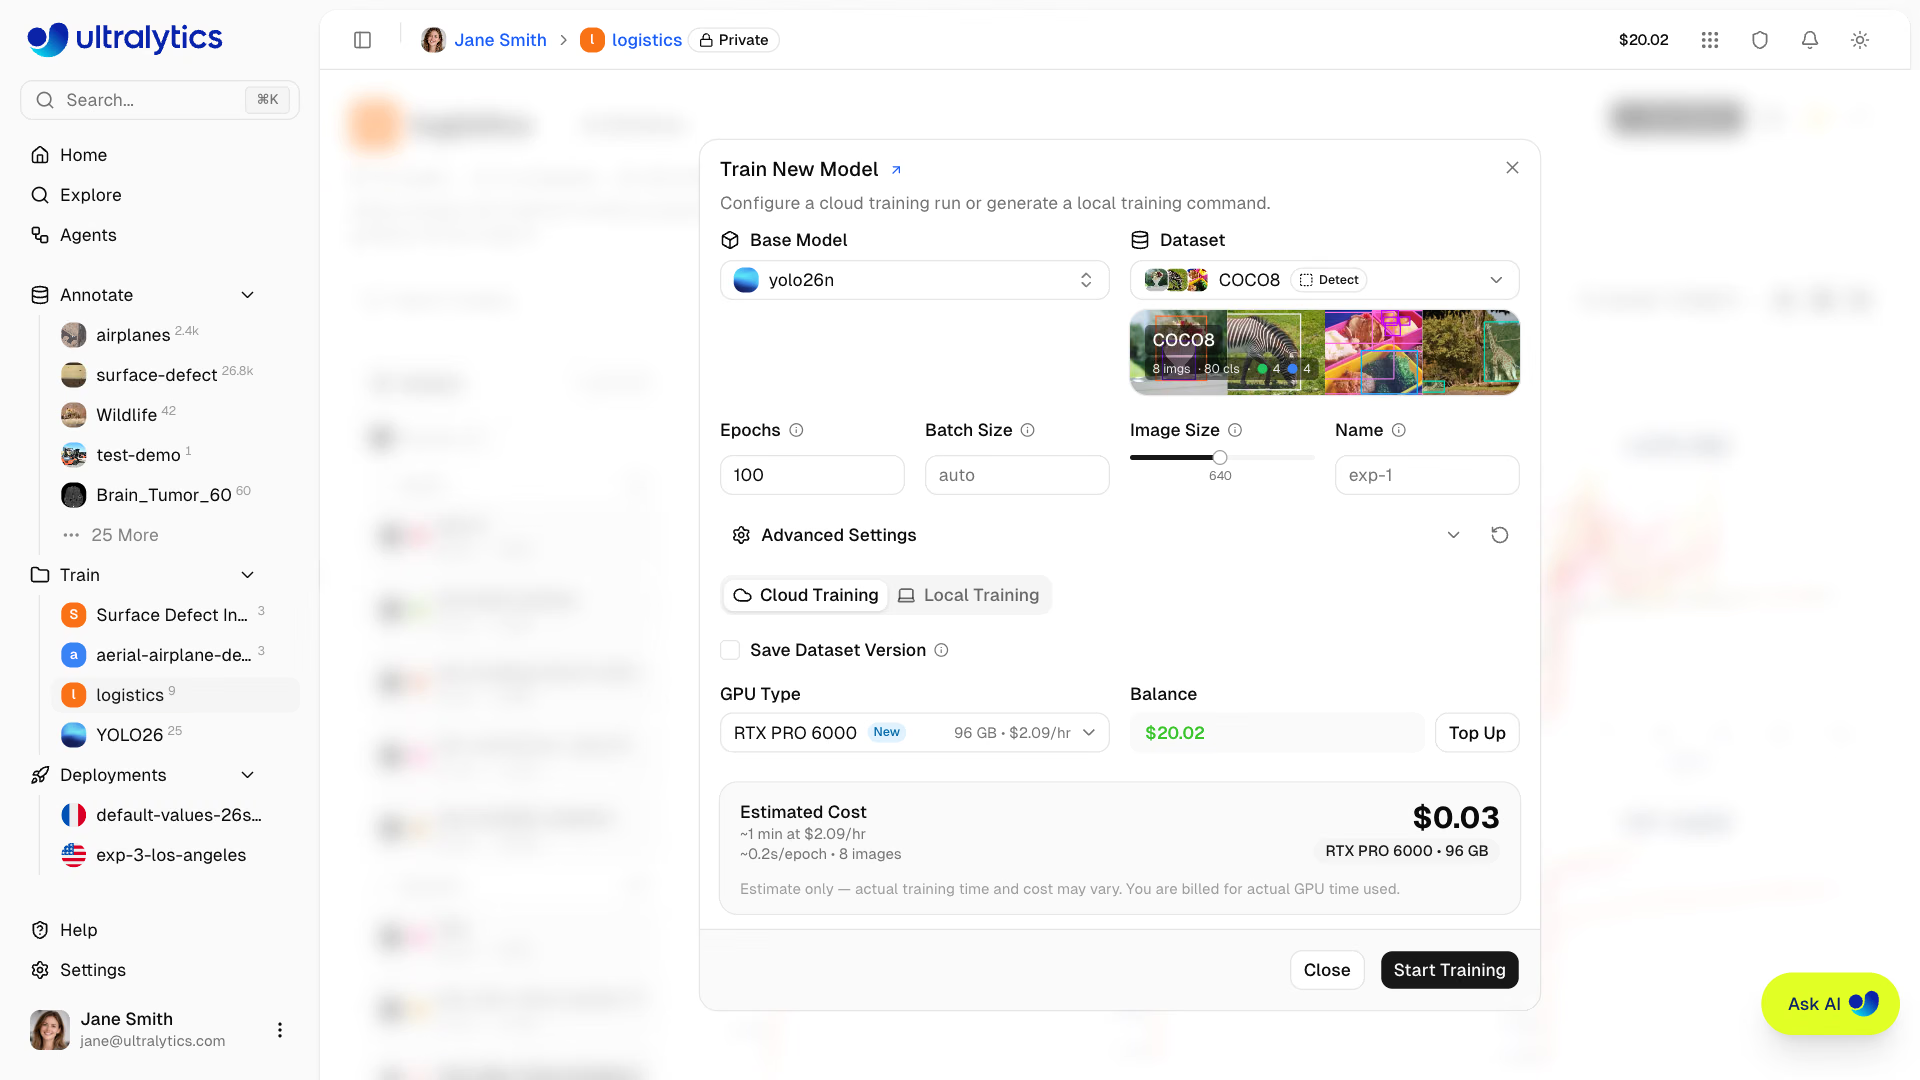
Ultralytics Platform의 새 모델 학습 대화상자에서는 아래 코드와 같은 항목, 즉 기본 모델, 데이터셋, 에포크, 이미지 크기를 선택할 수 있습니다. 선택한 설정은 클라우드 GPU에서 실행하거나 이에 맞는 로컬 명령을 생성할 수 있습니다. 이 설정은 노트북 CPU에서 약 1분이면 완료됩니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # COCO로 사전 학습됨
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)CLI와 Python은 동일합니다. epochs=10와 imgsz=320을 설정하면 CPU 실행 시간을 줄일 수 있습니다. GPU에서는 두 값을 모두 제거하고 기본값(epochs=100, imgsz=640)을 사용하세요. 에포크와 픽셀 수가 많을수록 거의 항상 성능이 향상되기 때문입니다. 학습 모드는 이 반복 작업을 대신 실행합니다:
로그를 한 줄씩 읽기#
실제 출력에서 처음과 마지막 두 에포크만 남긴 결과입니다:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...): 기본optimizer=auto이 최적화 프로그램과 학습률을 자동으로 선택했습니다.Using 92 train, 23 val images: 데이터셋과 일치하는지 확인하세요. 숫자가 더 작으면 건너뛴 이미지가 있다는 뜻입니다.GPU_mem 0G: CPU에서 학습 중입니다. GPU에서는 여기에 메모리 사용량이 표시됩니다. GPU가 있는 컴퓨터에서0G이 표시되면 GPU를 사용하고 있지 않은 것입니다.- 각 에포크의 첫 번째 행: 학습 분할의 세 가지 손실과 마지막 배치에 포함된 레이블 객체 수(
Instances), 이미지 크기가 표시됩니다. - 각 에포크의
all행: 검증 분할의 정밀도, 재현율, mAP50, mAP50-95가 표시됩니다. 주의 깊게 살펴봐야 하는 행입니다.
| 열 | 의미 | 정상적인 추세 |
|---|---|---|
box_loss | 예측 박스와 레이블 박스 사이의 차이 | 감소한 다음 평탄해짐 |
cls_loss | 클래스 점수가 얼마나 잘못되었는지 | 감소한 다음 평탄해짐 |
l1_loss | YOLO26의 직접적인 박스 좌표 오차 | 감소 |
P, R | 검증 분할의 정밀도 및 재현율 | 상승하고 균형 유지 |
mAP50, mAP50-95 | 감지 품질입니다. mAP50-95는 박스가 얼마나 정확하게 맞는지도 반영합니다. | 상승한 다음 정체 |
이 경우 mAP50-95는 기준값 0.0002에서 한 에포크 후 0.548, 10 에포크 후 0.659로 상승했습니다. 4번째 에포크에서 정밀도가 0.80으로 떨어졌다가 회복했습니다. 검증 이미지가 23개뿐이라 단일 에포크의 결과는 변동이 큽니다. 한 행이 아니라 추세를 기준으로 판단하세요. 실행 중 적용할 판단 기준:
- 손실이 감소하고 mAP가 상승합니다: 계속 실행하세요.
- 첫 번째 에포크부터 손실이 변하지 않습니다: Ctrl+C로 중지하고 레이블과 YAML을 확인하세요.
- 정밀도가 재현율보다 훨씬 높습니다: 모델이 지나치게 신중해 객체를 놓칩니다. 재현율이 정밀도보다 훨씬 높습니다: 실제로 없는 대상을 감지합니다.
- 여러 에포크 동안 mAP가 그대로입니다: 에포크를 늘려도 도움이 되지 않습니다. 데이터나
imgsz을 변경하세요.
세 가지 손실은 YOLO26 손실 함수의 구성 요소입니다. 성능 지표 가이드에서 각 지표를 자세히 설명합니다.
실행 결과물 확인하기#
모든 결과물은 runs/detect/pills_v1/에 저장됩니다:
| 파일 | 용도 |
|---|---|
weights/best.pt | 에포크 전체에서 검증 fitness가 가장 높은 체크포인트입니다. 추론과 내보내기에 사용하세요. |
weights/last.pt | 최신 체크포인트입니다. 중단된 실행을 재개할 때 사용합니다. |
args.yaml | 실행 재현에 필요한 모든 인수 |
results.csv, results.png | 에포크별 손실과 지표를 데이터 및 플롯으로 저장합니다. |
labels.jpg | 클래스 개수, 박스 크기 및 위치 히스토그램 |
train_batch*.jpg | 레이블이 그려진 증강 학습 배치 |
val_batch*_labels.jpg, val_batch*_pred.jpg | 검증 이미지의 정답과 예측 결과 |
confusion_matrix*.png, Box*_curve.png | 혼동 행렬 및 정밀도, 재현율, F1, PR 곡선 |
다른 항목을 확인하기 전에 train_batch0.jpg을 여세요. 박스가 객체에 맞지 않으면 레이블이 잘못된 것이며, 에포크를 아무리 늘려도 해결되지 않습니다.
먼저 변경할 인수#
| 인수 | 기본값 | 변경하는 경우 |
|---|---|---|
epochs | 100 | 짧은 CPU 실험 또는 과적합이 시작되는 소규모 데이터셋에서는 낮추세요. 여전히 개선 중인 대규모 데이터셋에서는 높이세요(200–300). |
imgsz | 640 | 작은 객체(1024 또는 1280으로 높이기) 또는 CPU 실험(낮추기) |
batch | 16 | 배치 크기: 메모리 부족 오류가 발생하면 낮추거나, -1을 사용해 GPU 메모리의 약 60%에 맞게 자동으로 설정하세요. |
patience | 100 | 검증 fitness가 N 에포크 동안 개선되지 않으면 조기 종료합니다(예: patience=20). |
device | 자동 | cpu, mps, 0와 같은 GPU 인덱스 또는 [0, 1]과 같은 여러 GPU를 지정합니다. |
name | train | 항상 변경된 내용을 기준으로 실행 이름을 지정하세요. |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")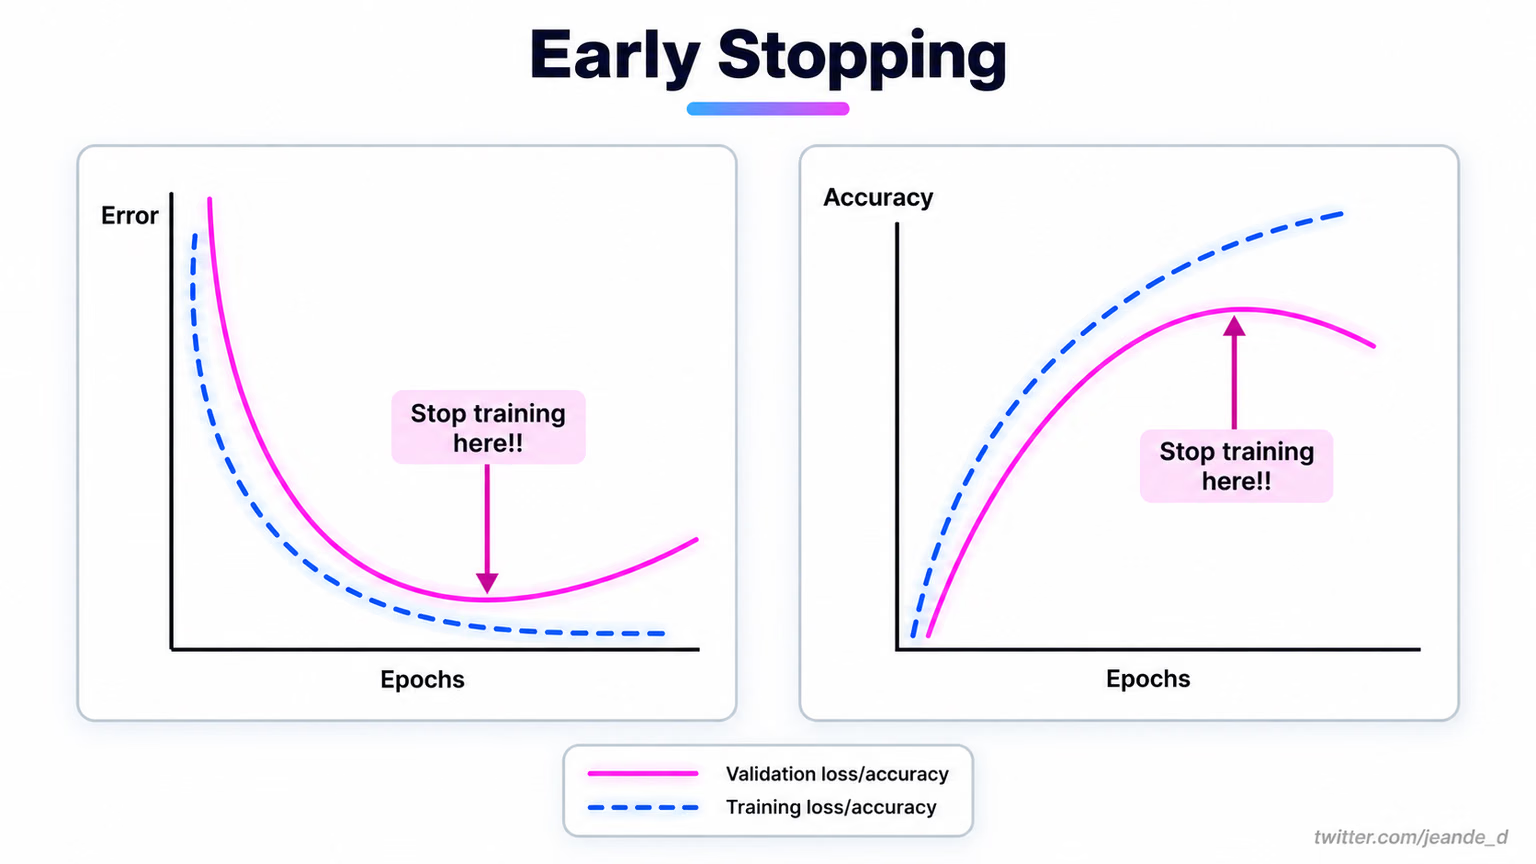
patience의 기본값 100을 사용하면 100에포크 실행은 조기 종료되지 않습니다. 값을 더 낮게 설정하면 위 곡선이 나타내는 대로 학습이 정체된 실행을 종료합니다. 어느 경우든 best.pt은 유지됩니다.
여러 GPU를 사용하는 경우 device=[0, 1, 2, 3]과 같은 목록을 전달하세요. Ultralytics가 분산 데이터 병렬(DDP) 학습을 시작하며, batch은 GPU 전체의 총합입니다. 기본적으로 학습에는 혼합 정밀도가 사용됩니다(amp=True). 노트북에서 실행하기 어려워지면 Ultralytics Platform의 클라우드 GPU에서 동일한 데이터셋과 인수를 실행할 수 있습니다. 자세한 내용은 실행 학습, 확인 및 파인튜닝을 참고하세요.
이런 실수는 피하세요#
증상: 작은 데이터셋에서 여러 에포크를 학습해도 mAP가 거의 0입니다. 원인: 모델이 yolo26n.pt 대신 yolo26n.yaml(랜덤 가중치)에서 시작했습니다. 해결 방법: 항상 사전 학습된 .pt에서 시작하세요. 처음부터 학습하는 방식은 백본 연구나 매우 큰 데이터셋에만 효과가 있습니다.
증상: 첫 번째 에포크에서 CUDA out of memory이 발생합니다. 해결 방법: batch을 절반으로 줄이거나 batch=-1를 설정해 AutoBatch가 메모리에 맞는 크기를 선택하도록 하세요. imgsz을 낮춰도 도움이 되지만, 모델이 볼 수 있는 범위가 달라집니다.
last.pt은 마지막 에포크의 결과이며 이전 에포크보다 성능이 낮을 수도 있습니다. best.pt은 검증 피트니스가 가장 높았던 에포크이며, 검증과 내보내기, 배포에 사용해야 하는 파일입니다.
나머지 인수는 모델 학습 팁 가이드에서, 하이퍼파라미터 튜닝 가이드에서는 학습률 탐색과 유전 알고리즘 튜너를 확인할 수 있습니다. 파인튜닝 가이드에서는 레이어 고정 방법을 다룹니다.
정답 보기
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pills하드웨어와 패키지 버전에 따라 정확한 숫자는 약간 달라집니다.