사용자 지정 데이터셋 준비하기
이미지와 레이블을 Ultralytics YOLO 형식으로 구성하고, 픽셀 좌표 상자를 정규화된 레이블 행으로 변환한 뒤, 학습 전에 잘못된 레이블을 찾아냅니다.
폴더 이름을 잘못 지정하거나 레이블을 정규화하지 않아도 학습이 중단되지는 않습니다. Ultralytics는 문제가 있는 이미지를 건너뛰고 계속 진행하므로, 데이터 일부만으로 학습하게 됩니다. 그 결과 성능이 평범한 모델을 얻고 원인을 엉뚱한 곳에서 찾느라 오후 시간을 허비하게 됩니다.
이 단원에서는 객체 탐지 데이터셋의 실무적인 구성 요소인 폴더, 레이블 행, 변환 및 검사를 다룹니다. 이 과정의 나머지 단원에서 학습에 사용하는 실제 115장 규모의 의료용 알약 데이터셋을 다룹니다. 무엇을 수집하고 어떻게 레이블을 지정할지는 어노테이션 모범 사례에서 설명합니다.
실습형
실습 데이터셋 다운로드하기#

아래 구성은 Ultralytics Platform의 새 데이터셋 대화상자에서 ZIP 파일로도 허용하므로, 여기서 준비한 데이터셋을 그대로 업로드할 수 있습니다. 블리스터 포장 알약 이미지의 학습 프레임 92장과 검증 프레임 23장을 다운로드한 뒤 my_dataset에 압축을 푸세요:
curl -L -o medical-pills.zip https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zip
unzip -q medical-pills.zip -d my_dataset
my_dataset/
├── images/
│ ├── train/ Frame_0.jpg, Frame_100.jpg, ... (92 images)
│ └── val/ Frame_144.jpg, ... (23 images)
└── labels/
├── train/ Frame_0.txt, Frame_100.txt, ... (92 files)
└── val/ Frame_144.txt, ... (23 files)매니페스트는 없습니다. Ultralytics는 이미지 경로에서 /images/을 /labels/로 바꾸고 확장자를 .txt로 바꾸어 각 레이블을 찾습니다. 따라서 images/val/Frame_144.jpg은 labels/val/Frame_144.txt를 읽습니다. 이에 따른 사항은 두 가지입니다:
- 폴더 이름을 정확히
images과labels로 지정하고 나란히 배치해야 합니다. - 레이블 파일이 비어 있거나 없는 이미지는 배경 이미지입니다. 유효하며 모델이 탐지하지 말아야 할 대상을 학습하는 데 도움이 되지만, 의도한 경우에만 사용하세요.
레이블 행 읽기#
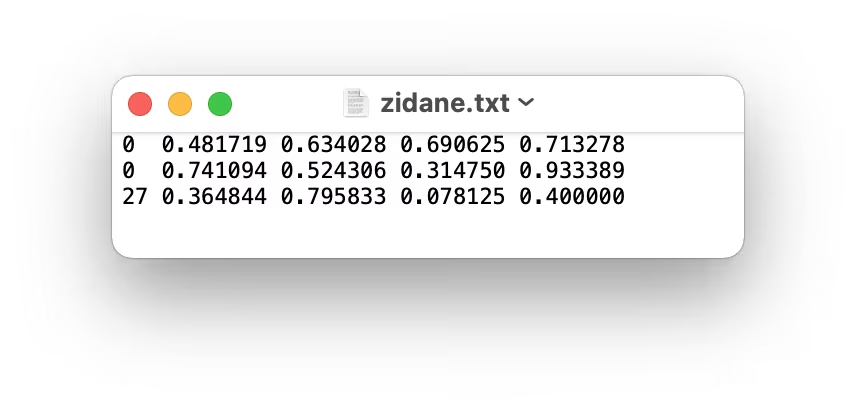
각 행은 객체 하나를 나타냅니다. 정수 클래스 인덱스 다음에는 이미지 너비와 높이에 대한 비율로 표시된 바운딩 박스의 중심과 크기가 옵니다. labels/train/Frame_0.txt의 실제 행은 다음과 같습니다:
0 0.330729 0.816204 0.103125 0.1212960: 클래스 인덱스는 0이며, YAML에서pill로 이름을 지정합니다.0.330729 0.816204: 바운딩 박스 중심은 가로 방향으로 33%, 세로 방향으로 82% 지점에 있습니다.0.103125 0.121296: 바운딩 박스는 이미지 너비의 약 10%, 높이의 약 12%를 차지합니다.
예제: 픽셀 좌표 상자 변환하기#
레이블 지정 도구는 픽셀 단위의 모서리 좌표(x1, y1, x2, y2)를 내보내는 경우가 많습니다. 이를 이미지 크기로 나누세요. 이전 단원에서 사용한 810×1080 크기의 bus.jpg 이미지에서 가장 왼쪽 사람의 바운딩 박스는 (49, 398)에서 (240, 902)까지입니다:
| 필드 | 공식 | 값 |
|---|---|---|
x_center | (x1 + x2) / 2 / 너비 | (49 + 240) / 2 / 810 = 0.178395 |
y_center | (y1 + y2) / 2 / 높이 | (398 + 902) / 2 / 1080 = 0.601852 |
width | (x2 − x1) / 너비 | 191 / 810 = 0.235802 |
height | (y2 − y1) / 높이 | 504 / 1080 = 0.466667 |
대부분의 레이블 지정 도구와 Roboflow 같은 도구는 YOLO 형식으로 바로 내보낼 수 있습니다. COCO JSON은 COCO JSON 학습 가이드를 따르세요. 그 밖의 형식은 JSON2YOLO 저장소에서 다룹니다. Pascal VOC XML의 경우 위 공식을 짧은 스크립트로 구현할 수 있습니다:
import xml.etree.ElementTree as ET
from pathlib import Path

CLASSES = ["person", "bus"]  # index = class id; must match names in data.yaml

def voc_to_yolo(xml_file: Path, out_dir: Path) -> None:
    root = ET.parse(xml_file).getroot()
    w, h = int(root.find("size/width").text), int(root.find("size/height").text)
    lines = []
    for obj in root.iter("object"):
        name = obj.find("name").text
        if name not in CLASSES:
            continue
        box = obj.find("bndbox")
        x1, y1, x2, y2 = (float(box.find(k).text) for k in ("xmin", "ymin", "xmax", "ymax"))
        xc, yc, bw, bh = (x1 + x2) / 2 / w, (y1 + y2) / 2 / h, (x2 - x1) / w, (y2 - y1) / h
        lines.append(f"{CLASSES.index(name)} {xc:.6f} {yc:.6f} {bw:.6f} {bh:.6f}")
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{xml_file.stem}.txt").write_text("\n".join(lines) + "\n")

voc_to_yolo(Path("bus.xml"), Path("labels"))
print(Path("labels/bus.txt").read_text())
이전 단원에서 사용한 사람 및 버스 바운딩 박스가 들어 있는 bus.xml에서 실행하면 예제 계산 결과와 버스 좌표가 출력됩니다:
0 0.178395 0.601852 0.235802 0.466667
1 0.495679 0.454167 0.991358 0.482407
학습 전 확인하기#
레이블 파일 몇 개를 해당 이미지에 그려 보세요. 잘못된 클래스, 뒤바뀐 x와 y, 그림자 주위의 바운딩 박스는 눈으로는 명확하지만 지표에는 드러나지 않습니다:
from ultralytics.data.utils import visualize_image_annotations

visualize_image_annotations(
    "my_dataset/images/train/Frame_0.jpg",
    "my_dataset/labels/train/Frame_0.txt",
    {0: "pill"},
)
그런 다음 Ultralytics로 모든 파일을 확인하세요. 데이터셋을 처음 읽을 때 레이블을 스캔하고, 행마다 각 이미지의 사용 가능 여부를 판단합니다:
스캔 로그에서 결과를 확인할 수 있습니다. 정상적인 데이터셋은 23 images, 0 backgrounds, 0 corrupt으로 표시됩니다. 그 외의 표시는 아래 오류 중 하나에 해당합니다.
이런 실수는 피하세요#
증상: ignoring corrupt image/label: non-normalized or out of bounds coordinates [634. 881. 198. 163.]이고 corrupt의 개수가 0이 아닙니다. 원인: 픽셀 값이 분수가 아닌 상태입니다. 해결 방법: 이미지 너비와 높이로 나누세요. 레이블 값이 1보다 크면 박스가 정규화되지 않은 것입니다.
증상: yolo val이 0 images, 23 backgrounds을 검사하고 No labels found 경고를 표시한 뒤, 여기서는 레이블 폴더 이름이 annotations였기 때문에 ValueError: train: No labels found과 함께 학습이 중단됩니다. 해결 방법: 파일 이름을 일치시키고 폴더 이름을 정확히 images와 labels으로 지정하세요.
증상: Label class 1 exceeds dataset class count 1. Possible class labels are 0-0. 원인: 내보내기 도구가 클래스 번호를 1부터 매겼습니다. 해결 방법: YOLO 클래스는 0부터 시작하므로 변환 스크립트에서 1을 빼거나 내보내기 설정을 수정하세요.
박스를 그렸을 때 박스 하나 높이만큼 아래쪽과 오른쪽으로 밀려 있다면 x_center y_center w h 대신 x1 y1 w h을 작성한 것입니다. 파일 하나를 그려 보면 몇 초 만에 알아낼 수 있지만, 어떤 검사도 이를 찾아내지 못합니다.
전체 데이터셋을 체계적으로 점검하려면 데이터셋 품질 관리를 참조하세요. coco8, coco128, african-wildlife 같은 기본 제공 데이터셋은 참고하기 좋은 구성입니다. 데이터셋 개요에서 전체 목록을 확인할 수 있습니다. 학습기는 레이블에 데이터 증강을 적용하므로, 여기서 간단히 데이터 정제를 해 두면 모든 에포크에 도움이 됩니다.
정답 보기
for s in train val; do
  echo "$s: $(ls my_dataset/images/$s | wc -l) images, $(ls my_dataset/labels/$s | wc -l) labels"
done
# train: 92 images, 92 labels
# val:   23 images, 23 labels
from pathlib import Path
for txt in Path("my_dataset/labels").rglob("*.txt"):
for line in txt.read_text().splitlines():
values = [float(v) for v in line.split()[1:]]
if any(v < 0 or v > 1 for v in values):
print(txt, line)스크립트에서 아무것도 출력되지 않으면 모든 좌표가 정규화된 것입니다. 분할별 파일 수가 같으면 모든 이미지에 레이블 파일이 있다는 뜻이며, 다음 단원의 스캔 로그에서 손상된 파일이 없는지 확인합니다.