주석 작성 모범 사례
라벨링 가이드를 작성하고 도구를 선택하세요. 정확도를 조용히 떨어뜨리는 10가지 실수를 피하고, 확장하기 전에 스크립트로 주석자 간 일치도를 측정하세요.
라벨 품질은 모델 품질의 상한을 결정합니다. 주석자 10명이 각자 "팔레트"를 조금씩 다르게 해석하면, 데이터셋은 열 가지 해석을 한꺼번에 학습하게 되며 아무리 학습해도 그 모순은 해결되지 않습니다. 문서화된 가이드, 측정된 보정 작업, 알려진 실수 목록을 마련하면 한 사람이 이미지 500개에 라벨을 지정하든 팀이 50,000개에 라벨을 지정하든 일관성을 유지할 수 있습니다.
실습형
주석 도구 선택#
적합한 도구는 작업, 팀, 학습이 이루어지는 위치에 따라 달라집니다.
| 도구 | 적합한 용도 | 참고 사항 |
|---|---|---|
| Ultralytics Platform | YOLO의 7가지 작업 모두 지원: 박스, 폴리곤, 시맨틱 마스크, 키포인트, 회전 박스, 이미지 클래스, 업로드한 깊이 맵을 편집할 수 있으며 SAM 스마트 주석도 지원합니다 | 라벨, 데이터셋 차트, 학습을 한곳에서 처리하며 내보내기 단계가 필요하지 않습니다 |
| CVAT | 대규모 팀, 비디오, 복잡한 검토 워크플로 | 자체 호스팅 또는 클라우드 |
| Label Studio | 멀티모달 프로젝트(이미지 + 텍스트 + 오디오) | 유연한 구성, 다소 가파른 학습 곡선 |
| Labelme | 소규모 팀의 폴리곤 라벨링 | 간단한 데스크톱 앱 |
| LabelImg | 빠른 박스 전용 프로토타입 제작 | 가볍지만 저장소는 보관 처리되었습니다 |
Ultralytics Platform에서는 SAM 2.1, SAM 3, SAM 3.1 스마트 주석을 detect, segment, semantic, OBB 데이터셋에 사용할 수 있습니다. 어떤 도구를 선택하든 작업에 필요한 YOLO 형식으로 내보낼 수 있는지 확인하세요. 라벨 형식과 변환에 대해서는 사용자 지정 데이터셋 준비를 참조하세요.
7가지 라벨 유형#

| 라벨 유형 | 그리는 대상 | 작업 |
|---|---|---|
| 클래스 라벨 | 이미지당 라벨 하나 | 분류 |
| 바운딩 박스 | 객체마다 축에 정렬된 사각형 | 탐지 |
| 폴리곤 | 각 객체 인스턴스의 외곽선 | 인스턴스 분할 |
| 밀집 마스크 | 모든 픽셀에 클래스 지정 | 인스턴스 분할 |
| 키포인트 | 관절과 같은 이름이 지정된 점 | 포즈 |
| 방향 지정 박스 | 객체마다 회전된 사각형 | OBB |
| 깊이 맵 | 없음: 깊이 센서의 픽셀별 거리 맵으로, 각 이미지와 짝을 이룹니다 | 깊이 추정 |
먼저 라벨링 가이드를 작성하세요#
누구든 박스를 그리기 전에 다음 다섯 가지 항목으로 가이드를 작성하세요.
- 클래스 정의: 클래스마다 긍정 사례, 클래스에 해당하지 않는 유사 객체, 엣지 케이스를 포함하는 단락 하나를 작성합니다.
- 그리기 규칙: 보이는 객체를 촘촘히 둘러싸는 박스를 그리고, 보이는 외곽선을 따라 폴리곤을 그립니다.
- 가림 및 크기 규칙: 부분적으로 보이는 객체에 대한 기준("클래스를 식별할 수 있으면 라벨 지정") 하나와 작은 객체에 대한 기준("높이가 10픽셀을 넘는 사람은 라벨 지정") 하나를 정해 모든 곳에 동일하게 적용합니다.
- 모호한 사례 기록: "이 사례는 어떻게 처리하나요?"라는 모든 질문과 합의된 답변, 스크린샷을 기록합니다.
- 제외할 항목: 이 작업에서 라벨링할 가치가 없는 모든 항목을 지정합니다.
스크린샷을 포함해 한두 페이지면 충분합니다. 그런 다음 라벨링 규모를 확대하기 전에 다음의 짧은 절차를 진행합니다.
모든 이미지에서 관련 객체에 빠짐없이 라벨을 지정하세요. 라벨이 없는 지게차는 모델에 지게차가 때로는 배경이라고 가르쳐 결국 지게차를 놓치게 합니다. 부분적으로 라벨링된 데이터셋은 학습 전에는 완전히 라벨링된 더 작은 데이터셋과 똑같아 보입니다. 다음 이미지로 넘어가기 전에 각 이미지의 라벨링을 완료하세요.
정확도를 떨어뜨리는 10가지 실수#
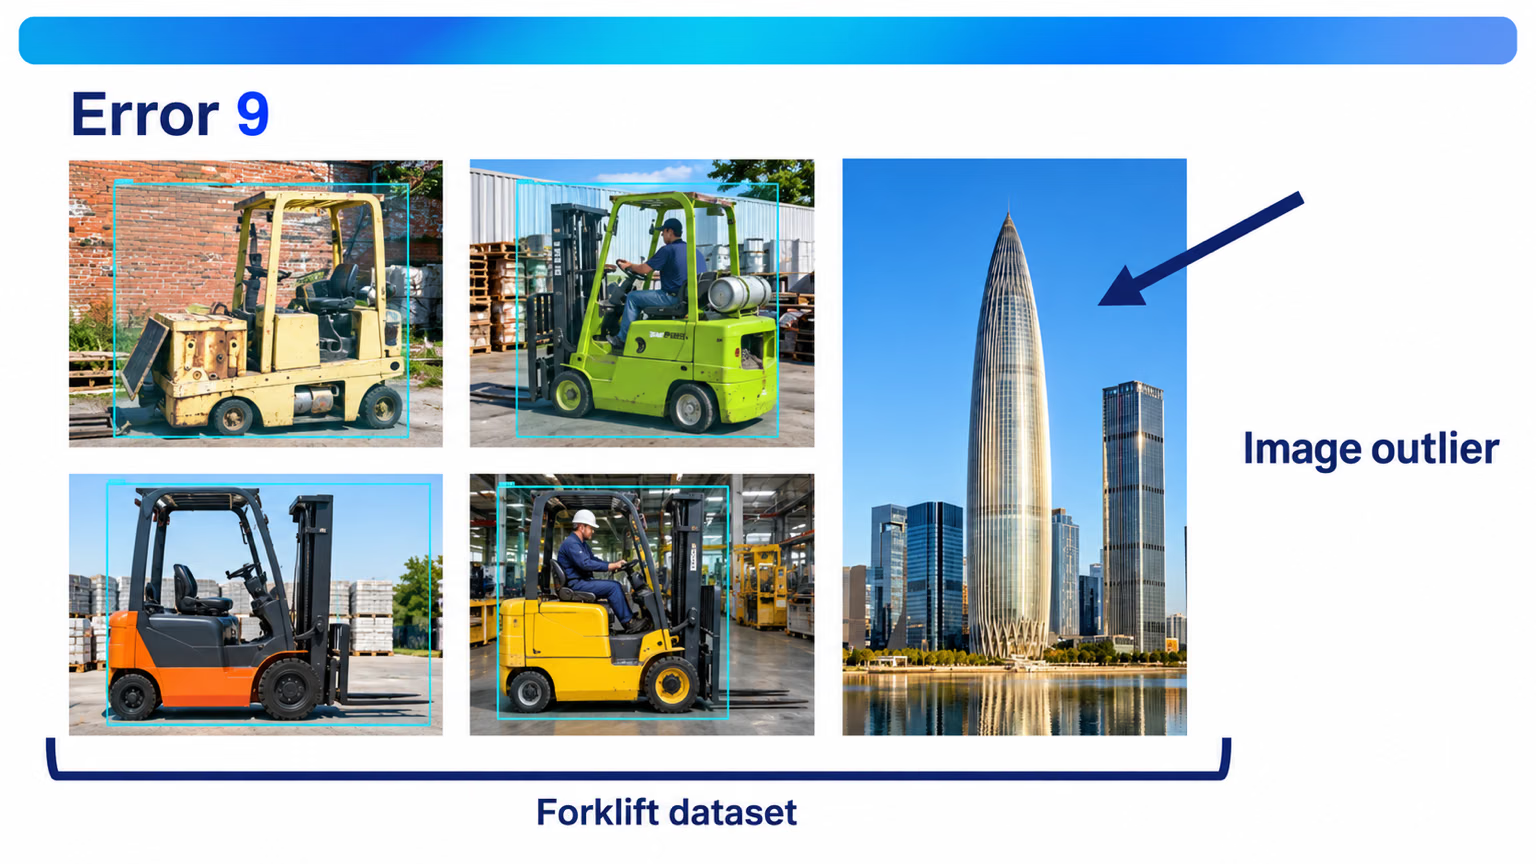
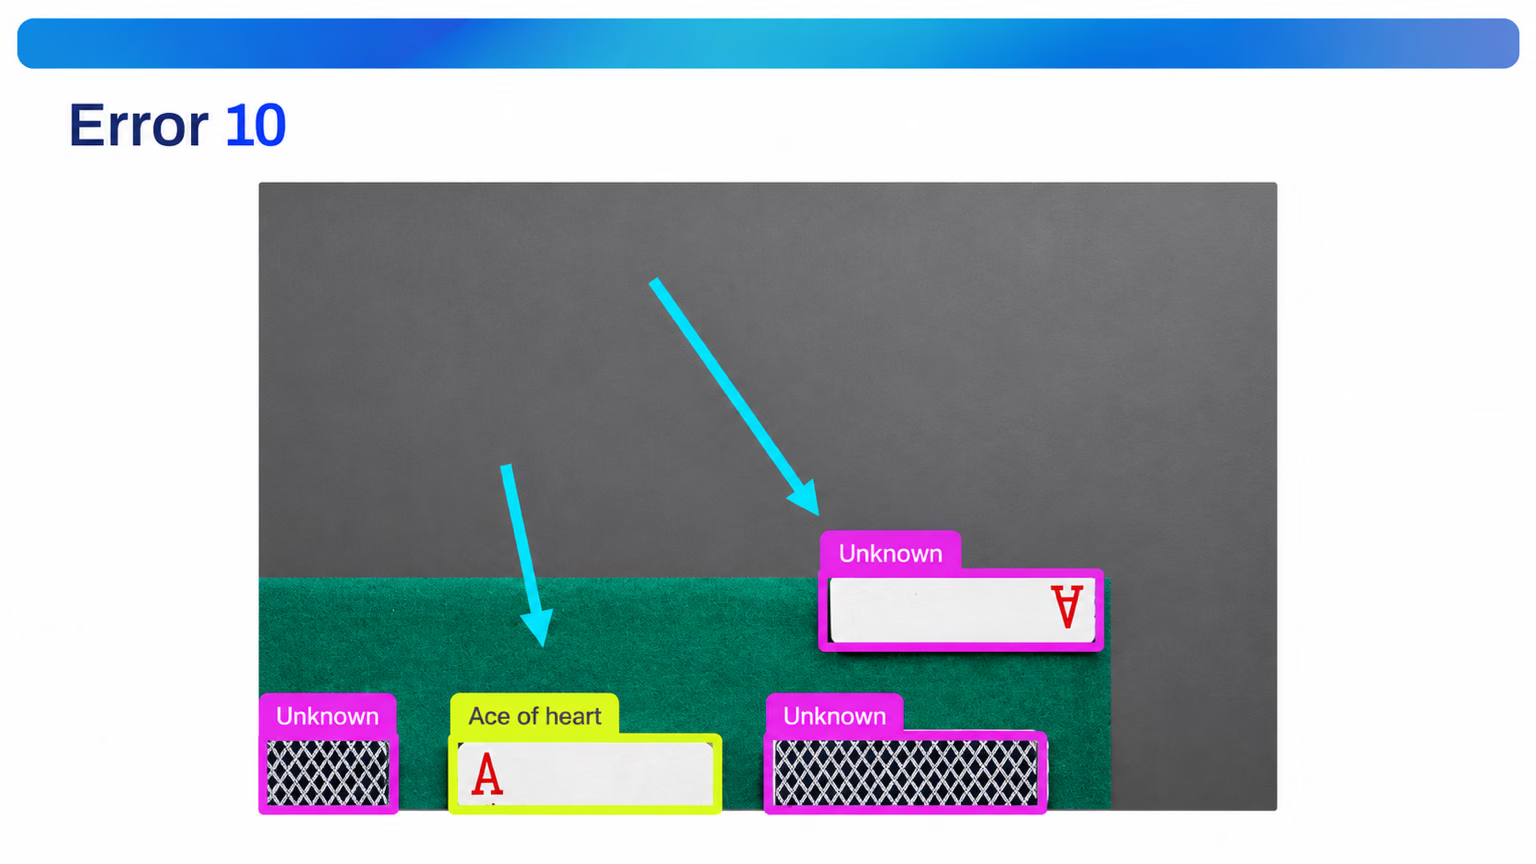
Ultralytics 주석 팀이 가장 자주 목격하는 오류를 지게차, 사람, 팔레트 이미지로 설명합니다(Alexis Schutzger의 자료를 각색함). 이 오류들을 가이드의 첫 항목으로 사용하세요.
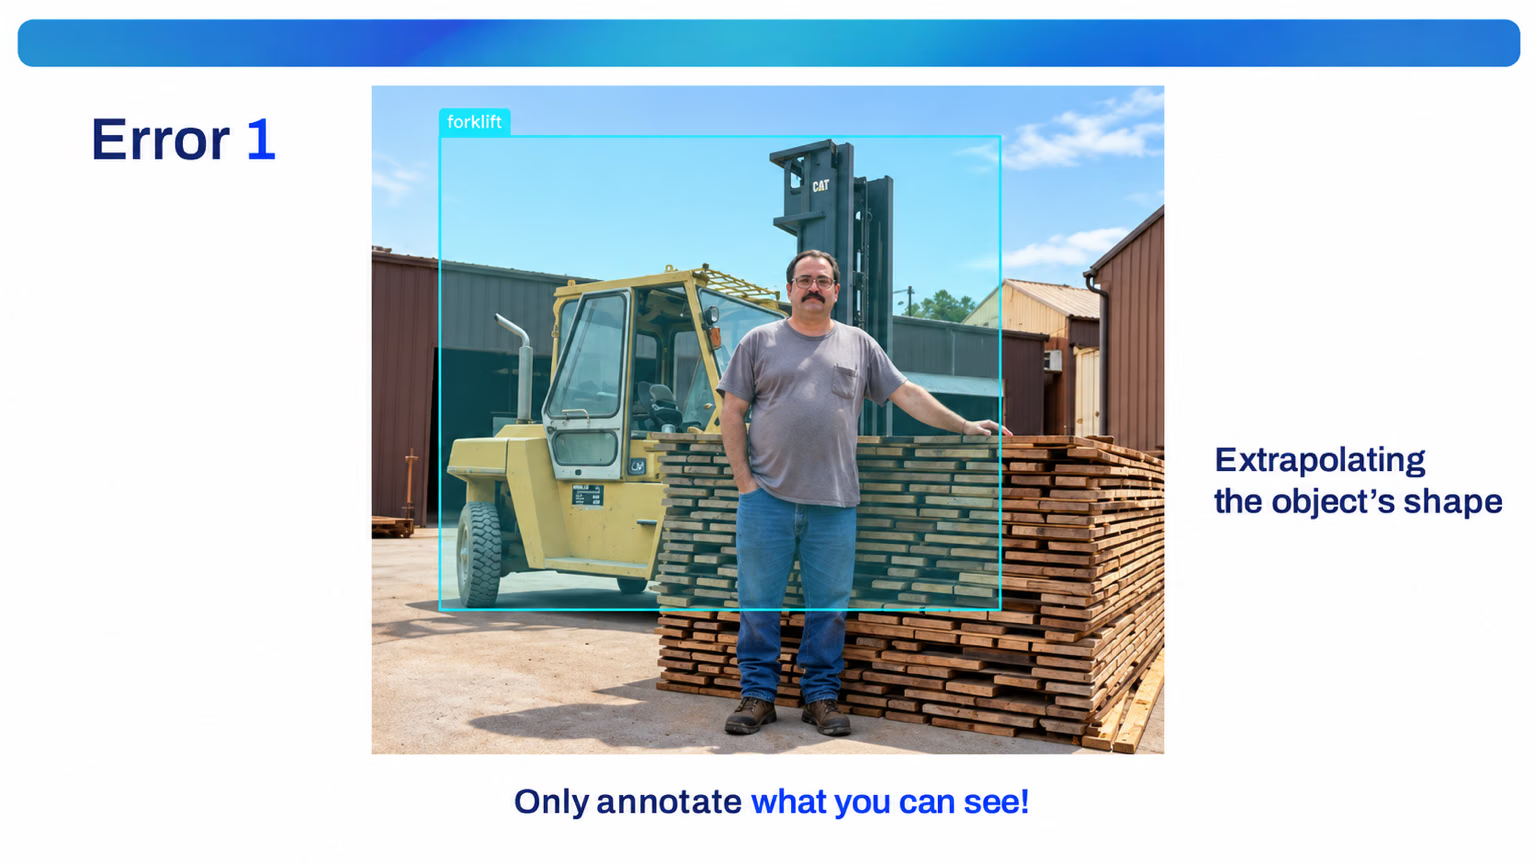
1. 객체의 형태를 추정해 그리기. 보이는 부분만 주석으로 표시하세요. 여기서는 지게차가 사람과 목재 더미 뒤에 있지만, 주석자는 트럭의 나머지 부분을 추정해 박스를 그리면서 박스가 둘을 가로지릅니다. 보이는 부분만 박스로 표시하세요.
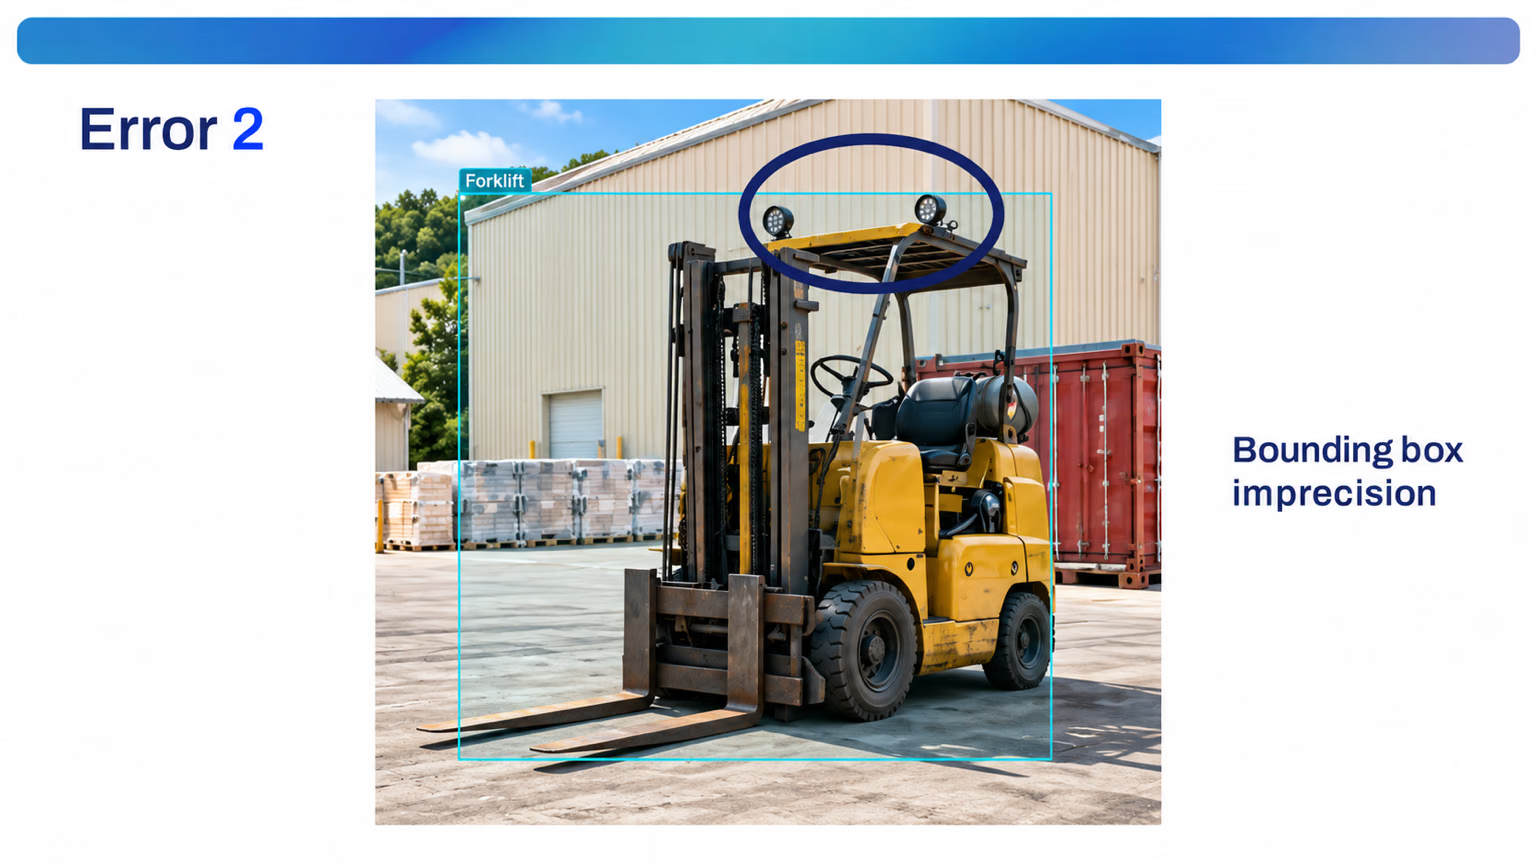
2. 부정확한 박스. 박스는 객체에 꼭 맞아야 합니다. 이 사례에서는 박스가 상부 보호 구조물의 조명을 가로지릅니다. 객체 일부를 잘라내거나 바닥 여백을 남기는 박스는 잘못된 범위를 학습시킵니다.
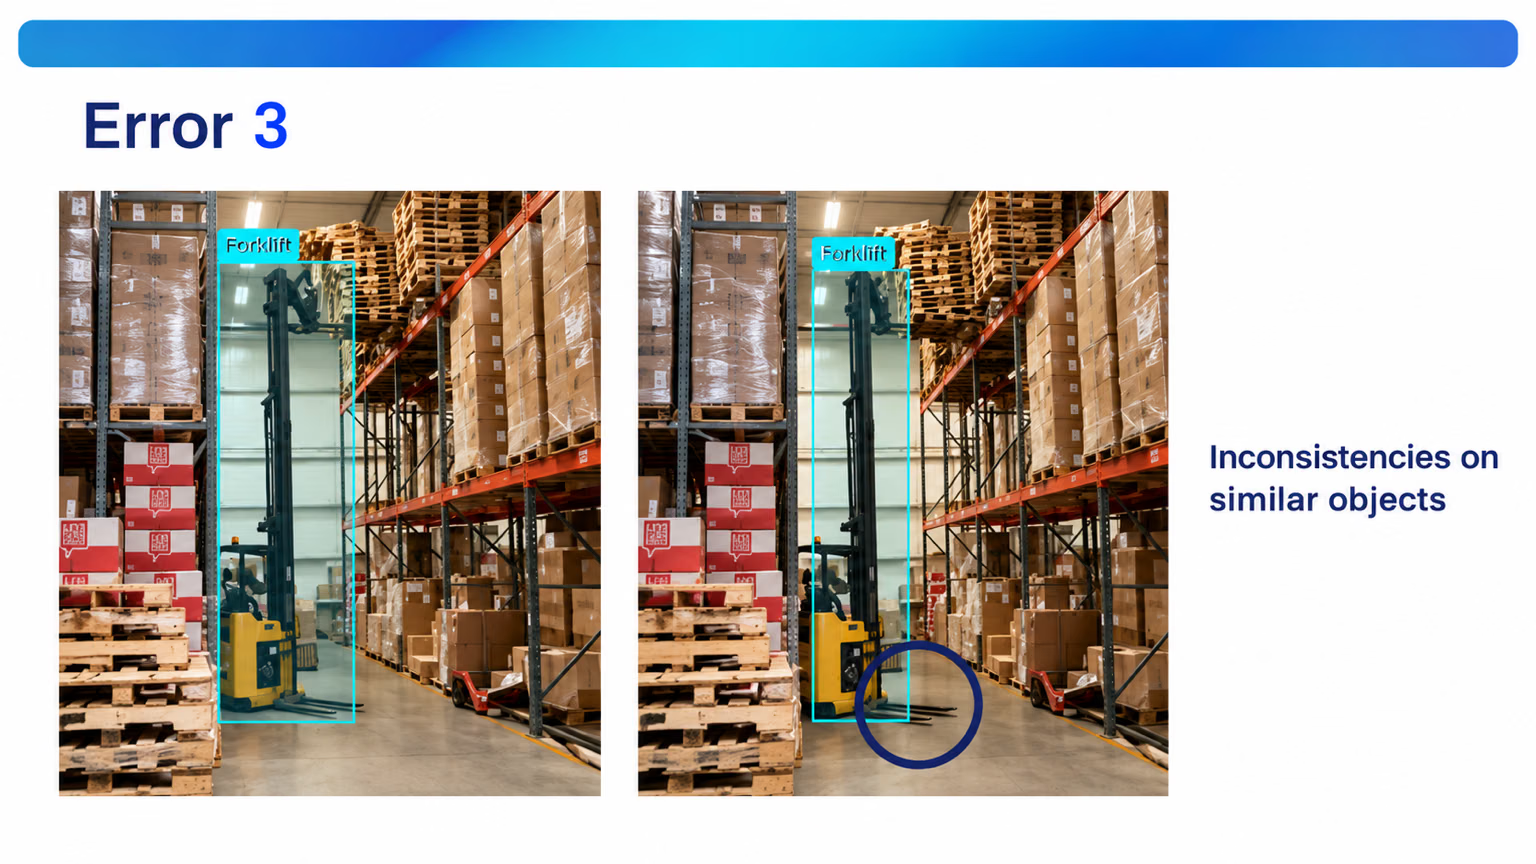
3. 유사한 객체에 일관성 없는 기준 적용. 왼쪽 박스에는 포크가 포함되어 있지만 오른쪽 박스에서는 빠져 있습니다. 모델은 같은 질문에 대해 서로 다른 두 가지 답을 학습하게 되므로, 포크를 포함할지 제외할지 기준을 문서화하세요.
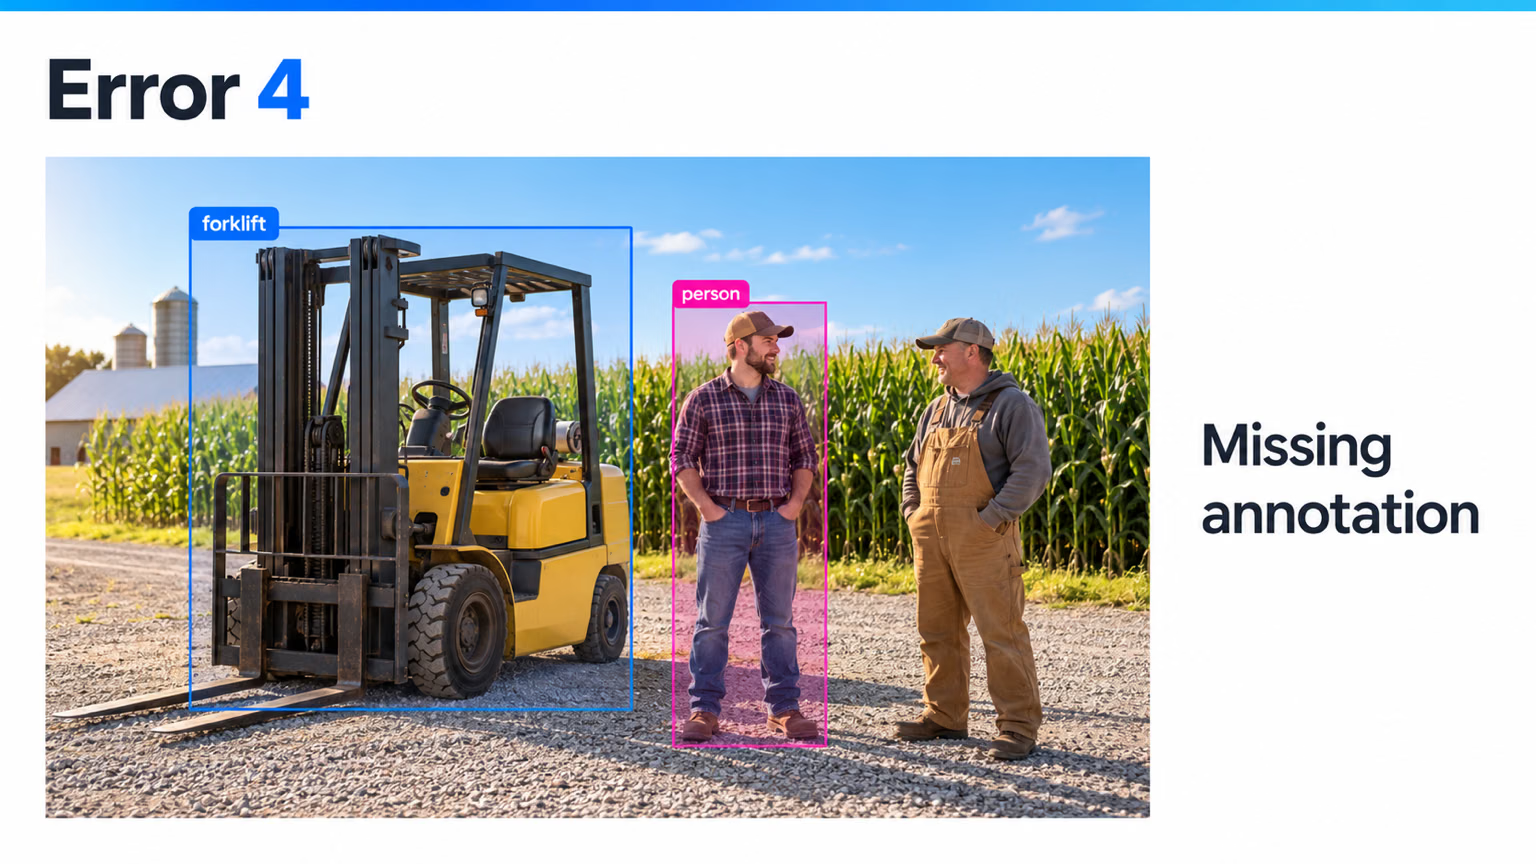
4. 주석 누락. 지게차 옆에 두 사람이 서 있지만 박스는 한 사람에게만 그려져 있습니다. 라벨이 없는 사람은 모델에게 "사람은 배경"이라는 교훈을 줍니다.
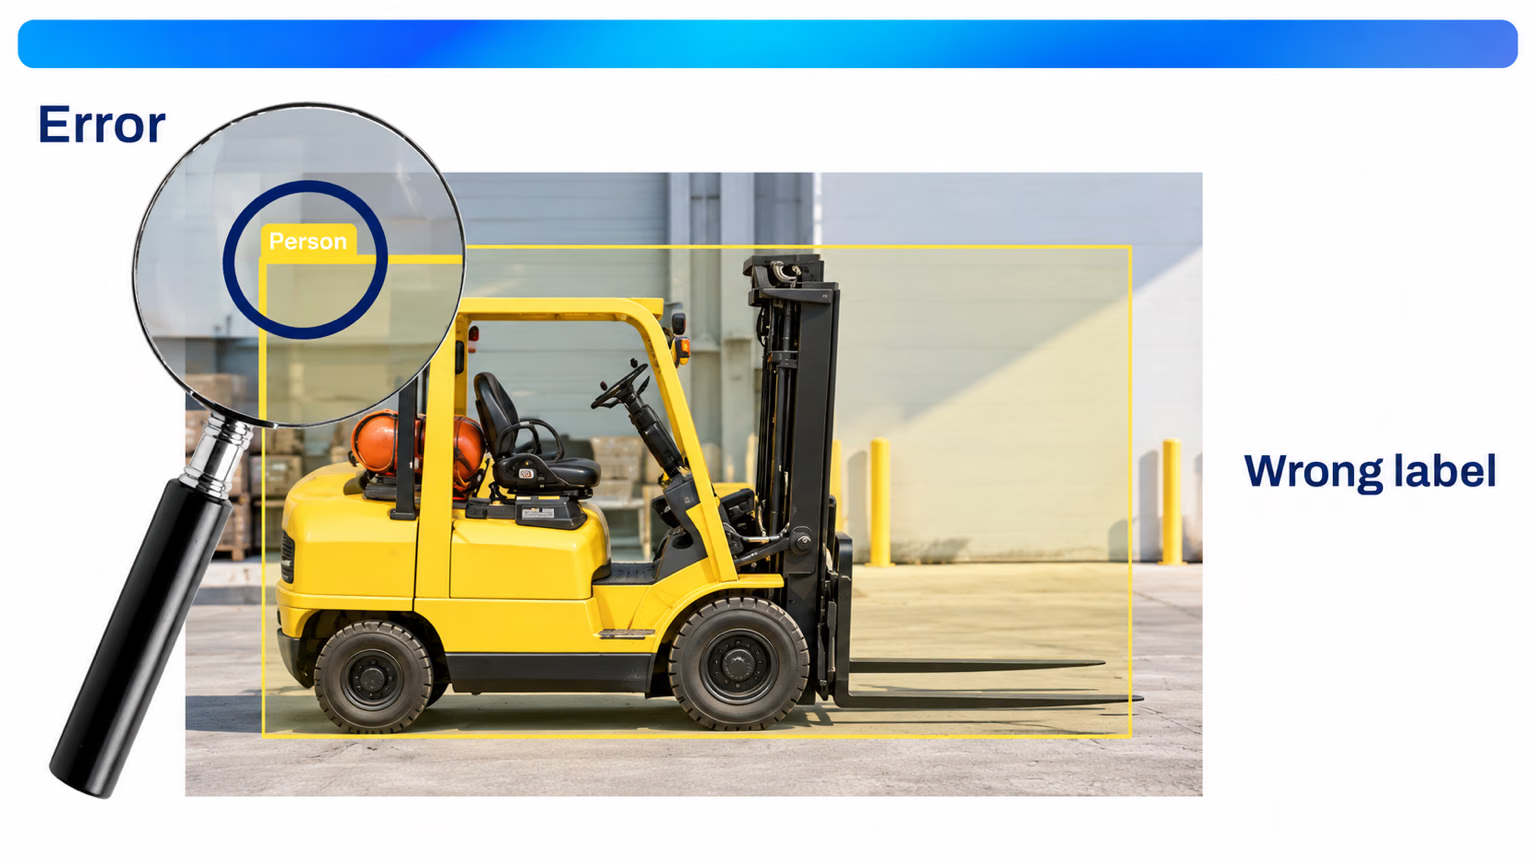
5. 잘못된 클래스. 박스뿐 아니라 클래스도 확인하세요. person으로 태그된 지게차 주위에 박스를 정확히 그려도 두 클래스가 모두 손상되며, 대개 키보드 단축키를 잘못 누른 경우입니다.
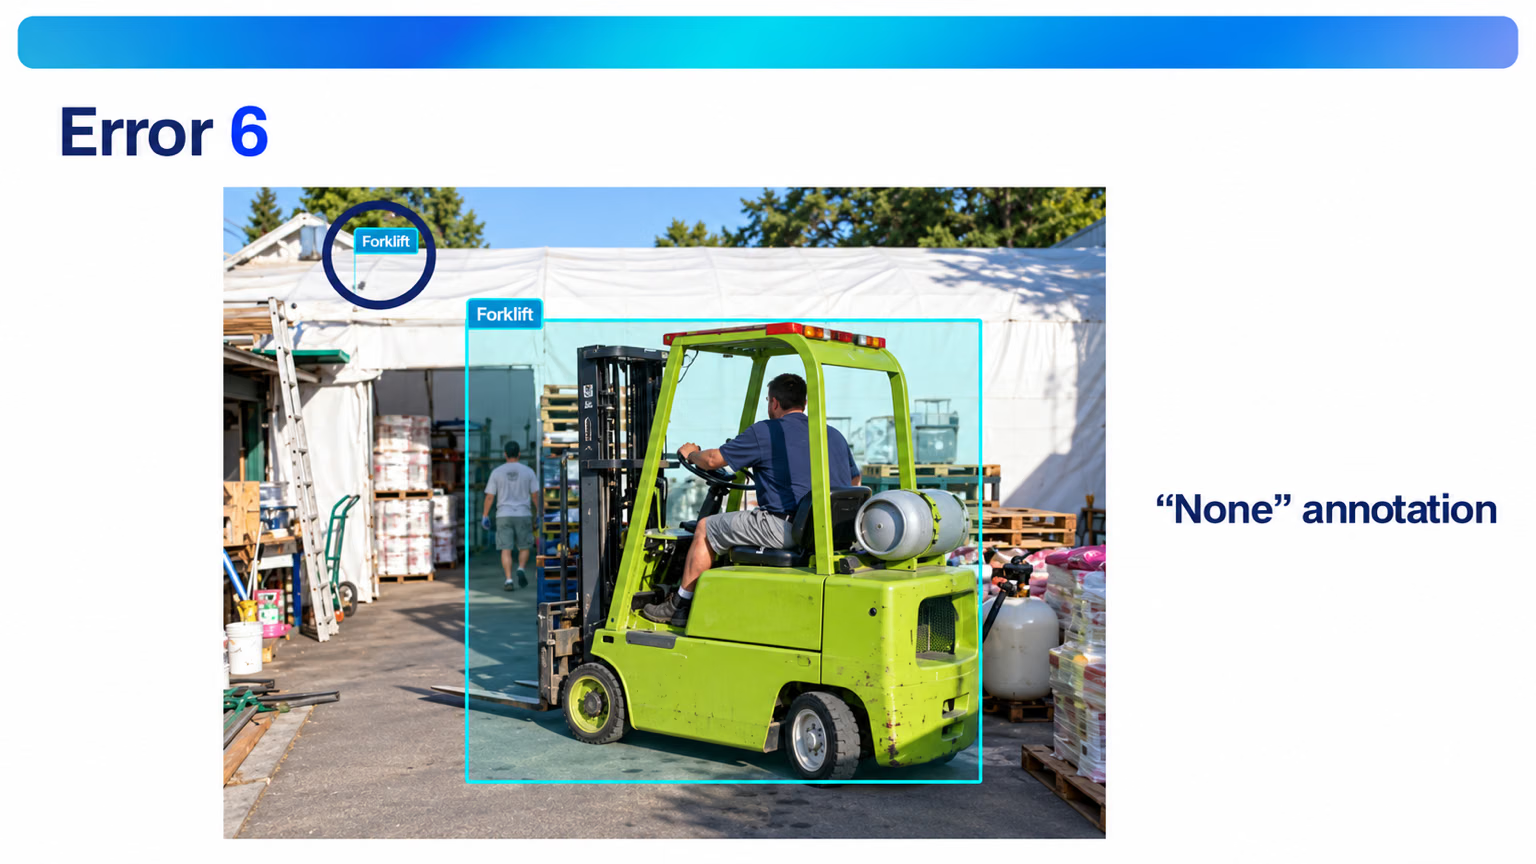
6. 비어 있거나 불필요한 주석. 모든 주석에는 실제 객체와 실제 클래스가 필요합니다. 클릭을 잘못하면 여기 모서리의 것처럼 거의 비어 있는 박스가 남고, 클래스 없이 저장한 박스는 None 또는 클래스 0으로 내보내질 수 있습니다. 수정하거나 삭제하세요.
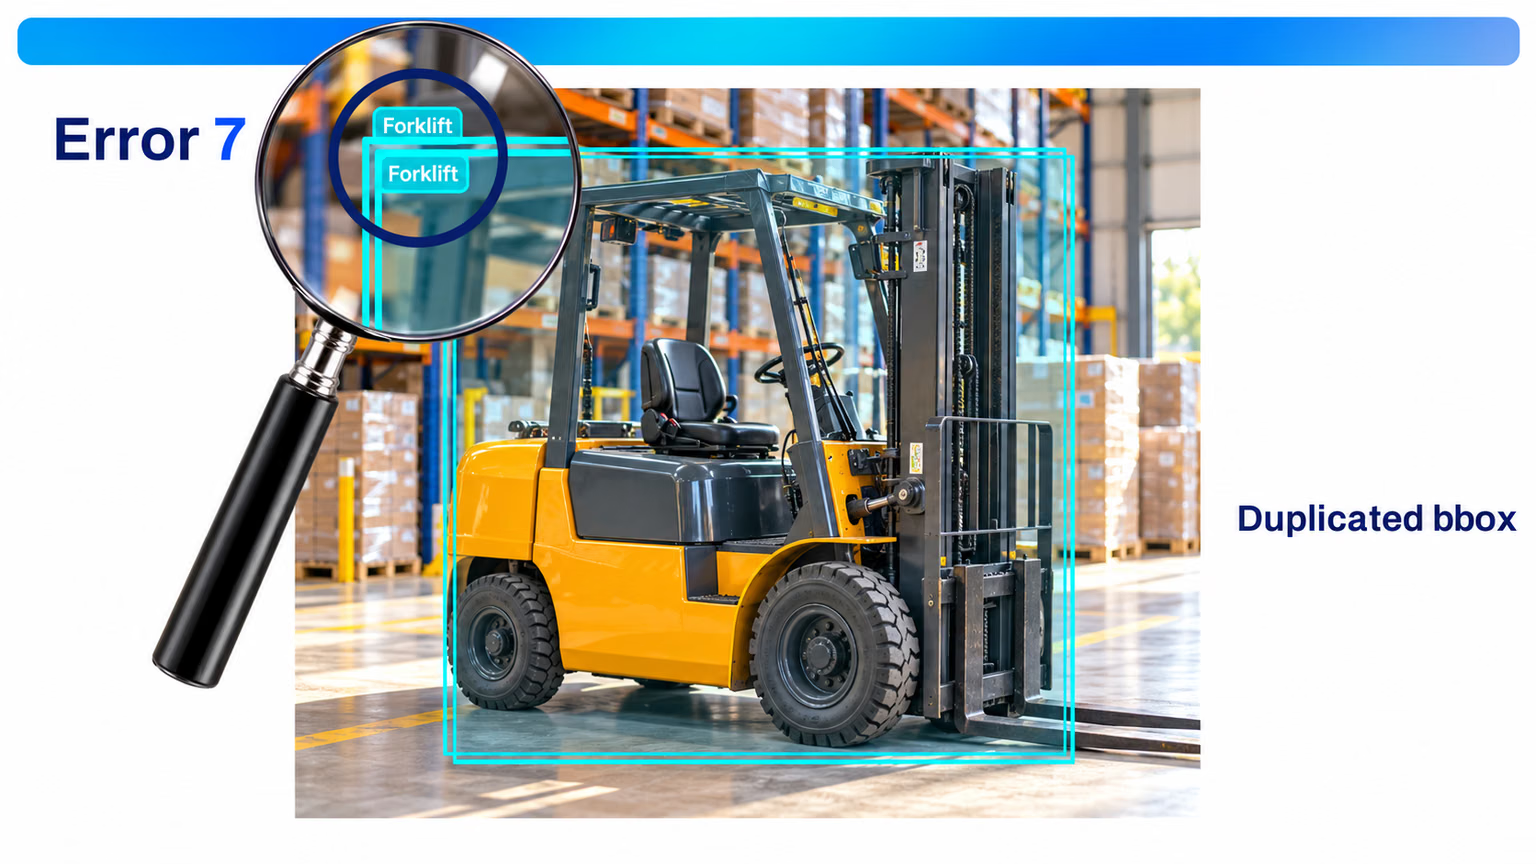
7. 중복 박스. 객체 하나에 박스 하나만 사용하세요. 같은 지게차에 겹치는 박스 두 개를 그리면 인스턴스 수가 부풀려지고 모델이 중복 예측을 하도록 학습됩니다.
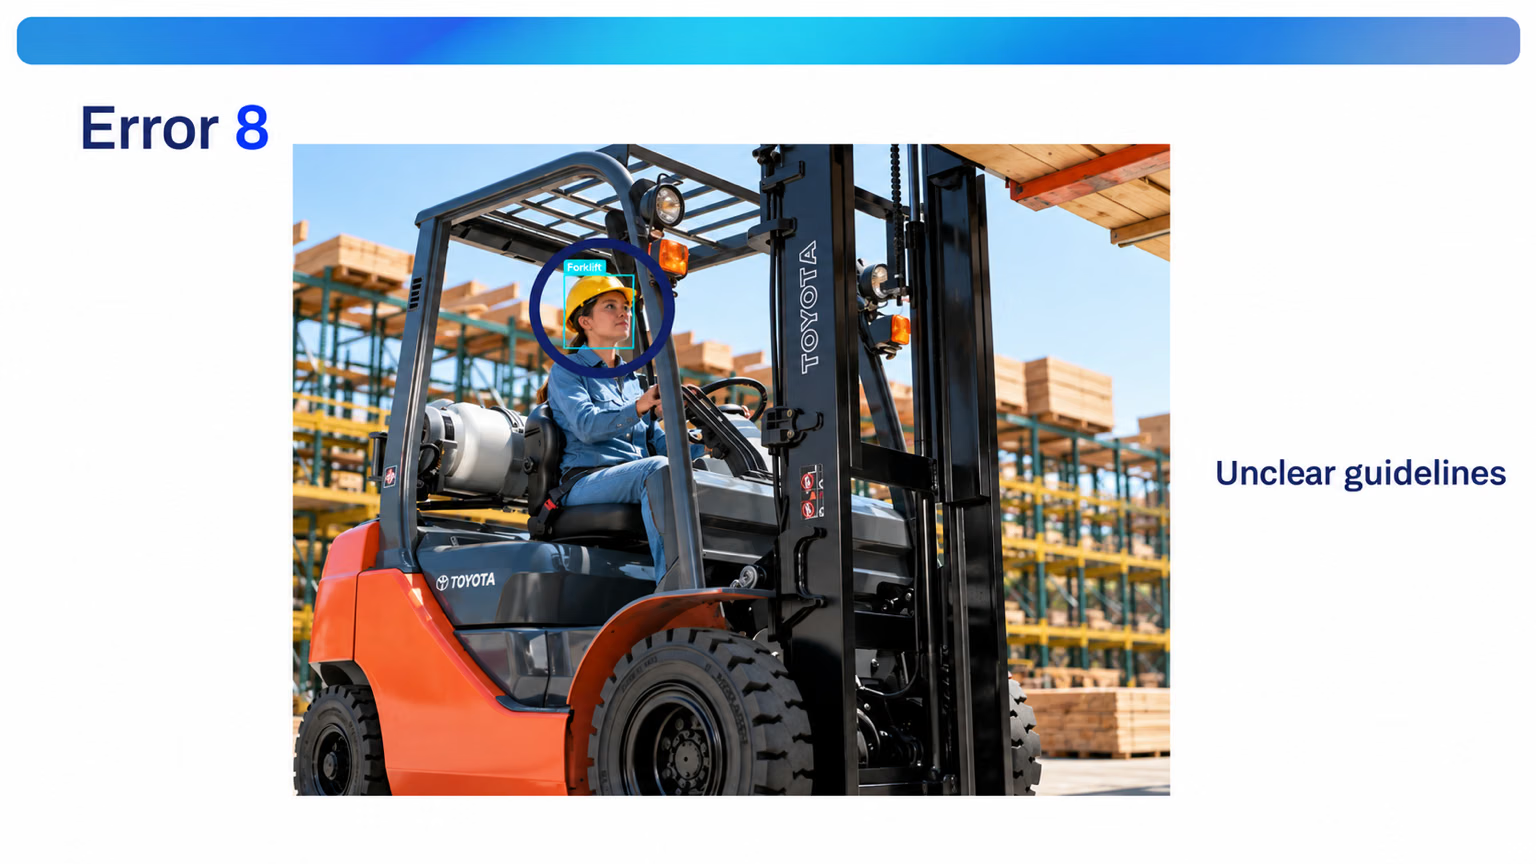
8. 불명확한 가이드라인. 문서로 작성된 규칙이 없으면 어노테이터마다 임의로 판단합니다. 여기서는 한 어노테이터가 운전자의 머리만 박스로 표시하고 forklift 클래스를 지정했습니다. 운전자는 지게차의 일부인가요, 아니면 별도의 person인가요? 가이드에서 한 번 명확히 답하세요.
9. 이상치 이미지. 배포 환경과 맞지 않는 이미지는 제외하세요. 지게차 데이터셋에 도시 스카이라인 사진을 넣어도 유용한 정보가 되지 않고 나머지 데이터의 효과만 희석됩니다.
10. 증강으로 인한 모호성. 크롭으로 클래스를 정의하는 특징이 사라지면 두 클래스가 구분되지 않게 됩니다. 하트 에이스의 모서리 기호를 잘라내면 unknown으로 표시된 카드처럼 보입니다. 해결 방법은 증강을 신중하게 사용하기를 참조하세요.
일치도를 추측하지 말고 측정하세요#
보정 작업에서는 두 어노테이터에게 같은 이미지를 제공하고 객체별로 레이블을 비교합니다. 클래스가 같고 IoU가 0.5 이상이면 두 레이블이 일치합니다. 이 스크립트는 COCO8의 val 이미지에서 점수를 계산합니다. 두 번째 사람 없이 실행할 수 있도록 사전 학습 모델이 어노테이터 B 역할을 합니다. 실제 팀에서는 B의 박스를 레이블 파일에서 읽어오세요.
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%결과 읽는 방법:
- 점수는 매칭된 객체 수를 두 어노테이터가 그린 전체 객체 수로 나눈 값입니다. 17개 중 8개입니다.
- 불일치는 특정 부분에 집중됩니다. 불일치 9개가 이미지 두 장에 모두 몰려 있고, 대부분 프레임의 1%에도 훨씬 못 미치는 크기의 사람입니다. 이는 무작위 오류 9개가 아니라 규칙 하나가 빠진 것입니다. 멀리 있는 사람도 레이블링해야 할까요?
- 해결책은 가이드에 규칙을 추가하는 것입니다. 예를 들어 "640픽셀 기준으로 높이가 10픽셀 이상인 모든 사람에게 레이블을 지정한다"와 같이 작성할 수 있습니다. 두 어노테이터가 해당 이미지 두 장을 다시 레이블링한 뒤 점수를 다시 측정합니다.
판단 기준은 다음과 같습니다. 일치도가 90%에 도달했을 때만 레이블링 규모를 확대하세요. 그보다 낮으면 어노테이터를 추가할 때마다 불일치가 늘어납니다.
스마트 주석을 가속 도구로 활용하세요#
스마트 주석에서는 YOLO 모델 또는 SAM이 레이블을 제안하고, 사람이 이를 승인하거나 수정하므로 처리량을 몇 배 높일 수 있습니다. 여러 라운드에 걸쳐 초기 데이터를 구축하세요. 검토가 끝난 배치로 학습하고, 해당 모델로 다음 배치의 레이블을 제안한 뒤 검토하고 다시 학습합니다. 이것이 액티브 러닝 루프이며, 스마트 주석 및 배치 레이블링에서 Ultralytics Platform을 활용하는 방법을 안내합니다.
작은 사람을 놓치는 모델은 작은 사람에 대한 박스를 제안하지 않으며, "모두 수락"을 클릭하는 검토자는 그런 사람을 추가하지 않습니다. 이런 라벨로 학습한 다음 모델은 사람을 더 확신에 차서 놓칩니다. 모든 이미지를 검토하고 모델이 그린 내용을 수정하는 것뿐 아니라 모델이 놓친 객체도 추가하세요.
눈으로 직접 확인하세요#
모든 Ultralytics 학습 실행은 실행 폴더에 labels.jpg과 train_batch*.jpg을 기록합니다. 첫 번째 파일은 클래스 수와 박스의 위치 및 크기를 시각화하고, 나머지 파일은 레이블을 표시한 실제 학습 이미지를 보여 줍니다. 첫 번째 에폭이 끝나기 전에 파일을 열어 보세요. 사람의 눈은 지표로는 절대 찾을 수 없는 오류를 포착합니다. 그림자 주위에 그려진 박스, 뒤바뀐 클래스 ID, 닫히지 않은 다각형 등이 그 예입니다.
정답 보기
COCO8의 불일치는 다음과 같은 가이드 항목으로 정리됩니다.
| 불일치 | 가이드에 추가된 규칙 |
|---|---|
000000000049.jpg에 있는 원거리 사람을 A만 레이블링함 | 640픽셀 기준으로 높이가 10픽셀 이상인 모든 사람에게 레이블을 지정하고, 모든 이미지에서 그보다 작은 사람은 제외합니다. |
| 프레임 가장자리에 있는 화분을 A만 레이블링함 | 프레임 가장자리에 걸쳐 잘린 객체라도 절반 이상 보이면 레이블을 지정합니다. |
000000000061.jpg에서 다른 코끼리에 일부 가려진 코끼리 | 머리 또는 몸의 절반이 보이는 가려진 동물에 레이블을 지정하고, 보이는 부분만 박스로 표시합니다. |
사람과 모델이 아니라 두 사람을 비교하려면, 스크립트가 A의 행을 읽는 방식과 동일하게 두 번째 레이블 폴더에서 어노테이터 B의 행을 읽으세요(Path("labels_b", image.stem + ".txt")). 같은 두 줄을 사용해 해당 행으로 b_cls과 b_box를 만들고, 스크립트가 b.cls과 b.xyxyn를 읽는 곳에서 이를 사용하세요. 재레이블링 후 다시 실행합니다. 점수가 90%를 넘으면 해당 라운드가 완료된 것입니다.