비즈니스 목표부터 시작하기
이미지를 하나도 수집하기 전에 비즈니스 목표를 비전 작업, 정의된 클래스, 코드로 실행할 수 있는 승인 테스트로 전환합니다.
창고 팀이 한 달 동안 모든 것을 촬영한 뒤에야 안전 담당자가 움직이는 지게차 근처의 사람만 중요하게 여긴다는 사실을 알게 되어, 라벨의 절반을 다시 작업해야 하는 상황을 생각해 보세요. 첫 사진을 찍기 전에 합의한 한 페이지 분량의 목표만으로 이를 방지할 수 있습니다. 이 작업은 반나절이면 끝나며, 이후 과정에서 데이터를 무엇을 수집할지, 무엇을 라벨링할지, 모델이 언제 배포할 만큼 충분히 좋은지를 결정합니다.
실습형
한 페이지 분량의 목표#

이후의 모든 단계에 필요한 질문에 다섯 개 행으로 답합니다. 프로젝트 목표 정의 가이드에서 같은 내용을 더 자세히 다룹니다. 아래는 이 과정에서 계속 활용할 창고 사례입니다.
| 항목 | 답하는 질문 | 창고 사례 |
|---|---|---|
| 비즈니스 목표 | 비즈니스에 어떤 변화가 언제까지 필요한가요? | 6개월 이내에 도크 도어 근접 사고를 30% 줄입니다. |
| 비전 작업 | 모델은 무엇을 출력하나요? | 객체 검출: 지게차와 사람을 둘러싼 박스. |
| 클래스 | 정확히 무엇에 라벨을 지정하나요? | forklift, person, pallet; 그 외 모든 항목은 배경입니다. |
| 승인 테스트 | 어떤 수치가 「배포 가능」을 의미하나요? | 학습에 사용되지 않은 카메라에서 수집한 500개 프레임을 대상으로, 정밀도 ≥ 0.85일 때 person의 재현율 ≥ 0.95. |
| 범위 외 항목 | v1에서 어떤 사항을 보장하지 않나요? | 빛이 전혀 없는 도크, 랙 뒤에 완전히 가려진 사람, 수동 팔레트 잭. |
전체 팀이 볼 수 있는 곳에 이 페이지를 고정합니다. 나중에 이해관계자가 항목에 이의를 제기하면 데이터셋보다 먼저 페이지를 수정합니다.
질문에 답하는 가장 단순한 작업 선택하기#
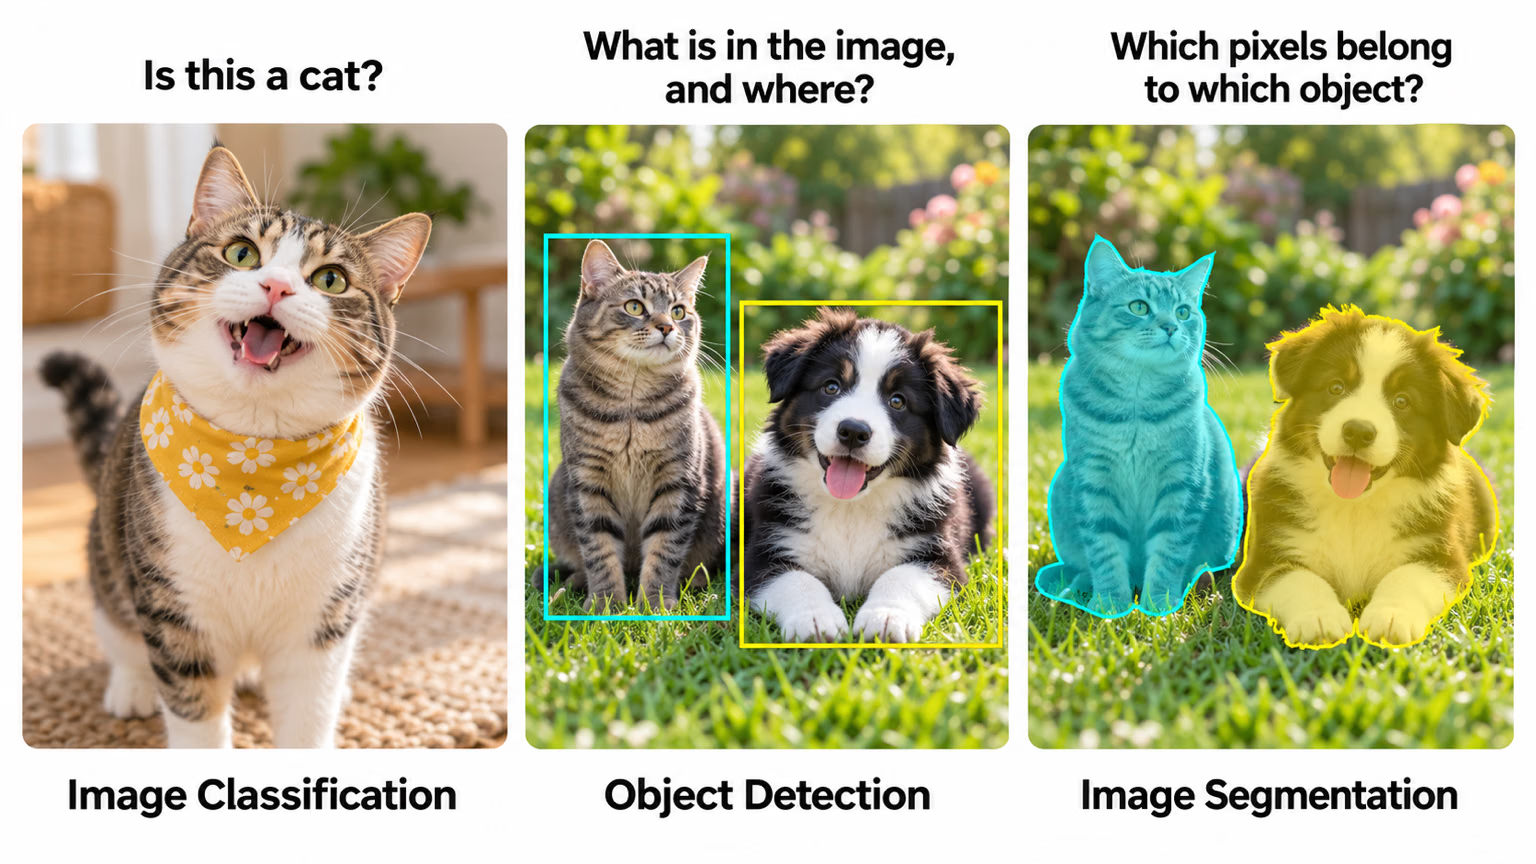
작업에 따라 어노테이터가 그리는 대상이 결정되고, 이에 따라 라벨링 예산의 대부분이 결정됩니다. 다음 결정 트리를 따라가며 비즈니스 질문에 답하는 첫 번째 작업에서 멈춥니다.
Ultralytics YOLO는 7가지 작업을 지원합니다. 데이터셋 계획에서 중요한 점은 각 작업의 라벨링 비용입니다. Computer Vision Foundations에서는 비전 작업 강의에서 작업별 차이를 자세히 비교합니다.
| 작업 | 어노테이터가 작성하는 결과 | 라벨링 작업량 | 선택 기준 |
|---|---|---|---|
| 분류 | 이미지당 라벨 하나 | 가장 낮음 | 이미지당 답 하나면 충분한 경우 |
| 탐지 | 객체당 클래스 + 축 정렬 박스 | 낮음 | 객체를 세거나 위치를 찾아야 하는 경우 |
| OBB | 객체당 클래스 + 회전 박스 | 중간 | 객체가 길고 가늘거나 위에서 내려다보는 시점인 경우 |
| 포즈 | 객체당 클래스 + 이름이 지정된 키포인트 | 높음 | 관절 또는 부위의 위치가 중요합니다 |
| 인스턴스 분할 | 객체마다 클래스와 폴리곤 지정 | 높음 | 객체의 윤곽이 중요합니다 |
| 인스턴스 분할 | 모든 픽셀에 클래스 지정 | 가장 높음 | 셀 수 있는 객체가 아니라 영역이 필요합니다 |
| 깊이 추정 | 아무것도 그리지 않습니다. 일반적으로 깊이 센서로 이미지마다 깊이 맵을 생성합니다. | 캡처 하드웨어에 따라 다릅니다 | 모든 픽셀의 거리가 필요합니다 |
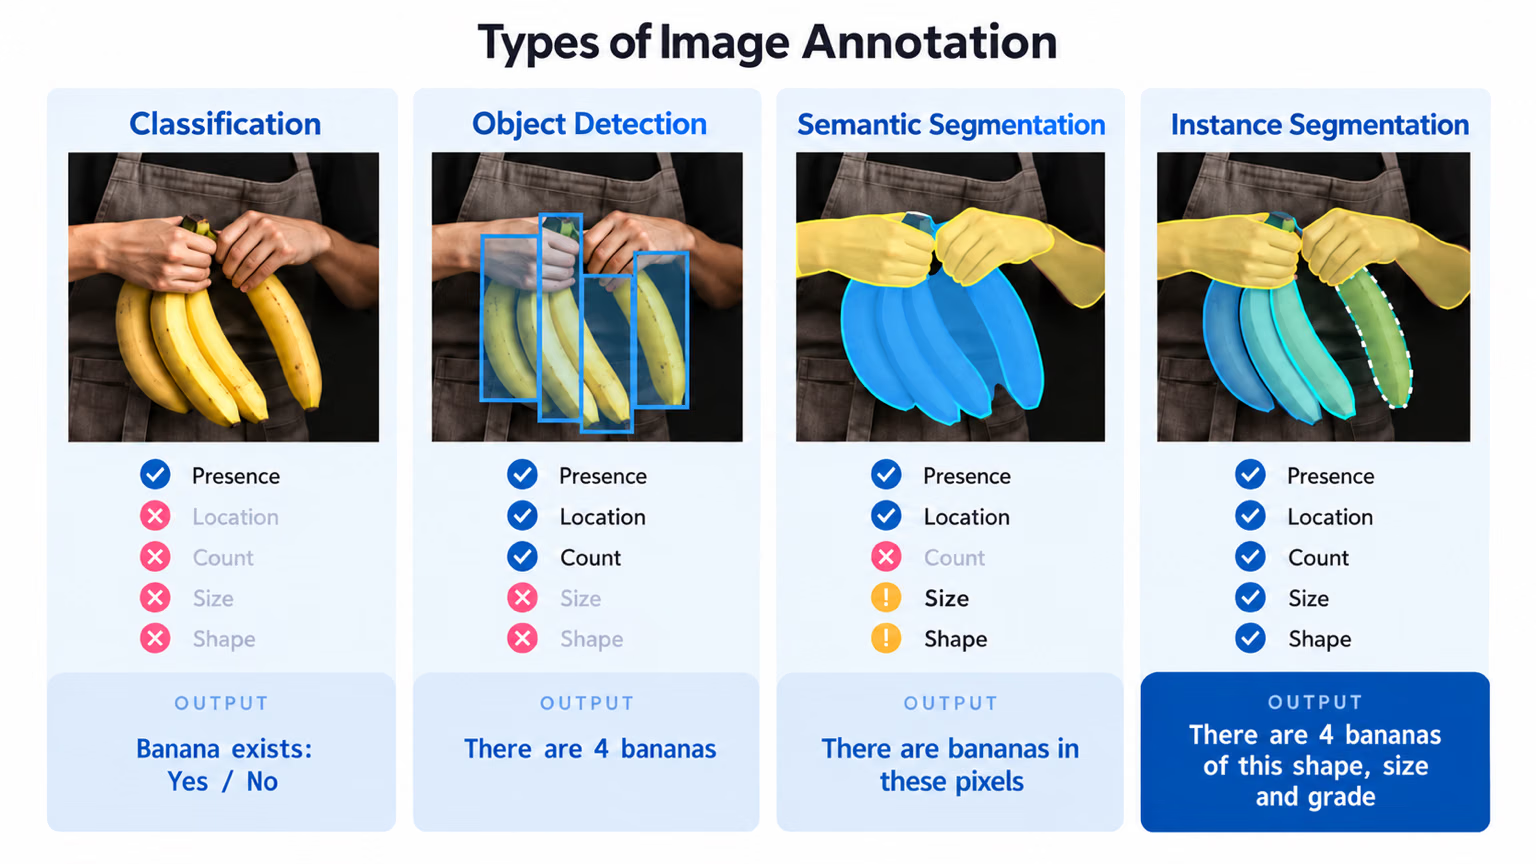
바나나 패널을 가격표처럼 살펴보세요. 탐지는 이미 존재 여부, 위치, 개수를 알려 주며, 크기와 형태를 추가하는 것은 두 세그멘테이션 패널뿐이고 라벨링 비용은 훨씬 더 높습니다. 비즈니스에서 필요한 것이 "바나나가 몇 개 있는가"뿐이라면 탐지를 선택하면 됩니다. 폴리곤은 예산 낭비입니다.
팀은 세그멘테이션이 더 정밀해 보인다는 이유로 선택하는 경우가 많지만, 데이터셋이 야간 근무, 비, 두 번째 현장을 충분히 포함하기도 전에 라벨링 예산을 소진합니다. 폴리곤은 객체당 박스보다 몇 배 더 많은 비용이 듭니다. 면적 측정이나 마스크 자르기처럼 목표의 한 항목에서 윤곽선 자체가 필요할 때만 세그멘테이션을 선택하세요.
어노테이터가 적용할 수 있는 클래스를 작성합니다#
두 어노테이터가 같은 객체에 같은 라벨을 붙일 때만 해당 클래스가 유용합니다. 각 클래스를 제외 대상인 유사 객체를 명시한 한 문장 정의로 작성하세요.
forklift: 포크와 마스트를 포함하는 동력식 지게차입니다. 수동 팔레트 잭은 제외합니다.person: 일부만 보이거나, 앉아 있거나, 차량 운전석 안에 있는 경우를 포함한 모든 사람입니다. 반사된 모습과 포스터는 제외합니다.pallet: 적재 여부와 관계없이 목재 또는 플라스틱 배송용 팔레트입니다. 팔레트 받침 없이 쌓인 상자는 제외합니다.
그런 다음 세분화 수준을 의도적으로 선택하세요. 거친 클래스("차량")는 비용이 적게 들고 더 빠르게 수렴합니다. 세분화된 클래스("세단", "픽업트럭")는 후속 작업에 더 유용하지만 일관성을 유지하기가 더 어렵습니다. 비즈니스에 필요한 것부터 시작하세요. 세분화된 라벨은 나중에 코드 한 줄로 거친 라벨에 합칠 수 있지만, 거친 라벨은 다시 라벨링하지 않고는 세분화할 수 없습니다.
"위험해 보이는 모든 것"이나 "통로를 막고 있는 물건"은 클래스가 아닙니다. 어노테이터마다 판단이 달라지게 하며, 일관성 없는 판단으로 학습한 모델은 그 불일치를 학습합니다. 정의만으로 신규 어노테이터가 적용할 수 있을 때까지 모호한 클래스를 구체화하거나, 디텍션 후 적용하는 규칙으로 바꾸세요(예: "통로 폴리곤 안에 있는 모든 pallet").
지표를 실행 가능한 승인 테스트로 만드세요#
실수로 발생하는 비용에 맞는 지표를 선택하세요.
- 놓치는 비용이 큽니다(안전, 결함): 해당 클래스의 재현율을 기준으로 승인 여부를 판단합니다.
- 오탐의 비용이 큽니다(부품 자동 거부, 직원 알림): 정밀도를 기준으로 승인 여부를 판단합니다.
- 모든 클래스가 똑같이 중요합니다(계수, 재고): 클래스별 AP를 기준으로 승인 여부를 판단해 평균값에 가려지는 클래스가 없도록 합니다.
YOLO 성능 지표 가이드에서 각 지표를 설명합니다. 그런 다음 테스트를 코드로 작성해 "충분히 좋은가요?"라는 질문이 논쟁거리가 되지 않도록 하세요. 이 스크립트는 오늘은 사전 학습된 모델과 COCO8 데모 세트로 실행할 수 있으며, 나중에는 자체 체크포인트와 홀드아웃 데이터로 실행할 수 있습니다.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # later: your fine-tuned runs/detect/train/weights/best.pt
metrics = model.val(data="coco8.yaml", classes=[0], verbose=False)  # 0 = person; later: your holdout YAML

precision, recall = metrics.box.mp, metrics.box.mr
print(f"person: precision={precision:.2f} recall={recall:.2f}")
print("PASS" if recall >= 0.95 and precision >= 0.85 else "FAIL: below the acceptance test")
all 4 10 0.939 0.8 0.848 0.387
person: precision=0.94 recall=0.80
FAIL: below the acceptance test각 줄에서 확인할 수 있는 내용:
classes=[0]은person만 점수화하므로 다른 클래스가 결과를 높일 수 없습니다. 자체 안전 클래스 ID를 사용하세요.- 검증기 출력 행에는 이미지 4장과 라벨이 지정된 사람 10명이 표시됩니다.
mp과mr은 정밀도와 재현율이며, 두 지표의 균형이 가장 좋은 신뢰도 임계값(최대 F1)에서 측정됩니다. - 사전 학습된 COCO 모델은 사람 10명 중 8명을 찾아 재현율 0.80을 기록합니다. 정밀도는 높지만 안전 기준으로는 충분하지 않습니다. 이 FAIL은 테스트가 제 역할을 하고 있다는 뜻입니다. 이 과정에서 FAIL이 나오면 하이퍼파라미터가 아니라 데이터로 돌아갑니다.
학습에 사용된 것과 같은 카메라와 날짜에서 추출한 테스트는 준비도가 아니라 기억력을 측정합니다. 목표에 홀드아웃 조건을 명시하고("학습에 사용하지 않은 카메라", "최근 2주간의 영상"), Split the Dataset Correctly에 따라 구성하세요.
v1에서 지원하지 않을 항목을 명시하세요#
완벽한 모델은 없으므로 허용 가능한 누락을 미리 명시하세요. 약속하지 않을 조건(짙은 안개, 완전한 암흑), 혼동을 허용할 유사 객체, v2로 미룰 롱테일 클래스 등을 정합니다. 이 항목은 목표를 달성한 모델이 문서에 없는 100% 기준으로 평가되는 일을 막고, 데이터 수집팀이 당장은 어디에 노력을 들이지 않아도 되는지 알려 줍니다.
정답 보기
다른 프로젝트의 목표 예시입니다. 한 식료품 체인에서 빈 진열대 칸을 탐지하는 경우입니다.
| 항목 | 답변 |
|---|---|
| 비즈니스 목표 | 한 분기 안에 상위 200개 제품의 품절 시간을 25% 줄입니다. |
| 비전 작업 | 탐지입니다. 매장에는 각 빈 공간의 윤곽이 아니라 위치가 필요하므로 폴리곤보다 바운딩 박스가 적합합니다. |
| 클래스 | gap: 제품 하나가 들어갈 너비 이상의 빈 진열대 칸입니다. 쇼핑객이나 카트에 가려진 칸은 제외합니다. price_tag: 진열대 가장자리의 라벨입니다. 프로모션 스티커는 제외합니다. |
| 승인 테스트 | 학습에 사용하지 않은 매장 5곳의 이미지 400장에서 정밀도 ≥ 0.80일 때 gap의 재현율 ≥ 0.90입니다. |
| 범위 외 항목 | 눈부심이 있는 냉동고 문, 매대 끝 진열대, 농산물 코너입니다. |
빈 공간을 놓치면 판매 기회를 잃지만, 오탐은 직원이 잠깐 걸어가 확인하는 비용만 발생하므로 재현율을 우선합니다. acceptance_test.py은 세 곳만 변경하면 됩니다. data="holdout_stores.yaml"(학습에 사용하지 않은 매장 5곳), classes=[0](이제 0은 gap), 임계값 recall >= 0.90 and precision >= 0.80입니다.