데이터셋이 준비되었는지 확인하기
8가지 통과/실패 검사로 첫 학습 실행을 결정하고, 스크립트로 검증할 수 있는 3가지를 자동화하며, 각 실패에 필요한 해결 방법을 파악합니다.
모든 프로젝트에서 팀이 학습을 시작하려는 순간이 찾아옵니다. 데이터셋이 준비되었을 때도 있지만, 분할 데이터 누수나 라벨이 부족한 클래스가 남아 GPU 시간을 일주일이나 낭비하고 신뢰할 수 없는 결과를 만들기도 합니다. 각 항목을 '예', '아니요' 또는 '문서화된 예외'로 평가하는 8가지 검사를 통해 주관적인 판단 대신 객관적으로 결정할 수 있습니다.
실습형
8가지 검사#
| # | 검사 항목 | 통과 기준 | 실패 시 돌아갈 항목 |
|---|---|---|---|
| 1 | 명확한 목표 | 목표, 작업, 클래스 및 승인 테스트가 문서화되고 합의되어 있습니다 | 비즈니스 목표부터 시작하기 |
| 2 | 정의된 클래스 | 각 클래스에 정의가 있고, 해당 클래스에 포함되지 않는 유사한 대상을 명시했습니다 | 목표 및 라벨링 가이드 |
| 3 | 대표성 있는 이미지 | 각 사양 시나리오가 할당량을 충족하며, 대부분 실제 운영 환경의 소스에서 가져왔습니다 | 고품질의 대표성 있는 데이터 수집하기 |
| 4 | 충분한 데이터 수량 | 클래스당 이미지 ≥ 1,500개 및 인스턴스 ≥ 10,000개, 또는 문서화된 예외 | 사양 및 수집 |
| 5 | 일관된 라벨 | 가이드를 작성하고 조정 작업을 완료했으며, 일치율이 ≥ 90%입니다 | 어노테이션 모범 사례 |
| 6 | QC 완료 | 감사 스크립트에 문제가 없고, 의심 사례를 검토했으며, QC 메모를 작성했습니다 | 데이터셋 품질 관리 |
| 7 | 정상적인 분할 | 그룹 단위로 분할했고, 각 그룹은 하나의 분할에만 포함되며, 모든 분할에 모든 클래스가 있습니다 | 데이터셋을 올바르게 분할하기 |
| 8 | 배경 이미지 | 이미지의 0–10%가 라벨이 없는 빈 프레임입니다 | 사양 및 수집 |
이 체크리스트는 데이터 수집 및 어노테이션 가이드에서 하나씩 다루는 동일한 결정을 단일 진행/중단 판단으로 통합합니다.
개수로 확인할 수 있는 검사 자동화#
4, 7, 8번 검사는 산술 계산이므로 스크립트로 매번 동일하게 평가할 수 있습니다. 다음 스크립트는 이전 강의에서 group_split.py이 작성한 연습용 세트와 분할 목록을 읽습니다:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background images그룹 단위 분할로 데이터 누수는 해결했지만, 연습용 세트는 준비와 거리가 멉니다. 가장 약한 클래스(30, skis)에는 라벨이 지정된 인스턴스가 하나뿐이고, val에서는 클래스의 절반을 평가할 수 없습니다. 이미지 128개로 구성된 데모 세트에서는 예상된 결과이며, 일주일 동안 학습하기 전에 이 검사를 통해 확인하려는 바로 그 결과입니다.
스크립트는 수치화할 수 있는 항목을 확인합니다. 점검 항목 1, 2, 3, 5, 6에는 사람이 필요합니다. 합의된 목표, 문서화된 정의, 사양 커버리지, 측정된 일치도 점수, QC 메모가 이에 해당합니다. 각 항목에 대한 근거를 한 줄씩 적어 수동으로 점수를 매기세요.
결정하기: 학습, 공백을 안고 배포 또는 수정#
검사에 실패하면 데이터를 수정하는 대신 다른 방법을 시도하고 싶은 경우가 많습니다:
| 유혹적인 지름길 | 효과가 없는 이유 |
|---|---|
| "더 큰 모델을 사용해 보세요." | 더 큰 모델도 라벨 노이즈를 똑같이 충실하게 학습합니다. |
| "학습률을 조정해 보세요." | 어떤 옵티마이저 설정도 누락된 클래스나 시나리오를 추가해 주지 않습니다. |
| "에포크를 더 늘려 학습하세요." | 데이터가 제한된 상태에서 에포크를 늘리면 더 빨리 과적합됩니다. |
| "증강을 더 추가하세요." | 증강은 데이터에 없던 시나리오를 만들어낼 수 없습니다. |
거의 준비가 된 세 가지 패턴#
| 패턴 | 실패한 검사 | 상태 | 해결 방법 |
|---|---|---|---|
| 다양성 없는 데이터 수량 | 3 | 이미지 5,000개, 카메라 한 대, 예외 상황 없음 | 학습 전에 더 많은 카메라, 장소 및 시간대에서 데이터를 수집합니다 |
| 일관성 없는 다양성 | 5 | 어노테이터마다 박스 범위와 가림 정도를 다르게 판단합니다 | 가이드를 완성하고 조정 작업을 진행한 뒤 영향을 받은 샘플의 라벨을 다시 지정합니다 |
| 감지하기 어려운 데이터 누수 | 7 | 비디오 프레임을 이미지별로 무작위 분할 | 클립, 카메라 또는 날짜별로 다시 분할합니다. 검증 mAP가 낮아질 것으로 예상해야 합니다. 그 하락이 현실을 반영하기 때문입니다. |
알려진 결함을 안고 배포합니다#
모든 검사 항목이 통과하기 전에 범위를 좁힌 첫 번째 모델을 만드는 것이 적절한 경우가 많습니다. 파일럿, 프로토타입 또는 일부 카메라를 대상으로 한 v1이 여기에 해당합니다. 모델을 프로덕션에 배포하면 어두운 곳에서 데이터셋을 다듬는 것보다 실제 문제를 더 빠르게 파악할 수 있습니다. 결함을 안고 배포할 때는 다음 세 가지를 기록합니다:
- 실패한 검사 항목.
- 예상되는 영향. 예: "야간 데이터가 없어 어두워진 후 재현율이 낮아질 것으로 예상됩니다".
- v1을 실행하는 동안 결함을 해결할 데이터 수집 계획.
"수량: 예외"라고 적으면 다음 담당자는 아무것도 알 수 없습니다. "수량: pallet, 인스턴스 700개. 혼잡한 구역에서 팔레트 재현율이 낮아질 것으로 예상되며, 6월까지 2,000개를 추가 라벨링할 예정"이라고 적으면 관리 가능한 위험이 됩니다. 모든 예외에는 승인 테스트에 예상되는 영향을 명시해야 합니다.
재학습 전에 매번 다시 실행합니다#
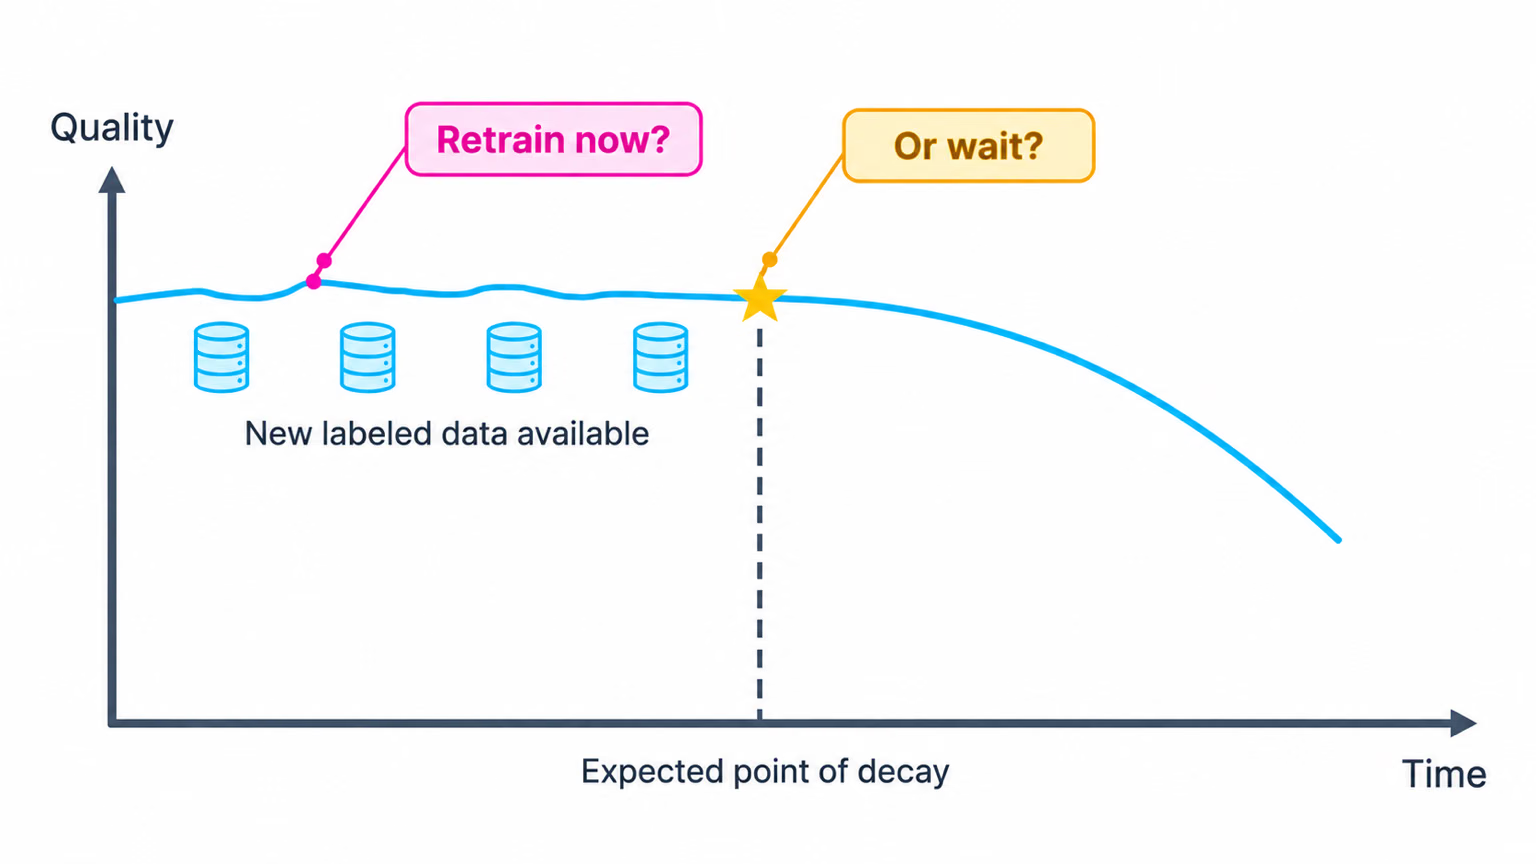
v1에 사용할 준비가 된 데이터셋이 자동으로 v3에도 준비된 것은 아닙니다. 새 클래스, 새 데이터 소스, 새 어노테이터는 각각 이전에 통과했던 검사를 실패하게 만들 수 있으며, 새 라벨이 쌓이는 동안 프로덕션 데이터는 드리프트합니다. 재학습 전에 매번 readiness.py을 다시 실행하고 수동 검사를 재평가합니다. 몇 분이면 충분하며, 이를 건너뛰면 결함이 있는 데이터셋으로 일주일 동안 학습하는 대가를 치를 수 있습니다.
정답 보기
연습용 데이터셋의 점수화 체크리스트:
| # | 검사 항목 | 점수 | 근거 |
|---|---|---|---|
| 1 | 명확한 목표 | 예 | 1과의 실습에서 사용한 objective.md 및 acceptance_test.py |
| 2 | 정의된 클래스 | 아니요 | COCO의 80개 클래스 이름에는 문서화된 정의나 제외해야 할 유사 클래스가 없습니다. |
| 3 | 대표 이미지 | 아니요 | coverage.py: cam2–cam4가 할당량 미달입니다. |
| 4 | 충분한 데이터 규모 | 아니요 | readiness.py: 데이터가 가장 적은 클래스에 이미지가 1개 있습니다. |
| 5 | 일관된 라벨 | 아니요 | 보정 단계의 일치율은 47%입니다. |
| 6 | QC 완료 | 부분 완료 | 감사를 실행했으며 000000000438.jpg의 의심 항목은 아직 미해결 상태입니다. |
| 7 | 누수 없는 분할 | 아니요 | 공유 그룹은 없지만 검증 데이터에 71개 클래스 중 36개가 누락되었습니다. |
| 8 | 배경 이미지 | 예 | 1.6% |
결정: 먼저 수정합니다. 승인 테스트에 대한 위험도 순위: (1) 목표에 필요한 클래스만 남기도록 클래스 목록을 줄여 검사 2, 4, 7을 한 번에 축소합니다. (2) 해당 클래스의 그룹을 더 수집합니다. (3) 멀리 있는 사람에 대한 가이드 규칙을 완성하고 다시 라벨링합니다. 데모 데이터셋은 이 검사를 통과하지 못하며, 그래야 합니다.