데이터셋을 올바르게 분할하기
스크립트를 사용해 무작위 분할에서 데이터 누출이 얼마나 발생하는지 측정하고, 클립·카메라·날짜와 같은 그룹 전체를 분할하며, 클래스 커버리지를 확인하고 테스트 세트를 고정합니다.
부주의한 분할은 신뢰할 수는 있지만 실제와 다른 지표를 만들어냅니다. 인접한 비디오 프레임이 학습 세트와 검증 세트에 나뉘어 들어가면, 검증 mAP는 일반화 성능이 아니라 기억력을 측정하게 되며, 그 차이는 프로덕션 환경에서야 드러납니다. 모델에 대해 보고하는 모든 수치는 이 분할에 좌우되므로, 한 번 신중하게 선택한 뒤 고정해야 합니다.
실습형
세 가지 분할, 세 가지 역할#
| 분할 | 일반적인 비율 | 용도 |
|---|---|---|
| 학습 | 70% | 모델이 이 데이터로 가중치를 학습합니다 |
| 검증 | 15% | 최적의 에포크를 선택하고, 실행 결과를 비교하며, 설정을 튜닝합니다 |
| 테스트 | 15% | 승인 테스트를 기준으로 최종 진행 여부를 한 번 결정합니다 |
Ultralytics 가이드에서는 학습 세트 70–80%, 검증 및 테스트 세트 각각 10–20%를 권장합니다. CV 프로젝트 단계에서는 각각 10–15%를 제안하고, 전처리 가이드에서는 70/20/10을 사용합니다. 이미지뿐 아니라 객체 기준으로도 비율을 계산해야 합니다. 밀집된 이미지 한 장에 라벨이 적은 이미지 열 장보다 더 많이 들어갈 수 있기 때문입니다. 정확한 비율은 각 분할의 용도보다 훨씬 덜 중요합니다.
상관관계가 있는 데이터에서는 무작위 분할로 데이터가 누출됩니다#
같은 클립의 124번 프레임과 125번 프레임은 거의 동일합니다. 하나는 학습 세트에, 다른 하나는 검증 세트에 들어가면 모델이 사실상 이미 본 이미지로 검증을 받게 됩니다. 파일 이름이 카메라-날짜 그룹 키로 시작하는 고품질의 대표성 있는 데이터 수집의 연습 세트에서 이를 측정합니다.
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in train검증 세트의 모든 카메라-날짜 그룹이 학습 세트에도 나타납니다. 실제 영상에서는 검증 프레임이 학습 프레임과 조명, 배경, 심지어 동일한 객체까지 공유한다는 뜻입니다. 따라서 검증 mAP는 매우 높게 나오지만 프로덕션 mAP는 그렇지 않습니다.
분할 단위 선택하기#
배포 환경에서 필요한 일반화 수준에 맞는 그룹을 선택합니다.
확신이 서지 않는다면 감당할 수 있는 범위에서 가장 일반적인 단위로 분할합니다. 가장 신뢰할 수 있는 수치를 얻을 수 있습니다. 이미지별 무작위 분할은 몇 주 간격으로 촬영한 제품 사진처럼 모든 이미지가 독립적으로 캡처된 경우에만 안전합니다.
코드에서 그룹 단위로 분할하기#
이 스크립트는 각 분할이 70/15/15 비율에 도달할 때까지 그룹 전체를 분할에 할당하고, 데이터 YAML에서 사용할 수 있는 파일 목록을 작성하며, 클래스 커버리지를 보고합니다.
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missing결과 읽는 방법:
- 구성상 어떤 그룹도 분할을 넘지 않습니다. 이로써 데이터 누출을 해결했습니다.
- 검증 세트에는 그룹이 2개뿐이고 클래스 36개가 누락되어 해당 클래스의 AP를 측정할 수 없습니다. 이미지 128장에 클래스가 71개라면 시드를 바꿔도 해결되지 않습니다. 실제 해결책은 그룹을 더 추가하는 것(카메라나 날짜를 늘리는 것)이며, 프로덕션 데이터셋에서는 클래스당 이미지 1,500장 이상을 확보합니다.
- 학습 세트에는 검증 세트나 테스트 세트에만 나타나는 클래스 5개가 없습니다. 이 분할로는 모델이 해당 클래스를 학습할 수 없습니다.
의사결정 원칙은 다음과 같습니다. 분할에서 클래스가 누락되면 해당 클래스가 포함된 그룹 전체를 추가하거나 이동하고, 데이터 누출을 다시 일으킬 수 있는 개별 프레임은 옮기지 않습니다. 데이터 YAML의 train, val, test 키가 세 개의 .txt 파일을 가리키도록 설정합니다. 나머지 파일 작성 방법은 데이터셋 YAML 작성하기에서 확인할 수 있습니다.
분할 간 클래스 균형 맞추기#
분류 작업에서는 scikit-learn의 train_test_split(..., stratify=labels) 인수 하나로 분할 간 클래스 비율을 동일하게 유지할 수 있습니다. 탐지 이미지에는 여러 클래스가 함께 포함되므로 그룹 수준에서 균형을 맞춥니다. group_split.py을 실행한 뒤 분할별 클래스 수를 비교하고, 모든 클래스의 비율이 예상치의 약 ±20% 이내에 들어올 때까지 그룹 전체를 서로 교환합니다.

Ultralytics Platform의 분할 재분배는 이미지를 무작위로 재할당하며, 자동은 권장되는 80/20 학습/검증 분할을 설정합니다(분할 문서). 이 기능은 완전히 동일한 중복 이미지를 제거하지만 그룹 정보는 알지 못하므로, 독립적으로 캡처된 이미지에 사용하고 비디오나 다중 카메라 데이터에는 그룹 단위로 분할한 데이터를 업로드합니다.
검증 세트 두 개를 따로 추적하기#
대개 검증 세트 두 개가 필요합니다. 하나는 안정적으로 선별된 회귀 테스트 모음이고, 다른 하나는 새로 수집한 프레임에 따라 바뀌는 프로덕션 환경을 반영하는 세트입니다. 데이터 YAML은 여러 검증 폴더 목록을 지원하지만, 이를 하나의 검증 세트로 병합해 점수 하나만 산출합니다.
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
각 점수를 확인하려면 검증 세트마다 데이터 YAML을 하나씩 사용합니다(train과 names은 같게, val는 다르게 설정). 그런 다음 학습된 가중치를 각 세트에 대해 검증합니다.
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
선별된 세트의 성능 저하는 회귀 문제이고, 프로덕션 세트의 성능 저하는 도메인 시프트입니다.
테스트 세트 고정하기#
분할과 관련된 가장 큰 실수는 테스트 세트에서 모델 변형 10개를 비교하는 것입니다. 테스트 결과가 어떤 결정에라도 영향을 미치면 최종 수치는 낙관적으로 편향됩니다. 모든 튜닝과 실행 비교는 검증 세트에서 하고, 테스트 세트의 승인 테스트는 마지막에 한 번만 실행하세요.
공개하는 모든 지표는 이 분할과 연결됩니다. 나중에 다시 셔플하면 모든 수치가 달라져 이전 실행과 새 실행을 비교할 수 없게 됩니다. 분할 단위, 시드, 파일 목록 세 개를 데이터셋과 함께 보관하세요.
소규모 데이터셋의 K-겹 교차 검증#
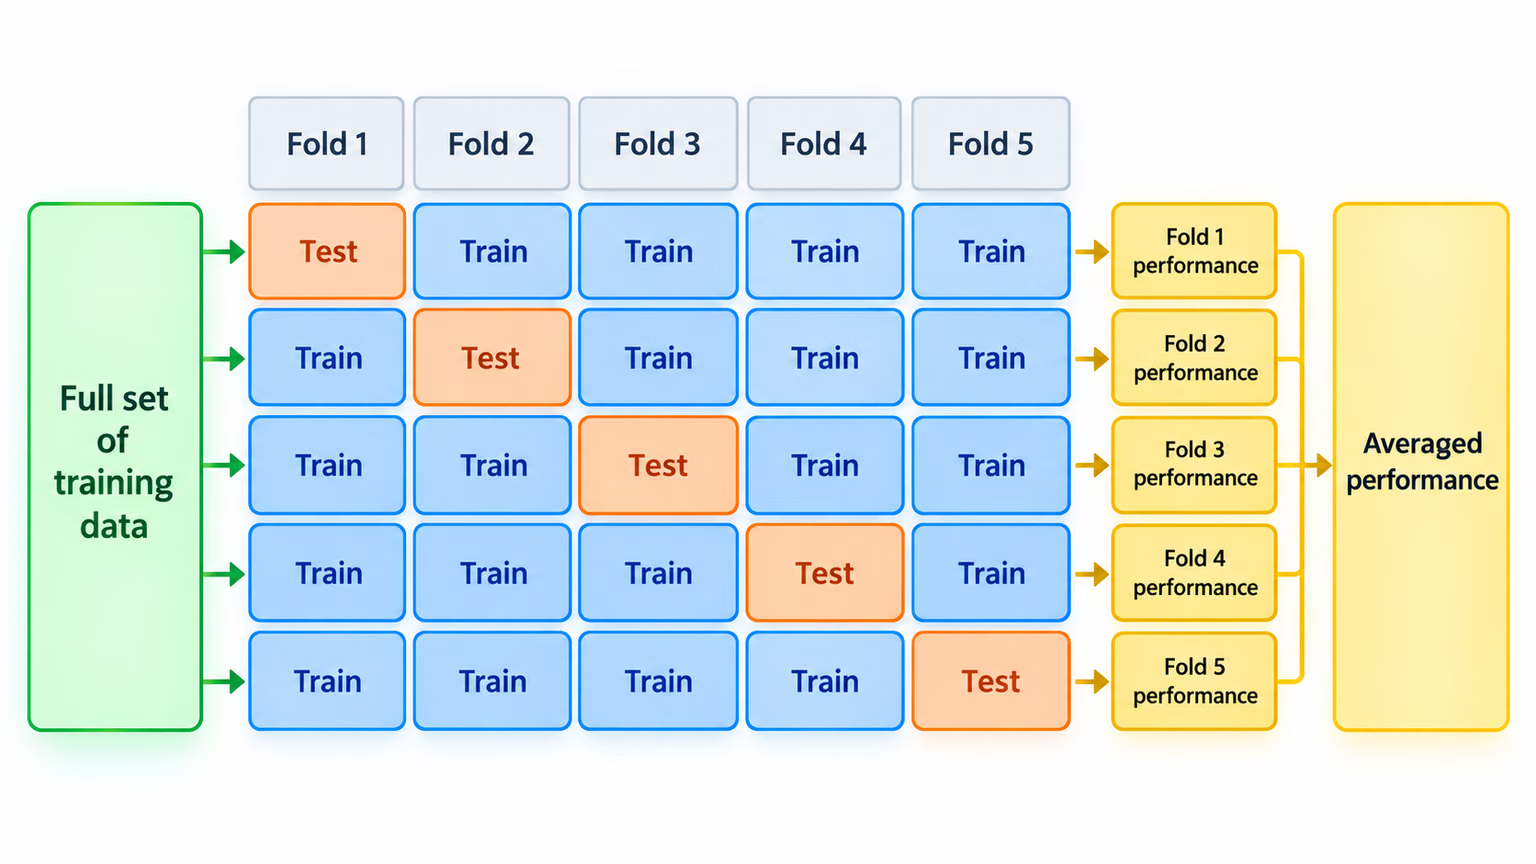
데이터셋이 작고(클래스당 약 500장 미만) 단일 분할의 통계적 신뢰성이 부족해 보인다면, K-겹 교차 검증은 순환하는 분할을 사용해 k개의 모델을 학습하고 결과를 평균 냅니다. 계산량은 k배가 되지만 추정치는 훨씬 안정적입니다. 같은 방식으로 그룹 단위로 폴드를 구성해야 합니다. 그렇지 않으면 모든 폴드에서 데이터가 누출됩니다.
정답 보기
새로운 날짜에도 계속 작동해야 하는 고정형 창고 카메라라면 카메라-날짜 단위로 분할합니다. cam2_2026-05-01. group_split.py 실행 후 어떤 그룹도 분할 경계를 넘지 않는지 확인합니다.
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: none연습용 분할은 데이터 누출 검사는 통과했지만 커버리지 검사는 통과하지 못했습니다. 검증 세트에서 클래스 71개 중 36개가 누락되었습니다. 해결책은 다시 섞는 것이 아니라 데이터 수집 계획을 세우는 것입니다. 검증 및 테스트 세트용으로 카메라-날짜 조합을 최소 두 개 더 확보하고, 각 조합에서 사양상 가장 중요한 클래스를 포함하도록 촬영한 다음 두 스크립트를 다시 실행합니다.