첫 번째 미세 조정과 반복 개선 루프
기본 설정으로 사전 학습된 YOLO26 가중치를 미세 조정하고, 누락 및 혼동 건수를 바탕으로 클래스별 AP 순위를 매긴 다음, 성능이 가장 낮은 클래스를 다음 데이터셋 수정 작업으로 전환합니다.
이 강의의 연습 실행 결과는 0.66 mAP50으로, 얼핏 보면 학습률 문제처럼 보입니다. 하지만 클래스별 테이블을 보면 그렇지 않다는 것을 알 수 있습니다. cup에는 검증 데이터에 라벨링된 객체가 14개 있지만 모델은 하나도 찾지 못합니다. 이는 데이터 문제이며, 하이퍼파라미터로는 해결할 수 없었습니다. 첫 번째 실행은 다음에 수정할 클래스를 알려주는 진단 과정으로 활용합니다.
실습형
사전 학습된 가중치에서 시작합니다#
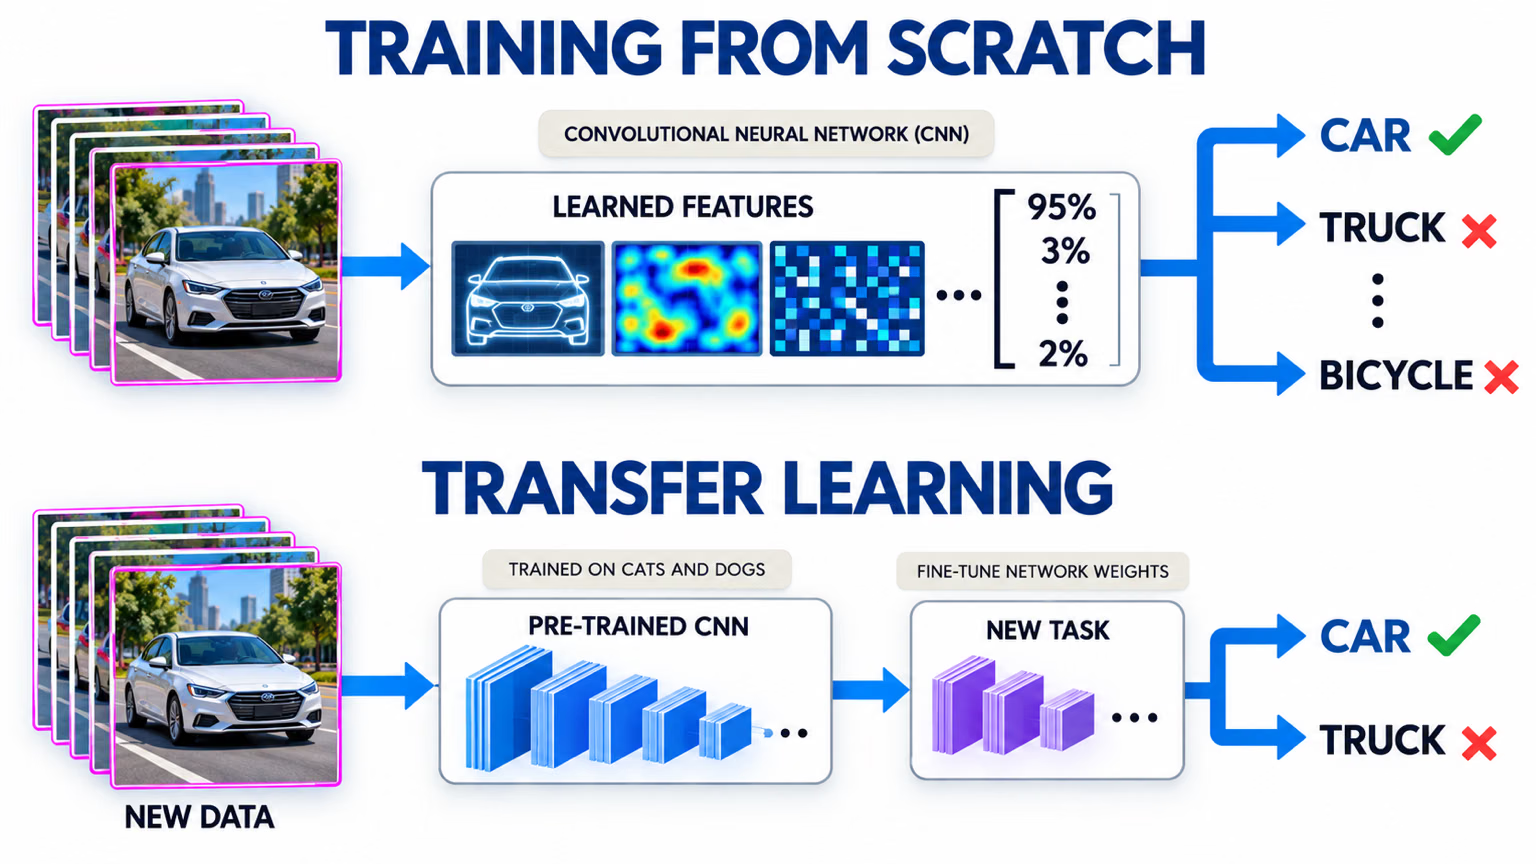
미세 조정은 가장자리, 텍스처, 형태를 이미 인식하는 가중치에서 시작하므로 수렴이 더 빠르고 무작위 가중치로 학습할 때보다 훨씬 적은 데이터가 필요합니다. 작업에 맞는 YOLO26 체크포인트를 선택합니다:
| 작업 | 사전 학습된 체크포인트 | 사전 학습 데이터 |
|---|---|---|
| 객체 탐지 | yolo26n.pt | COCO |
| 세그멘테이션 | yolo26n-seg.pt | COCO |
| 시맨틱 | yolo26n-sem.pt | Cityscapes |
| 포즈 | yolo26n-pose.pt | COCO 키포인트 |
| OBB | yolo26n-obb.pt | DOTAv1 |
| 분류 | yolo26n-cls.pt | ImageNet |
| 깊이 | yolo26n-depth.pt | 대규모 실내 및 실외 깊이 데이터 혼합 |
백본과 넥은 그대로 전이되며, 작업 헤드는 클래스 수에 맞게 부분적으로 재초기화됩니다. 처음부터 학습하는 방법은 매우 크고 특이한 도메인의 데이터셋에서만 이점을 얻습니다. 빠르게 기준선을 설정하려면 nano(n) 모델로 시작하고, 데이터 반복 개선의 효과가 사라진 뒤에만 더 큰 모델로 확장합니다. 미세 조정 가이드에서 내부 동작을 설명합니다.
기준선을 실행합니다#
기본 설정으로 학습합니다. 첫 실행의 목적은 기록을 세우는 것이 아니라 기준선을 마련하는 것입니다. 이 과정에서는 먼저 데이터 YAML을 작성한 뒤, 데이터셋을 올바르게 분할하기에서 분할한 연습용 데이터셋으로 학습합니다:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # 연습용 데이터셋은 COCO의 클래스 이름을 유지합니다.
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # COCO로 사전 학습되었으므로 작업에 맞는 체크포인트를 사용합니다.
model.train(data="practice.yaml", epochs=3, imgsz=320)  # 실제 실행 예시: epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486이제 실행 폴더(runs/detect/train/)에 weights/best.pt이 들어 있습니다. 첫 실행에서 고려할 만한 인수는 세 가지뿐입니다:
| 인수 | 기본값 | 변경할 시점 |
|---|---|---|
epochs | 100 | 작은 데이터셋은 더 적게, 매우 큰 데이터셋은 200–300으로 설정합니다. |
imgsz | 640 | 프레임 내 작은 객체가 많다면 1024 또는 1280으로 설정합니다. |
batch | 16 | 자동 배치를 사용하려면 -1으로 설정하고, 메모리 부족 오류가 발생하면 값을 낮춥니다. |
첫 번째 모델 학습하기에서 학습 호출과 실시간 로그를 자세히 설명합니다.
클래스 순위를 매기고 누락을 확인합니다#
전체 mAP만으로는 문제가 어디에 있는지 알 수 없습니다. AP50-95를 기준으로 클래스별 순위를 매기고 혼동 행렬을 사용해 각 클래스의 오류를 모델이 완전히 놓친 객체와 다른 클래스로 판단한 객체로 나눕니다:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another class각 오류 유형은 서로 다른 데이터셋 수정 작업을 가리킵니다:
- 검증 인스턴스가 너무 적음 (
fork,handbag,sink각각 1개): AP는 잡음에 불과합니다. 검증 데이터에 해당 클래스의 인스턴스가 최소 수십 개 쌓일 때까지 조치하지 말고, 먼저 검증 그룹을 더 수집합니다. - 누락 (
car4개 중 4개,cup14개 중 10개): 모델이 객체를 전혀 감지하지 못합니다. 학습 데이터에서 해당 시나리오의 커버리지를 확인하고suspect_labels.py로 누락된 라벨을 찾습니다. - 다른 클래스로 판단 (
cup14개 중 4개): 클래스 정의가 서로 겹칩니다. 해당 이미지를 열어 정의를 명확히 하고, 가이드에서 유사한 클래스를 명시합니다.
여기서 조치 가능한 결과는 cup입니다. 라벨링된 인스턴스가 14개인데 하나도 찾지 못했습니다.
실행 폴더에서 데이터 피드백을 확인합니다#

모든 학습 실행에서 다음 파일이 생성되며, 클라우드 학습 중에는 Ultralytics Platform에서 동일한 곡선을 실시간으로 표시합니다:
| 파일 | 데이터에 대해 알려주는 내용 |
|---|---|
confusion_matrix_normalized.png | 서로 혼동되는 클래스 또는 배경으로 놓친 클래스 |
BoxPR_curve.png | 클래스별 정밀도-재현율 곡선. 곡선이 낮으면 성능이 약한 클래스입니다. |
val_batch0_pred.jpg | 실제 검증 이미지에 대한 예측 결과. 반복적으로 발생하는 누락을 확인합니다. |
labels.jpg | 모델이 학습에 사용한 클래스별 개수와 박스 크기 |
results.png | 손실 및 지표 곡선. 학습 손실은 감소하는데 검증 손실이 증가하면 과적합을 의미합니다. |
검증 및 진단에서 각 그래프를 설명합니다. 여기서 핵심 질문은 항상 데이터에서 무엇이 빠져 있는지입니다.
데이터 우선 반복 개선 루프#
일반적인 반복 과정은 다음과 같습니다. 검증 인스턴스가 충분한 클래스 중 성능이 가장 낮은 클래스를 선택하고, 해당 클래스가 포함된 이미지 약 50개를 감사한 뒤 데이터를 수정하고, 동일한 설정과 분할로 재학습하여 클래스별 AP를 비교합니다. 그런 다음 다음으로 성능이 낮은 클래스로 이동합니다.
이미지 300개를 추가하면서 같은 재학습에서 imgsz도 높이면 어떤 변경이 점수를 움직였는지 알 수 없습니다. 데이터를 반복해서 개선하는 동안 설정과 분할은 동일하게 유지해 각 비교가 데이터 변경 하나만을 평가하도록 하세요.
하이퍼파라미터를 조정할 시점#
두세 차례 데이터 반복 개선을 진행한 뒤, 남은 성능 저하 클래스의 원인이 더 이상 커버리지, 라벨 또는 정의 문제가 아니라면 튜닝으로 마지막 몇 점을 끌어올릴 수 있습니다. 미세 조정 가이드에서 레이어 동결, 학습률, 옵티마이저 선택을 설명합니다. 하지만 데이터가 제대로 준비되기 전에 튜닝하면 잘못된 데이터셋으로 학습한 모델을 최적화하느라 몇 주를 허비하게 됩니다.
잠금된 테스트 세트에서 모델이 acceptance_test.py을 통과하면 프로덕션 환경의 Ultralytics YOLO에서 내보내기와 서빙을 다룹니다. Ultralytics Platform으로 구축하기의 상태 및 정확도 모니터링과 재학습 루프 자동화에서는 재학습 루프를 다룹니다.
정답 보기
실습 실행 결과, 조치가 필요한 클래스는 cup입니다. val에서 라벨이 지정된 14개 중 0개를 찾았고, 10개를 놓쳤으며, 4개를 다른 클래스로 분류했습니다. 규모를 정한 계획은 다음과 같습니다.
| 결과 | 데이터셋 작업 | 규모 |
|---|---|---|
| 14개 컵 중 10개를 놓침 | train 커버리지를 확인합니다. 카메라-날짜별로 컵이 있는 train 이미지를 세고, 컵이 없는 그룹에서 컵을 수집합니다. | 컵이 있는 이미지 40개를 카메라-날짜 4개에 걸쳐 새로 수집 |
| 14개 중 4개를 다른 클래스로 분류 | val_batch0_pred.jpg과 혼동 행렬에서 해당 항목을 엽니다. wine glass 또는 bowl로 분류되었다면, 서로 비슷한 두 클래스를 모두 cup 정의에 추가합니다. | 새 규칙에 따라 train 이미지 약 30개의 라벨을 다시 지정 |
| 인스턴스가 1개인 클래스 | 아직 조치하지 말고, 해당 클래스가 포함된 val 그룹을 추가합니다. | 다음 수집 단계 |
그런 다음 epochs 및 imgsz을 사용하고 분할은 변경하지 않은 채 재학습한 다음, rank_classes.py를 다시 실행하고 cup AP를 전후로 비교합니다. AP가 상승하면 데이터가 병목이었던 것입니다. 상승하지 않으면 하이퍼파라미터를 건드리기 전에 다음 이미지 50개를 감사합니다.