상태 및 정확도 모니터링
Platform의 엔드포인트 지표와 예측 통계를 확인하고, 예약된 상태 검사로 알림을 보내며, 홀드아웃 작업으로 정확도 드리프트를 감지합니다.
야간 근무조가 조명을 낮춰 정확도가 5포인트 떨어져도 엔드포인트는 모든 요청에 200 OK를 반환할 수 있습니다. Platform은 각 엔드포인트의 동작을 보여 주지만, 알림을 보내지 않으며 레이블 없이는 정확도를 확인할 수 없습니다. 이 강의에서는 이 간극을 해소하는 예약 검사를 두 가지 구축하고, 시뮬레이션한 야간 근무조를 사용해 정확도 알림을 연습합니다.
실습형
Platform에서 확인할 수 있는 항목#

| 신호 | 위치 | 유지 기간 |
|---|---|---|
| HTTP 요청, 오류율(4xx 및 5xx), P95 지연 시간 | 배포 페이지와 Deployments 탭의 카드, 1분마다 새로 고침 | 카드에는 24시간 데이터가 표시됩니다. API는 1시간에서 30일까지 데이터를 제공합니다. |
| 상태 | Overview 탭의 Endpoint 카드 | 실시간 표시; 상태가 비정상인 동안 자동으로 재시도 |
| 로그 | Logs 탭: 최근 20개 항목, Errors 필터 | API는 페이지네이션을 통해 요청당 최대 200개 항목을 반환합니다. |
| 예측 통계 및 임시 예시(최대 이미지 100개) | Monitoring 탭 | 서비스 인스턴스의 메모리에만 저장 |
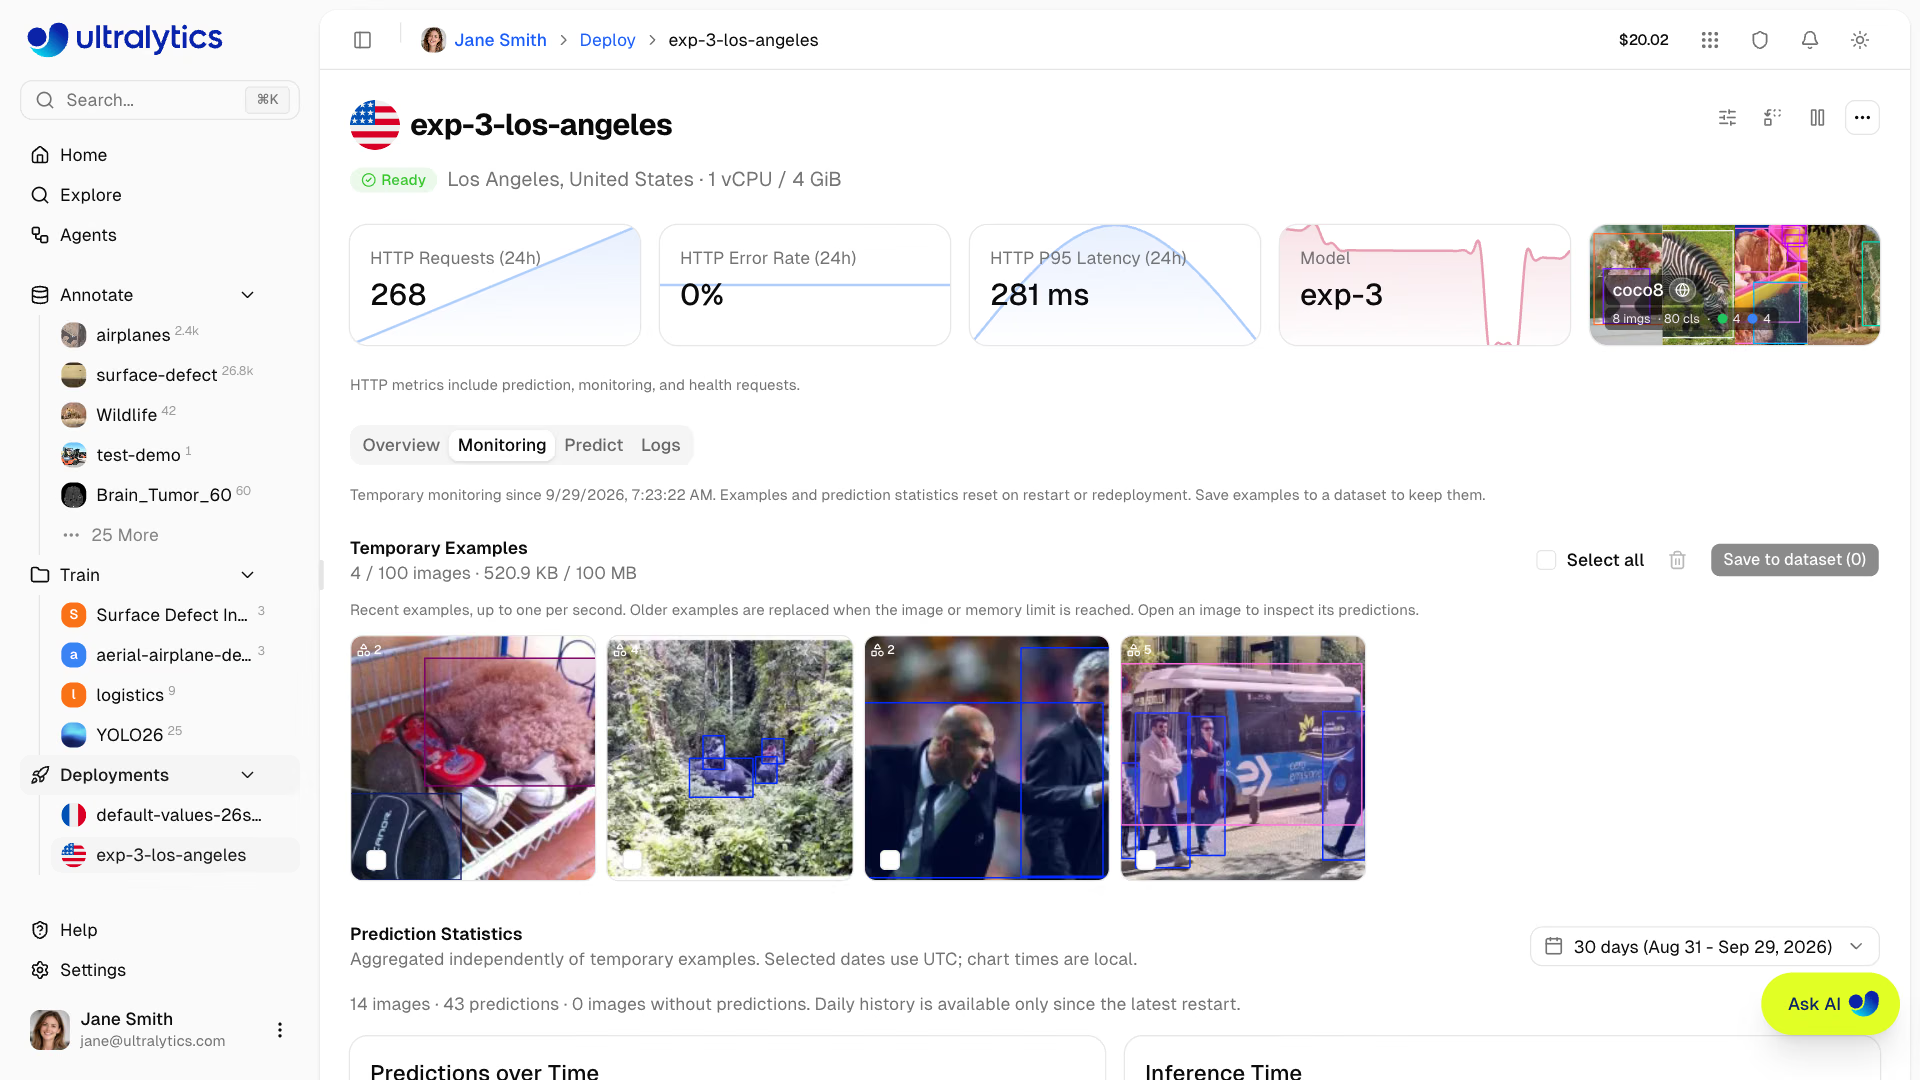
나머지 사항은 두 가지 유의점에 따라 달라집니다. 지표는 엔드포인트가 Ready 상태일 때만 수집되며, 배포를 삭제하면 이력에 접근할 수 없게 됩니다. 엔드포인트가 중지, 재시작, 크기 조정 또는 모델 교체될 때마다 Monitoring 탭의 통계와 예시는 사라집니다. 이는 아카이브가 아니라 실시간 보기입니다.
실전 예제: 예약 엔드포인트 검사#
Platform에서는 오류율이 5%를 넘으면 오류율 카드가 빨간색으로 바뀌며, Slack으로 배포 준비 완료 또는 시작 실패 알림을 받을 수 있습니다. 하지만 임계값 알림은 없습니다. cron, CI 또는 모니터링 에이전트에서 5분마다 이 검사를 실행하고, 종료 코드가 0이 아니면 호출 알림을 보내세요:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
정상 엔드포인트를 반환하는 스텁 API를 대상으로 실행하면 한 줄을 출력하고 0으로 종료합니다. P95_BUDGET_MS = 100일 때는 같은 데이터로 1을 반환합니다:
healthy=True requests=1200 p95=180 ms errors=0.40%health은 엔드포인트를 핑하고healthy,status,latencyMs을 반환합니다. 또한 0까지 축소된 엔드포인트를 깨우므로 5분 간격 검사는 웜 상태를 유지하기 위한 핑 역할도 합니다.metrics(..., view="overview")은totalRequests,errorRate(백분율), 해당 범위의p95LatencyMs을 반환합니다.logs은 최신 오류와 경고를 가져오므로 알림에 첫 번째 단서가 포함됩니다.
pip install -U ultralytics-platform으로 SDK를 설치합니다(SDK에는 Python 3.11 이상이 필요합니다). 예를 들어 검사 세 번 연속 실패처럼 지속적인 기준 위반에 대해서만 호출 알림을 보내고, 모든 알림에 한 줄짜리 런북 항목을 작성하세요.
실전 예제: 홀드아웃으로 정확도 추적하기#
요청 지표로는 정확도를 확인할 수 없습니다. 홀드아웃은 가능합니다. 프로덕션 상황을 잘 반영하고 신중하게 레이블을 지정한 이미지 200–500개를 별도의 비공개 데이터셋 버전에 넣고, 학습에는 사용하지 않습니다. 배포된 체크포인트를 매주 평가하고 결과를 이력 파일에 추가합니다:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
첫 실행에서 배포일 기준값을 기록합니다. 그런 다음 실제로 필요하기 전에 알림을 테스트합니다. 이 스크립트는 홀드아웃의 이미지와 레이블을 그대로 유지하면서 밝기를 15%로 낮춘 "야간 근무조" 복사본을 만듭니다:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbook야간 근무 중에도 모든 요청은 여전히 밀리초 안에 200을 반환하지만, 모델의 mAP는 5포인트 하락했습니다. 이를 감지하는 것은 홀드아웃뿐입니다. 매 분기 새로 레이블을 지정한 프로덕션 이미지로 홀드아웃을 갱신하고, 새 모델을 배포할 때마다 기준값을 재설정하세요. 모델 모니터링 가이드와 관측 가능성 및 드리프트 강의에서 통계적 드리프트 검사를 다룹니다.
드리프트 감지를 위해 Monitoring 탭 확인하기#
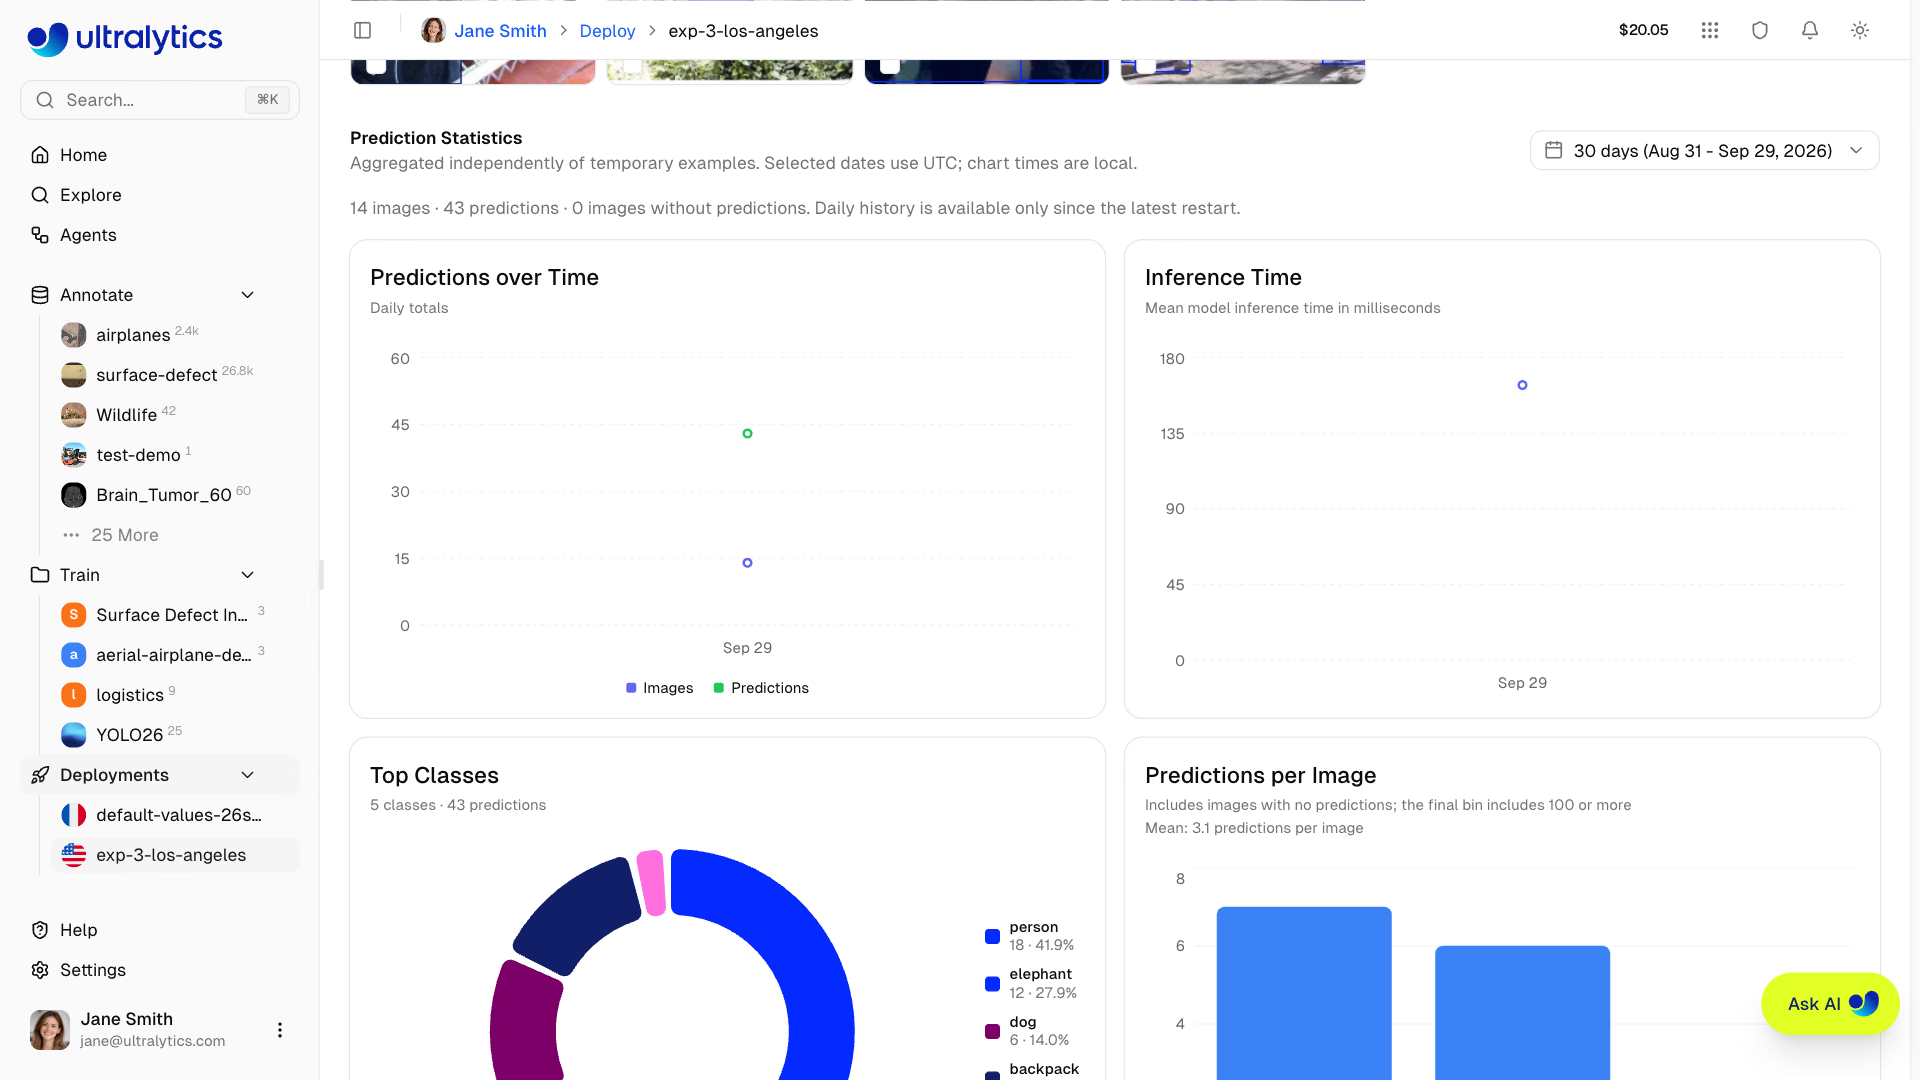
배포한 주의 차트 모양을 기록한 다음 비교합니다. 신뢰도는 확실성을 나타낼 뿐 정확성을 의미하지 않으므로, 홀드아웃 결과와 함께 확인하세요:
| 패턴 | 가능성 높은 원인 | 조치 |
|---|---|---|
| 신뢰도 하락, 홀드아웃 정확도 유지 | 무해한 도메인 시프트 | 추이를 확인하고 다음 데이터셋 버전에 추가할 예시를 저장합니다. |
| 신뢰도와 홀드아웃 결과 모두 하락 | 실제 정확도 저하 | 재학습(강의 10) |
| 박스 크기 또는 위치가 갑자기 변동 | 카메라 이동, 렌즈 또는 현장 변경 | 모델을 점검하기 전에 카메라를 확인합니다. |
| 이미지당 예측 수 감소, 신뢰도는 안정적 | 카메라 오프라인, 장면 변화 감소 또는 클라이언트 버그 | 상위 시스템을 조사합니다. |
| P95 지연 시간 상승, 추론 시간은 일정 | 요청 처리, 페이로드 크기 또는 용량 | 모델이 아니라 인프라 문제 |
프로덕션 이미지를 다시 반영하기#
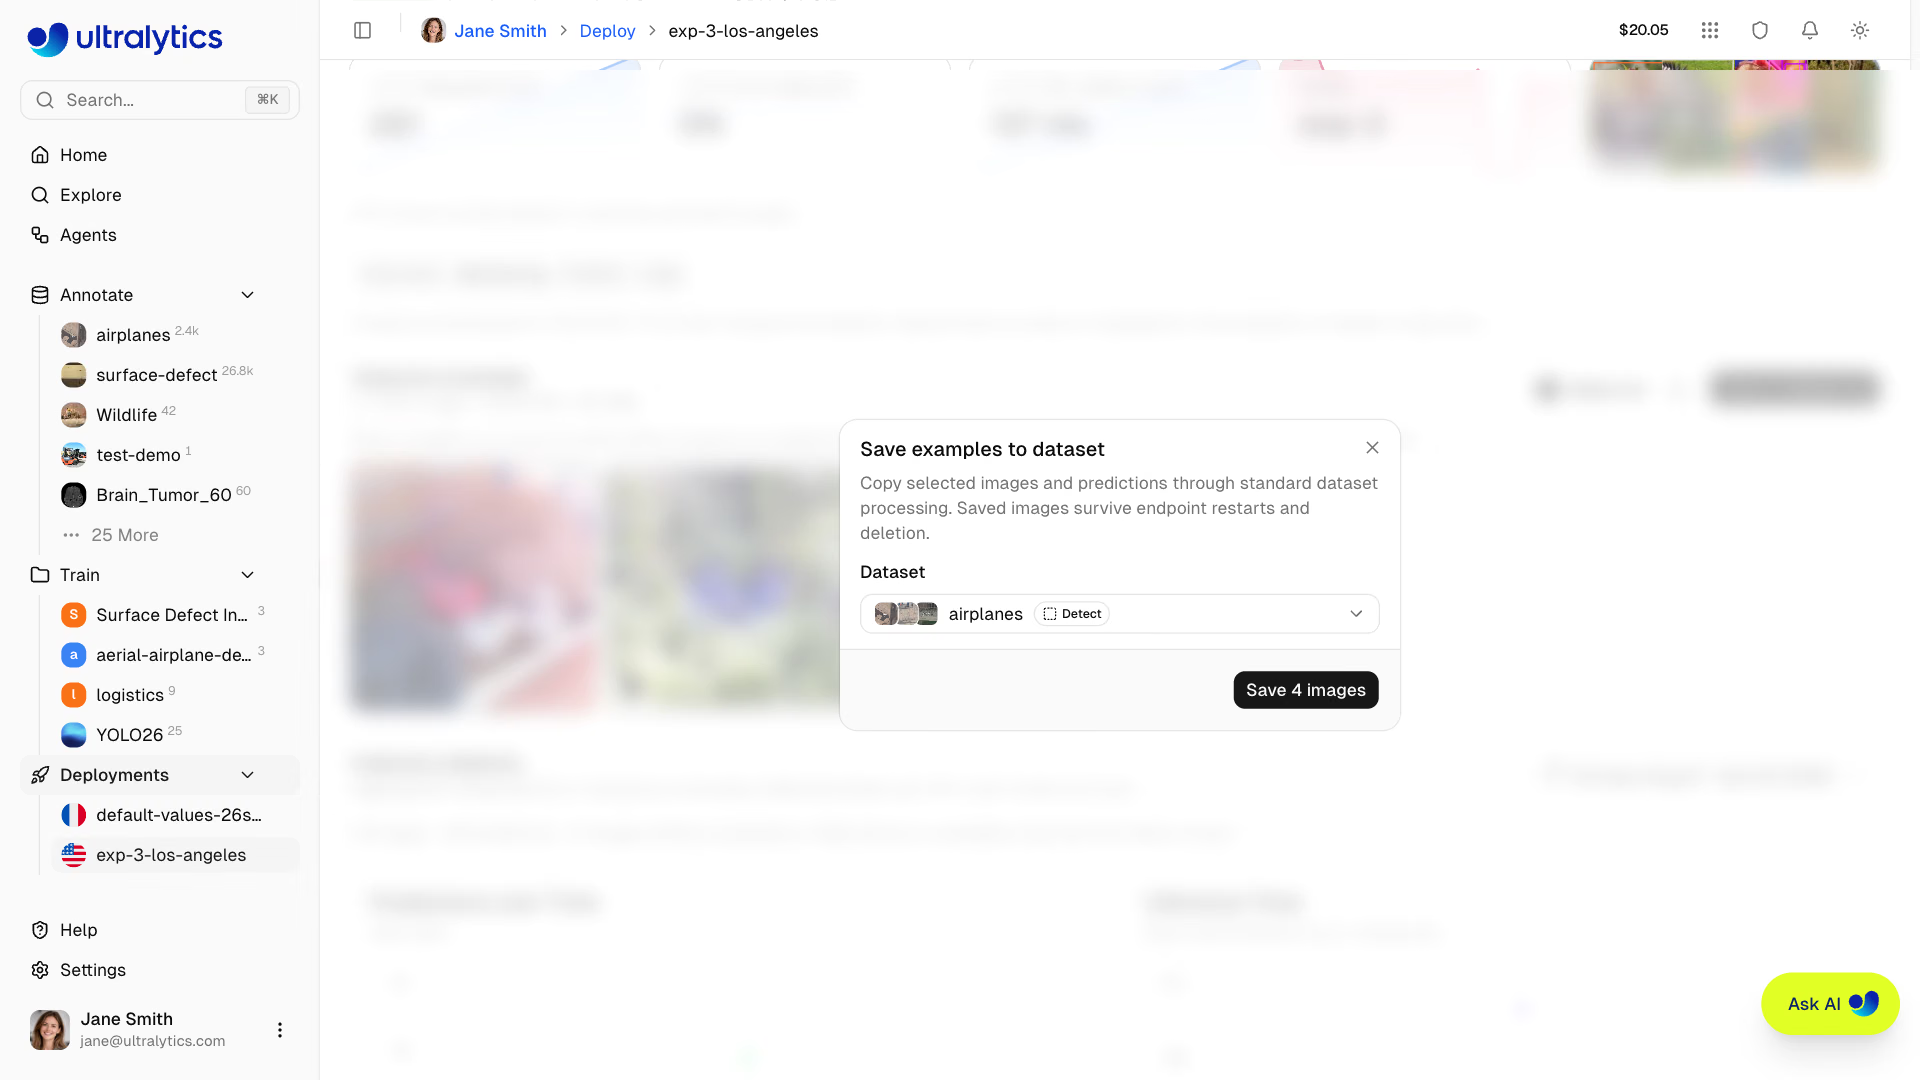
Monitoring 탭에서 예시를 선택하고 Save to dataset을 클릭합니다. 예시는 예측 결과와 함께 일반적인 수집 절차를 거쳐 데이터셋에 추가되며, 메타데이터에 deploymentId과 지역이 유지됩니다. Agents의 Collect Uncertain Detections 템플릿도 전체 데이터셋에 동일한 작업을 수행합니다. 배포를 통해 예측한 다음, 신뢰도 범위에 해당하는 탐지 결과가 있는 이미지를 검토용 데이터셋에 복사합니다.
주의할 점#
증상: 라벨링하려던 예제가 크기 조정이나 모델 교체 후 사라집니다. 해결 방법: 예제는 서빙 인스턴스의 메모리에 저장됩니다. 인스턴스를 중지하거나 크기를 조정하거나 모델을 교체하기 전에 예제를 데이터셋에 저장하고 수집이 완료될 때까지 기다리세요.
증상: 더 나은 모델을 배포한 직후 홀드아웃 알림이 발생하거나, 이후에는 다시는 알림이 발생하지 않습니다. 해결 방법: 기준선은 기록의 첫 번째 행입니다. 모델을 교체할 때마다 새 holdout_history.jsonl을 시작하거나 새 기준선 행을 기록하세요.
증상: 상태가 정상인데 트래픽 급증 중 오류율이 치솟습니다. 해결 방법: 429 응답은 오류로 집계되지만 '용량 초과'를 의미합니다. 로그를 확인하고 429 응답이라면 트래픽을 더 많은 엔드포인트에 분산하거나 더 큰 사용자 지정 크기를 사용하세요.
정답 보기
필 엔드포인트의 실행 예시입니다. P95_BUDGET_MS = 300과 MAX_ERROR_RATE = 1.0가 포함된 cron 항목 */5 * * * * python endpoint_check.py || ./page-oncall.sh을 사용합니다. 실제 P95가 180ms일 때 예산을 100ms로 설정하면 종료 코드 1을 반환하고 알림을 전송하므로 연결이 제대로 작동합니다. 주간 CI 작업은 비공개 홀드아웃 300개 이미지 버전에서 holdout_check.py과 DEPLOYED = "pills-v2.pt"를 실행합니다. 기준선은 0.69입니다. 야간 근무 시간대에 미리 실행한 테스트에서 점수가 0.05 하락하고 종료 코드 1과 함께 ALERT 행이 출력되어 CI 작업이 실패하고 채널에 알림이 전송됩니다. 저녁 근무 시간대의 Monitoring 예시 12개는 Save to dataset을 통해 pill-review에 저장하며, 각 예시에 deploymentId과 europe-west1을 태그로 지정합니다.