정리, 중복 제거 및 분할
두 개의 간단한 스크립트로 분할 간 중복과 클래스 누락을 찾고, 중요한 단위를 기준으로 분할한 다음 감사를 마친 데이터셋 버전을 고정합니다.
검증 점수의 신뢰성은 분할의 신뢰성에 달려 있습니다. 인기 있는 데모 데이터셋인 COCO128은 의도적으로 학습과 검증에 동일한 이미지 128개를 사용합니다. 자체 데이터에 이런 상황이 실수로 생기면 '훌륭한' 모델이 만들어지지만, 다음 카메라에서는 성능이 떨어집니다. 이 과정에서는 실제 데이터를 대상으로 중복 검사와 분할별 클래스 감사를 수행한 뒤, 카메라별로 분할하고 두 검사를 모두 통과한 버전을 고정합니다.
실습형
작업 예시: 분할 간 공유 이미지 찾기#
Platform은 업로드 충돌 처리 방법을 묻지만, 분할마다 이미지 사본 하나만 유지할 뿐 동일한 이미지나 장면이 학습과 검증 양쪽에 들어가는 것을 막지는 않습니다. 업로드 전과 데이터셋 병합 후에 확인하세요.
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']COCO128의 모든 검증 이미지는 학습 이미지이기도 합니다. 이는 스모크 테스트 데이터셋에서는 의도된 설정이며, 검증 mAP가 일반화 성능을 나타내지 못하는 정확한 이유입니다. 자체 데이터에서는 0이 아닌 개수가 하나라도 있으면 누수입니다. 학습 전에 각 이미지의 사본 하나를 옮기거나 삭제하세요.
Clustering으로 유사 중복 찾기#
해시는 바이트가 동일한 경우에만 찾습니다. 연속된 비디오 프레임, 연사 사진, 재인코딩된 사본은 몇 픽셀씩 차이가 납니다. 갤러리 도구 모음에서 산점도 아이콘을 열고 Analyze Dataset을 클릭합니다(이미지 20~200,000개, 업로드한 데이터셋만 지원).
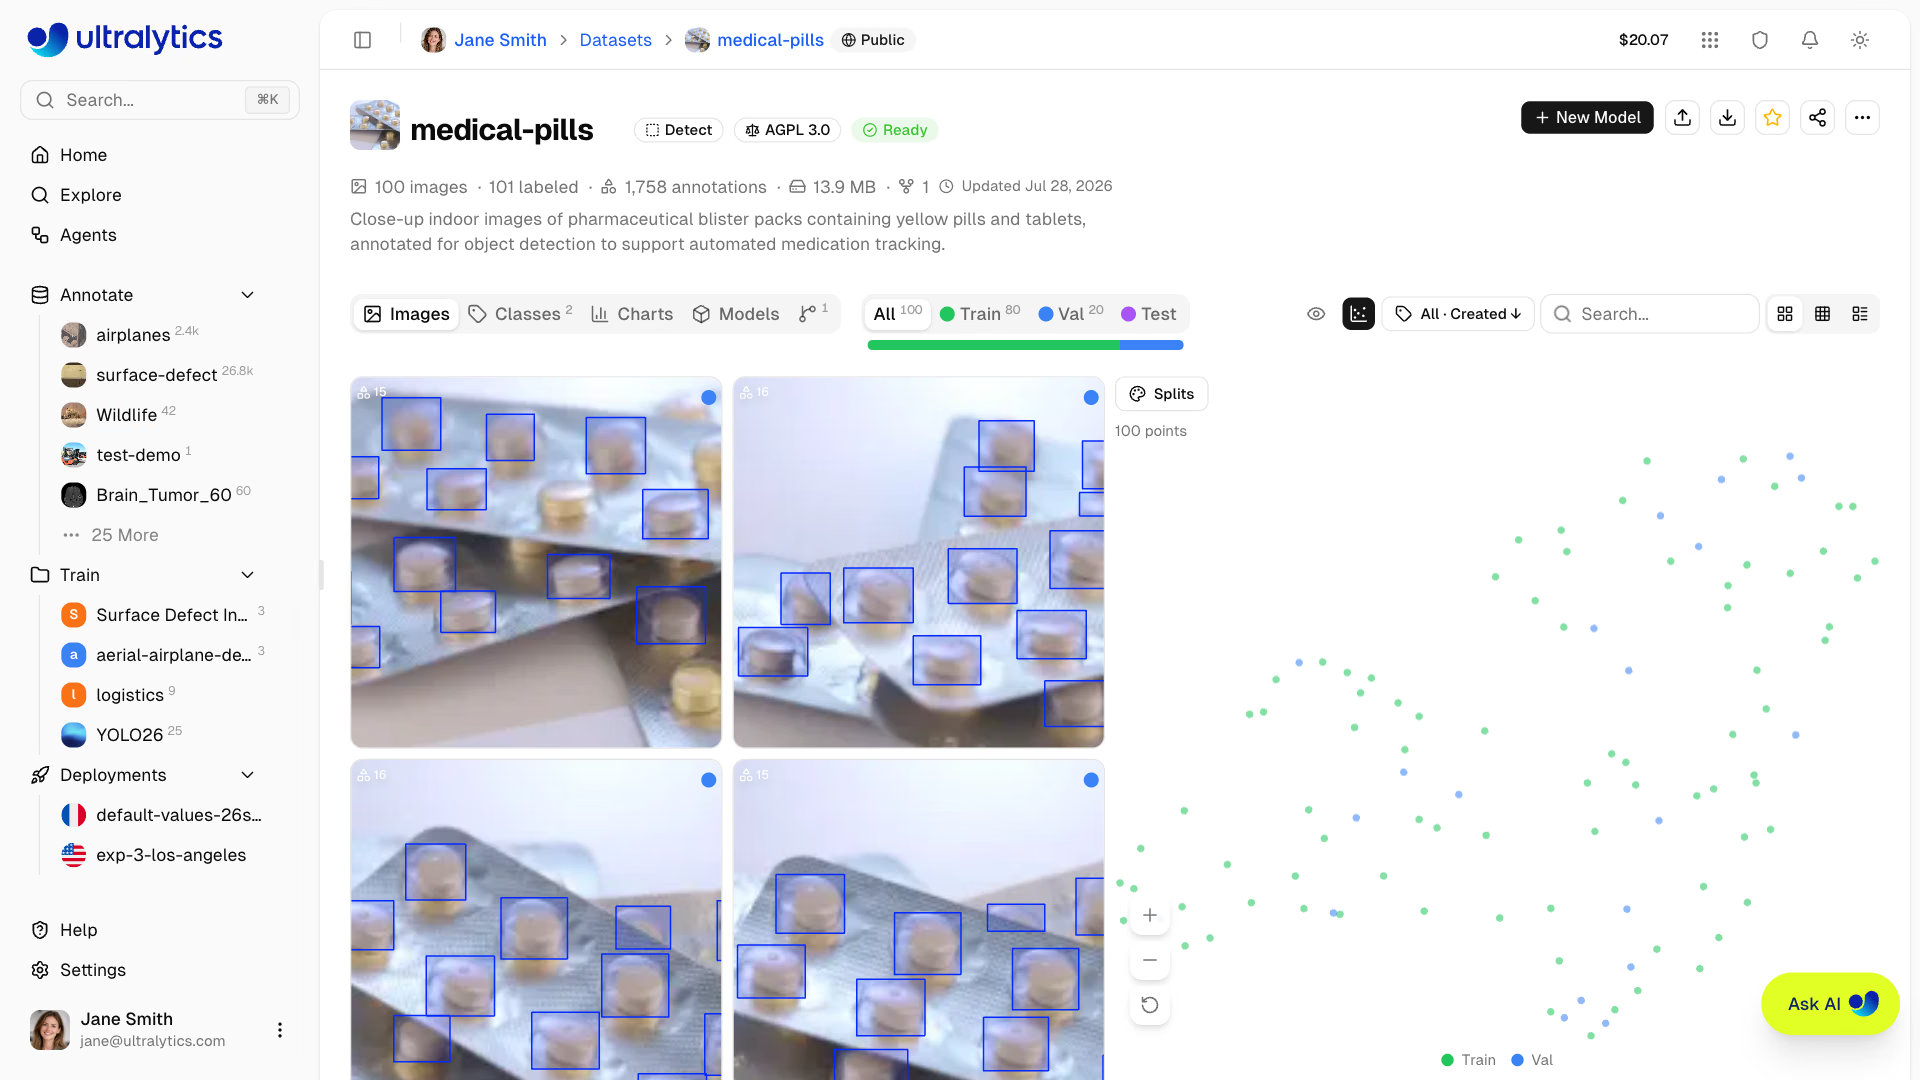
- 분할별 색상 지정: 학습과 검증 점이 섞여 있는 조밀한 군집은 유사 중복으로 인한 누수입니다.
- 클러스터 또는 클래스별 색상 지정: 단일 클래스가 크게 모여 있으면 데이터셋에서 해당 클래스가 과도하게 포함된 것입니다. 고립된 점은 이상치입니다(잘못된 카메라, 손상된 프레임, 잘못 라벨링된 이미지).
- 올가미 선택 또는 클릭으로 영역을 지정해 갤러리에서 해당 이미지(최대 1,000개)만 필터링한 다음 삭제하거나 이동하거나 라벨을 다시 지정합니다.
동일한 임베딩은 이미지 컨텍스트 메뉴의 유사 이미지 찾기 기능에도 사용됩니다. 이 기능은 공개 데이터셋과 팀 데이터셋의 유사 이미지를 미라벨링 이미지로 train에 추가하여, 아래 감사에서 발견한 누락 데이터를 가장 빠르게 보충할 수 있습니다.
작업 예시: 분할별 클래스 감사#
데이터셋 헤더 또는 Versions 탭에서 NDJSON 내보내기를 다운로드합니다. 헤더 다음 줄은 각각 분할과 라벨이 포함된 이미지 하나를 나타내므로, Python 몇 줄로 각 분할의 모든 클래스 개수를 셀 수 있습니다. 다음은 공개 COCO8 내보내기를 사용하는 예시입니다.
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in val읽는 방법: 헤더 줄에는 class_names이 있고, 각 탐지 박스는 [class, x, y, w, h]입니다. 학습에 없음은 모델이 해당 클래스를 전혀 학습할 수 없으며 해당 클래스의 검증 AP가 0이 된다는 뜻입니다. 검증 데이터가 너무 적음은 실행할 때마다 AP가 크게 달라진다는 뜻입니다. 검증 세트에 팔레트가 7개뿐이면 팔레트 하나를 놓칠 때 팔레트 AP가 약 14포인트 바뀝니다. COCO8은 이미지 8개로 구성된 스모크 테스트이므로 모든 클래스가 조건을 충족하지 못합니다. 프로덕션 버전에서는 경고가 하나도 표시되지 않아야 합니다. 튜닝이 아니라 예제를 더 수집해 누락을 해결하세요.
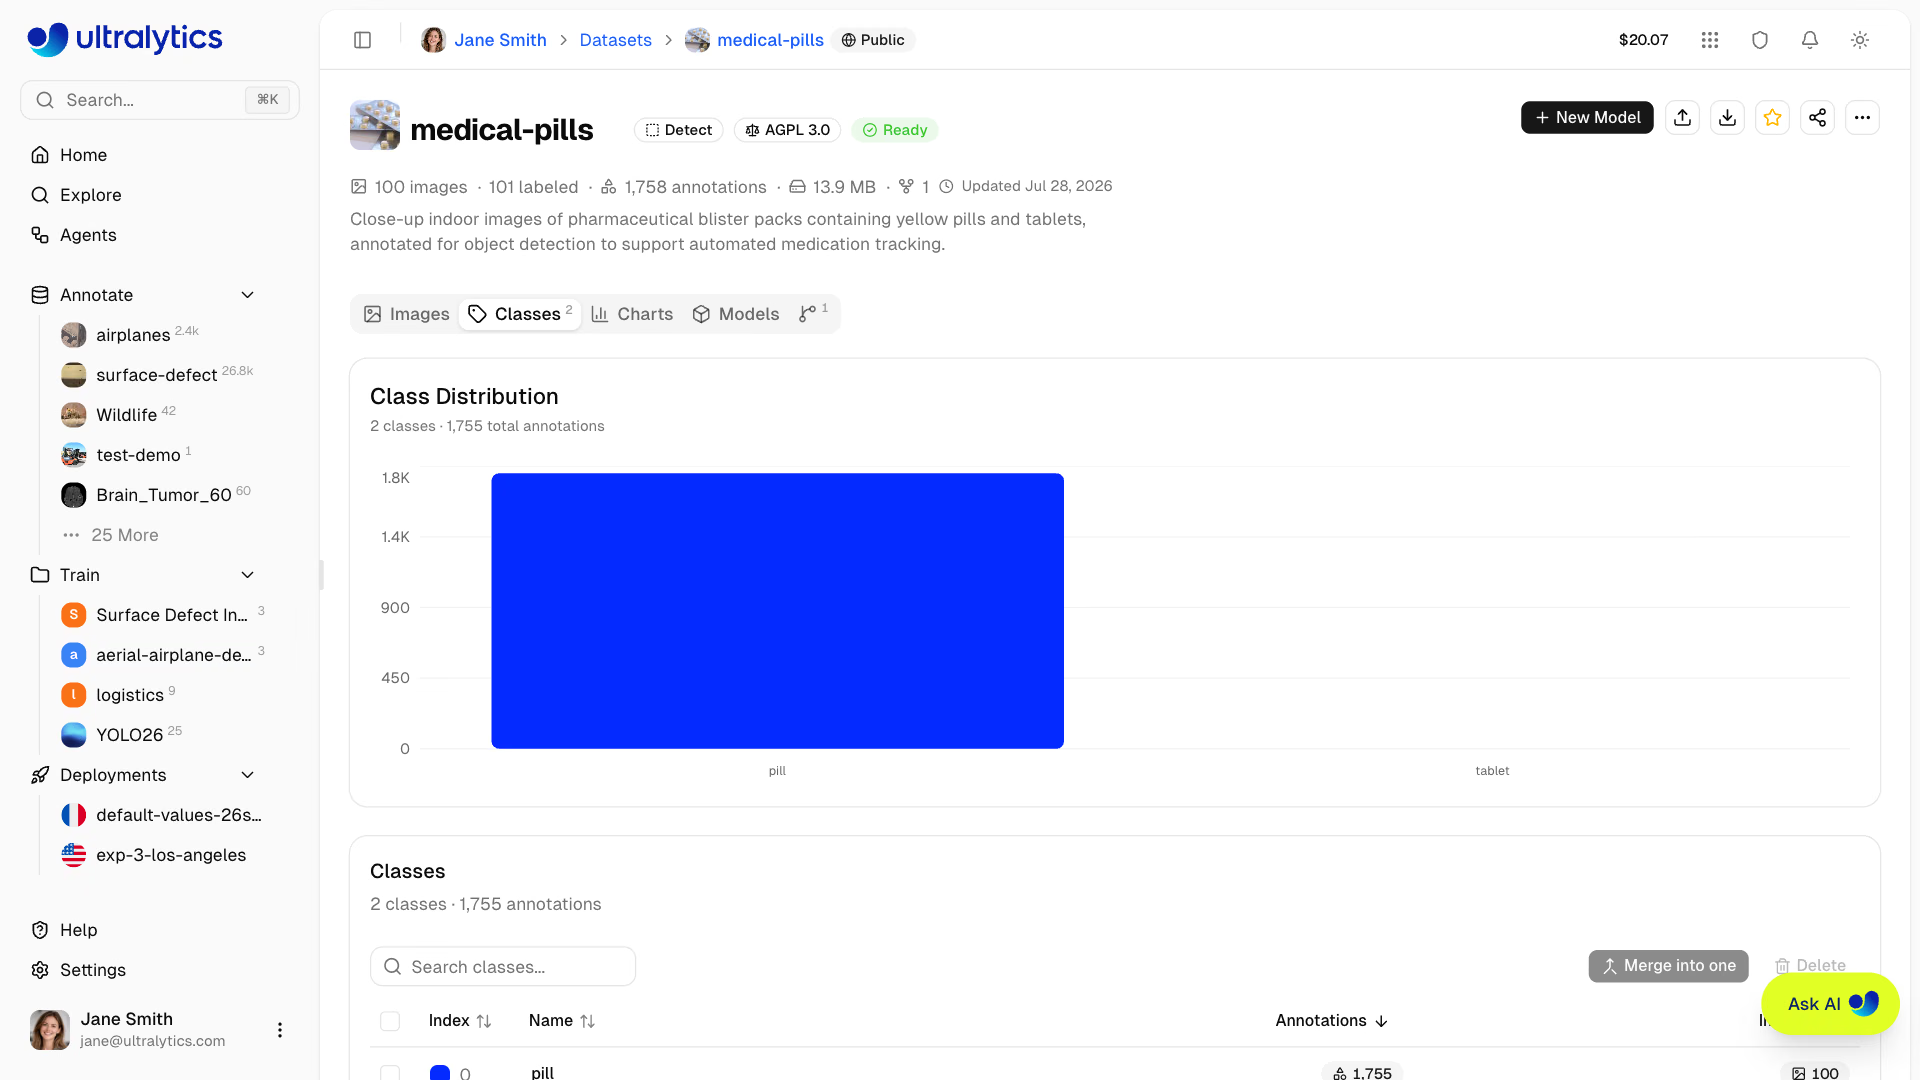
Classes 탭에서는 실제 데이터셋의 동일한 개수를 확인할 수 있으며, 불균형 데이터의 경우 로그 스케일을 설정할 수 있습니다. 하나로 병합하면 어노테이션을 잃지 않고 car, automobile, vehicle와 같은 중복 클래스를 하나로 합칩니다. 삭제하면 클래스와 해당 어노테이션을 모두 제거합니다.
일반화할 단위를 기준으로 분할하기#
같은 카메라, 세션 또는 날짜의 프레임은 서로 연관되어 있습니다. 이런 프레임이 학습과 검증 양쪽에 있으면 모델은 이미 본 장면으로 평가받습니다. 프로덕션에서 달라질 수 있는 전체 단위를 제외하세요. 새 카메라에 대응하려면 카메라를 제외하고, 같은 카메라로 다른 날짜에 촬영한 데이터를 대상으로 한다면 날짜를 제외합니다.
Platform의 분할 도구는 바로 이 점에서 차이가 있습니다.
| 도구 | 할당 방식 | 용도 |
|---|---|---|
업로드 내 train/, val/, test/ 폴더 | 사용자가 지정한 분할을 유지합니다 | 오프라인에서 준비한 그룹 분할 |
| 업로드 전에 분할 필터를 설정합니다 | 해당 업로드의 모든 파일을 선택한 분할에 넣습니다 | 분할별로 카메라 한 대씩 업로드하기 |
| 테이블 보기에서 분할로 이동 | 선택한 이미지를 이동합니다 | 특정 이미지 수정하기 |
| 분할 막대, 분할 재분배 | 모든 이미지를 무작위로 다시 할당합니다 | 독립적인 사진에만 사용합니다 |

데이터셋을 올바르게 분할하기 과정에서는 단위 선택 방법을 설명합니다. 아주 작은 데이터셋에서는 k-겹 교차 검증으로 더 많은 정보를 얻을 수 있습니다. 업로드 후 그룹을 확인하려면 클래스 감사에 그룹 키를 추가하고(예: cam07_000123.jpg으로 이름이 지정된 파일의 경우 record["file"].split("_")[0], 또는 이미지 메타데이터의 camera 필드), 두 분할에 모두 나타나는 그룹을 보고합니다.
검사를 통과한 버전 고정하기#
학습에는 고정된 스냅샷이 필요합니다. Versions 탭에서 설명("v5: cam07 제외, 팔레트 이미지 +80개")을 입력하고 새 버전을 클릭합니다. 각 버전은 다운로드, 비교 또는 복원이 가능한 변경 불가 번호 지정 NDJSON 스냅샷입니다. 학습 대화상자의 데이터셋 버전 저장도 실행 시 동일한 작업을 수행하며 변경 사항이 없으면 기존 버전을 재사용합니다. 연결된 클라우드 데이터셋이나 On Premise 데이터셋에서는 버전을 사용할 수 없습니다.
주의할 점#
증상: 자동 80/20을 클릭한 후 검증 mAP가 급등하지만 프로덕션 정확도는 그대로입니다. 해결 방법: 분할 재분배는 모든 이미지를 무작위로 다시 할당하며(이 과정에서 정확히 중복되는 이미지 제거), 서로 인접한 프레임이 train과 val에 나뉘어 들어갑니다. 그룹화된 데이터에는 업로드 폴더나 분할로 이동을 사용하세요.
증상: 이전에 내보낸 파일이나 모델의 예측 결과에 갑자기 잘못된 클래스 이름이 표시됩니다. 해결 방법: 클래스 ID는 위치에 따라 정해지므로 클래스를 병합하거나 삭제하면 그보다 높은 모든 인덱스가 하나씩 낮아집니다. 클래스를 변경하기 전에 버전을 만들고, 이전 라벨 파일을 재사용하지 말고 다시 학습하세요.
증상: 새 실행의 점수가 5포인트 낮아졌지만 다른 것은 바뀌지 않았습니다. 해결 방법: 동일한 분할에서만 지표를 비교할 수 있습니다. 분할을 변경할 때는 버전 설명에 이를 기록하고, 비교하기 전에 새 버전에서 기준선을 다시 실행하세요.
정답 보기
카메라 8대의 지게차 데이터셋에 대한 답안 예시입니다. 중복 검사에서 학습과 검증 간 동일 이미지 41개가 발견되며, 모두 다시 업로드된 폴더에서 비롯되었습니다. 검증 이미지 사본을 삭제합니다. group = record['file'].split('_')[0]을 추가한 감사에서는 cam02가 학습과 검증에 모두 나타납니다. 따라서 테이블 보기에서 cam02의 검증 이미지를 선택하고 분할로 이동 > 학습을 선택합니다. 감사에서 pallet: train 63, val 7, too few in val도 표시됩니다. 두 팔레트 이미지에서 유사 이미지 찾기를 사용해 유사한 미라벨링 이미지 40개를 추가하고 라벨링한 다음, cam07 전체가 같은 분할에 남도록 cam07의 팔레트 이미지 15개를 검증으로 이동합니다. 다시 실행한 결과 중복 0개, 누수 그룹 0개, 검증 팔레트 22개입니다. 분할별로 색상을 지정한 Clustering에서는 혼합된 군집이 보이지 않습니다. v5: cam07 val, cam08 test, +40 pallets를 저장합니다.