실행 비교 및 최적 모델 선택
Platform 프로젝트에서 실행을 비교하고, 각 실행의 목적을 기록한 다음, 스크립트로 작성한 승격 심사 기준에 따라 후보 모델의 배포 여부를 결정합니다.
더 큰 모델은 대표 지표에서 대체로 우수하지만, 아무도 확인하지 않은 특정 클래스에서는 성능이 떨어지는 경우가 많습니다. 사전에 규칙을 정하지 않으면 누군가 가장 마음에 들어 한 실행이 배포됩니다. 이 강의에서는 나중에 판단 근거를 찾을 수 있도록 모든 실행을 기록하고, '더 나은가?'라는 질문을 PASS 또는 FAIL을 반환하는 심사 스크립트로 바꿉니다.
실습형
프로젝트에서 실행 비교하기#
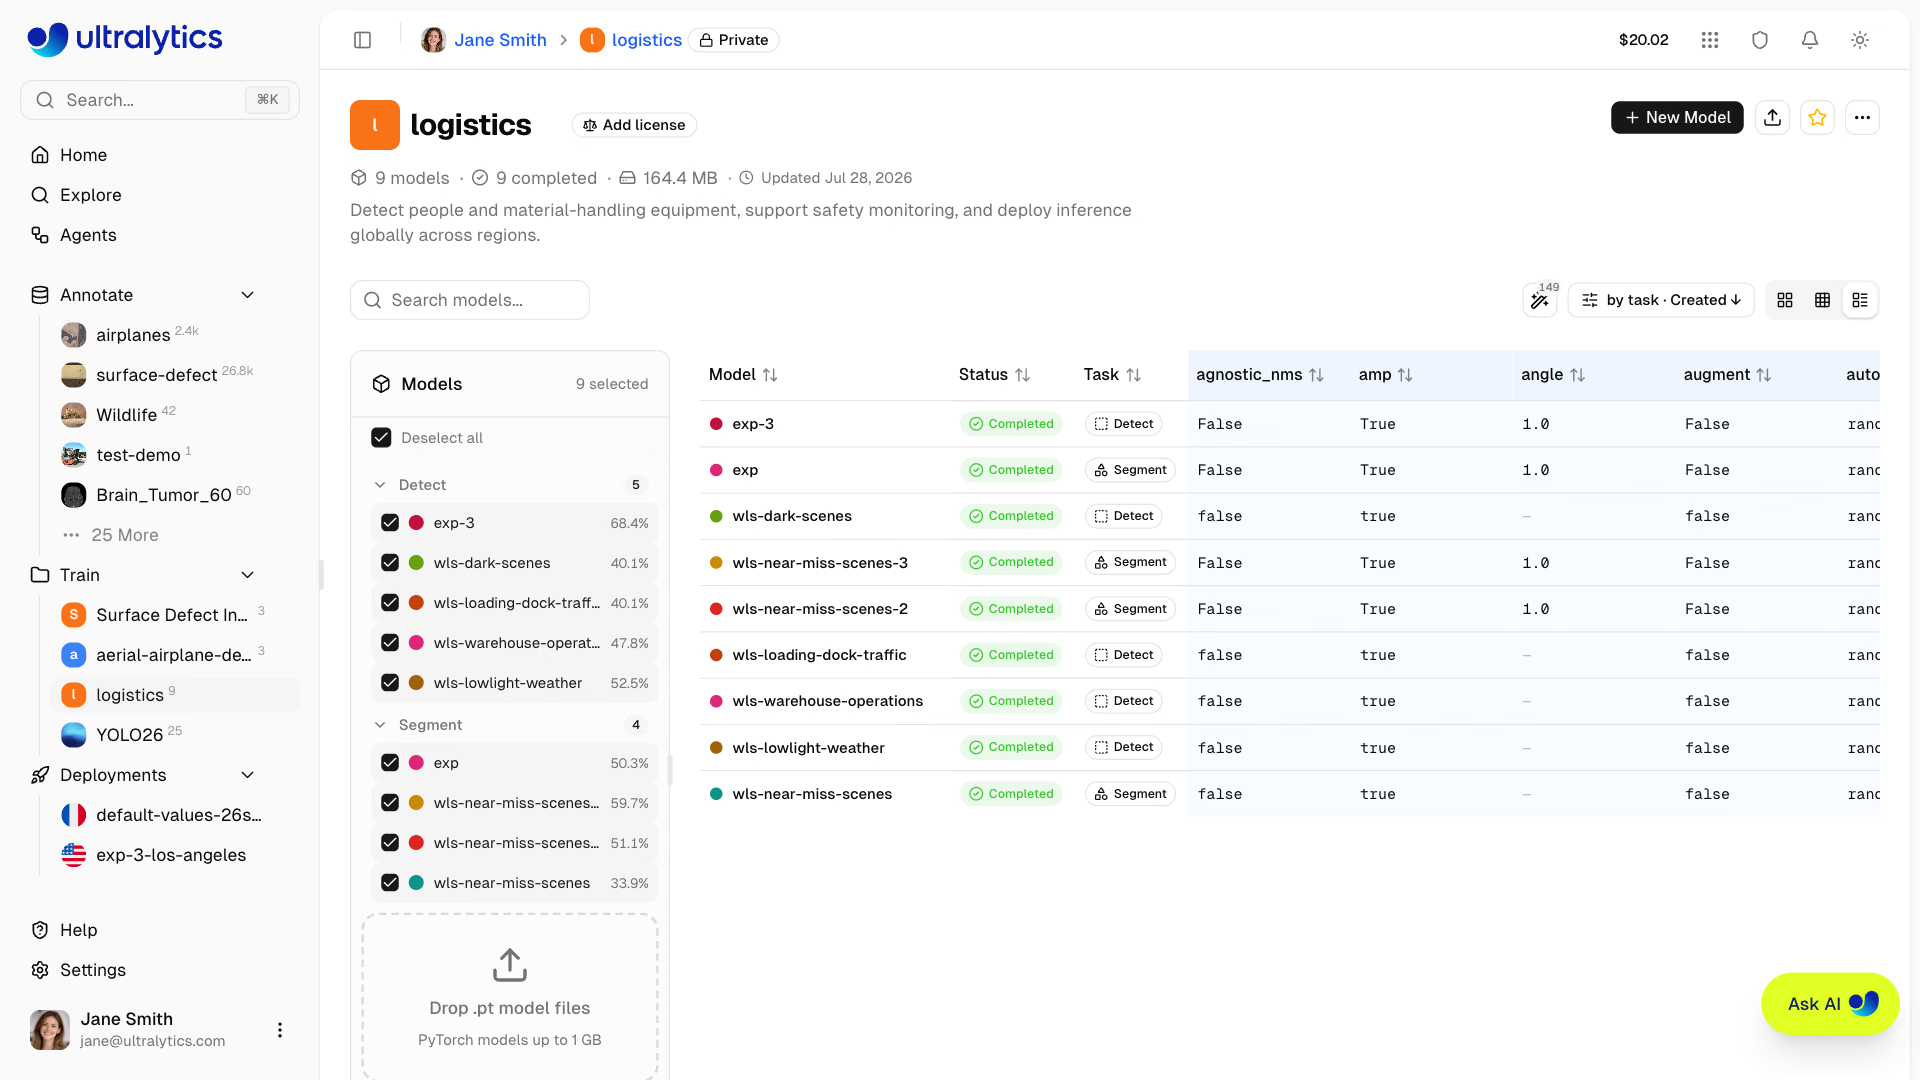
프로젝트에는 확인란과 함께 모델이 나열됩니다. 선택한 모델은 Charts 대시보드에 겹쳐 표시됩니다. Table 보기에서는 학습 인수와 최종 지표를 나란히 확인할 수 있으며, Diff는 동일한 열을 숨겨 두 실행이 imgsz만 다르다는 점을 한눈에 보여 줍니다. 비교는 하나의 프로젝트 안에서만 가능하므로 관련 실험을 함께 관리하세요(모델은 프로젝트 간에 잘라내고 붙여 넣을 수 있습니다). 곡선을 살펴볼 때는 최종값, 각 실행이 해당 값에 도달한 속도, 곡선의 안정성을 비교하세요.

완료된 모델이 두 개 이상 있으면 Compare with AI를 통해 Ask AI에 차이 요약과 다음 실험 제안을 요청할 수 있습니다. 제안은 판정 결과가 아니라 다음 실행을 위한 가설로 취급하세요.
모든 실행의 근거를 명확히 기록하기#
이름에 의미를 담으세요. run_5은 아무것도 알려 주지 않지만, v3_pallets_added과 v4_imgsz1024는 데이터셋 버전과 변경 사항을 보여 줍니다. 판단 근거를 기록하려면 모델 페이지에서 More actions > Information을 열고 JSON 메모를 Custom Metadata로 저장하세요:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
나머지 정보는 Platform에서 기록합니다. Run Information 카드에는 GPU, 시간당 요금, 총비용, ultralytics 버전, 호스트, 상위 모델, 고정된 데이터셋 버전, 사용 가능한 경우 Git 커밋, 복사 가능한 yolo train 명령이 표시됩니다. 공정한 비교를 위해서는 동일한 데이터셋 버전에서 실행해야 하므로 모든 실행에 데이터셋 버전을 고정해야 합니다.
결과를 확인하기 전에 지표와 심사 기준 선택하기#
| 지표 | 적합한 경우 |
|---|---|
| mAP50-95 | detect, segment, pose, OBB의 기본 지표입니다. 박스의 정밀도를 반영하며 비교적 안정적으로 비교할 수 있습니다. |
| mAP50 | 박스의 정밀도가 크게 중요하지 않은 크고 서로 분리된 객체 |
| 단일 클래스에 대한 클래스별 AP | 비즈니스 가치가 하나의 클래스에 좌우되는 경우 |
| 정밀도를 고정한 상태의 재현율 | 안전 및 경보 시스템 |
| 대상 장치의 추론 지연 시간 | 항상 하드 제한으로 적용 |
YOLO 성능 지표 가이드에서 각 지표를 설명합니다. 후보 모델은 모든 심사 기준을 통과해야 배포할 수 있습니다:
실습 예제: 승격 심사 스크립트#
최종 후보의 best.pt 파일을 다운로드하고 동일한 코드로 동일한 데이터에서 점수를 산출하세요. 이 예제에서는 어디서나 실행할 수 있도록 공식 체크포인트 두 개를 사용합니다:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experiments결과: 더 큰 모델은 전체 점수에서 2.4포인트 앞섰지만 두 클래스의 AP가 10% 넘게 하락해 심사에 실패했습니다. 대표 지표만 비교하면 이런 회귀를 놓칠 수 있습니다. 클래스별 딕셔너리는 ap_class_index 및 ap에서 가져오며, 데이터에 있는 클래스만 포함합니다. 지연 시간은 스크립트를 실행하는 시스템에서 측정되므로 배포 대상과 비슷한 하드웨어에서 심사를 실행하세요. COCO8에는 검증 이미지가 8개뿐이므로 실제 판단을 내리기에는 턱없이 부족합니다. 최소 수백 개의 이미지가 있는 홀드아웃 세트를 사용하고, 최종 판단을 위해 split="test"를 정확히 한 번 전달하세요.
성능이 낮은 이미지 자세히 살펴보기#
저장된 데이터셋 버전으로 학습한 detect 실행의 경우 Validation 보기에 Validation insights가 추가됩니다. 여기에는 정답이 함께 표시된 이미지별 F1 기준 최저 및 최고 성능 이미지, F1과 이미지 크기, 종횡비, 인스턴스 수의 상관관계를 보여 주는 특성 탐색기, 실패와 가장 연관성이 높은 클래스가 포함됩니다. 최악의 이미지에서 Find similar를 사용하면 유사한 이미지를 레이블이 지정되지 않은 상태로 학습 세트에 추가할 수 있어 실패한 심사를 구체적인 데이터 작업으로 전환할 수 있습니다.
주의할 점#
증상: 보고된 테스트 mAP는 훌륭하지만 프로덕션 성능은 더 나쁩니다. 해결 방법: val에서 튜닝하세요. 테스트 세트에서 10개 실행을 비교했다면 이미 테스트 세트에 맞춰 튜닝한 것이므로 결과 수치가 실제보다 높게 나타납니다. 최종 후보는 맨 마지막에 테스트 세트에서 한 번만 평가하세요.
증상: 한 실행 결과가 4포인트 높아 '승리'했지만, 아무도 그 이유를 재현할 수 없습니다. 해결 방법: 각 실행의 Run Information 카드에서 고정된 데이터셋 버전을 확인하세요. 버전이 다르면 비교하기 전에 새 버전에서 기준선을 다시 실행하세요.
증상: 새 시드로 다시 학습할 때마다 우승 모델이 바뀝니다. 해결 방법: 대부분의 데이터셋에서 약 0.5 mAP 포인트 미만의 차이는 실행 간 노이즈입니다. 게이트에 노이즈 임계값을 유지하고, 결과 차이가 이 정도로 작으면 더 큰 홀드아웃 세트를 사용하세요.
정답 보기
알약 모델의 예시 답변: 기준 모델 v1-baseline(10 epochs)과 후보 모델 v2-finetune(5 epochs 추가, SGD, lr0 0.001)을 비교합니다. DATA = "medical-pills.yaml"와 두 개의 가중치를 gate.py에 설정합니다. 출력: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms. 결론은 '후보 모델 배포'입니다. v2의 Custom Metadata: 가설 'v1은 epoch 10에서도 계속 개선 중이었다', 변경 사항 '5 epochs fine-tuning, SGD lr0 0.001', 결과 'mAP50-95 0.659 -> 0.687'. 메타데이터에 주의 사항도 기록하세요. medical-pills 검증 데이터도 학습 방향을 정하는 데 사용되었으므로, 프로덕션 배포 전에 별도의 홀드아웃 데이터에서 확인해야 합니다.