엔드포인트 배포 및 호출
42개 리전 중 하나에 전용 엔드포인트를 만들고 트래픽에 맞게 크기를 설정한 다음, 콜드 스타트, 429 응답, 잘못된 키를 처리하는 클라이언트로 호출합니다.
제로 스케일링되는 무료 엔드포인트는 첫 요청에 응답하는 데 최대 1분이 걸릴 수 있으며, 단순한 클라이언트를 사용하면 사용자가 타임아웃을 경험하게 됩니다. 키가 유출되면 삭제한 후에도 계속 사용할 수 있습니다. 이 강의에서는 최적 모델을 배포하고 엔드포인트 크기를 신중하게 설정한 다음, 프로덕션 통합에 필요한 간단한 클라이언트를 작성합니다.
실습형
공유 추론 또는 전용 엔드포인트#
모든 모델은 이미 Platform의 공유 추론 API를 통해 호출할 수 있어 테스트에 적합합니다. 프로덕션 트래픽에는 전용 엔드포인트를 사용하세요:
| 공유 추론 | 전용 엔드포인트 | |
|---|---|---|
| 서비스 | Platform 사용자 간 공유 | 단일 테넌트 전용 모델 하나 |
| 리전 | 데이터 리전(US, EU 또는 AP) | 42개 리전 중 선택 |
| 요청 제한 | 키당 분당 20개 요청 | 직접 호출에는 Platform 제한 없음 |
| 요청 크기 | 약 4.5 MB | 32 MB, 요청당 최대 1시간(비디오 지원) |
| 인증 | 모든 워크스페이스 API 키 | 배포에 연결된 키만 |
엔드포인트 생성 및 크기 설정#
모델의 Deploy 탭을 엽니다. 브라우저에서 42개 지역(미주 14개, 유럽 13개, 아시아 태평양 12개, 중동 및 아프리카 3개)까지의 지연 시간을 측정하고, 측정된 지연 시간을 기준으로 표를 정렬합니다:
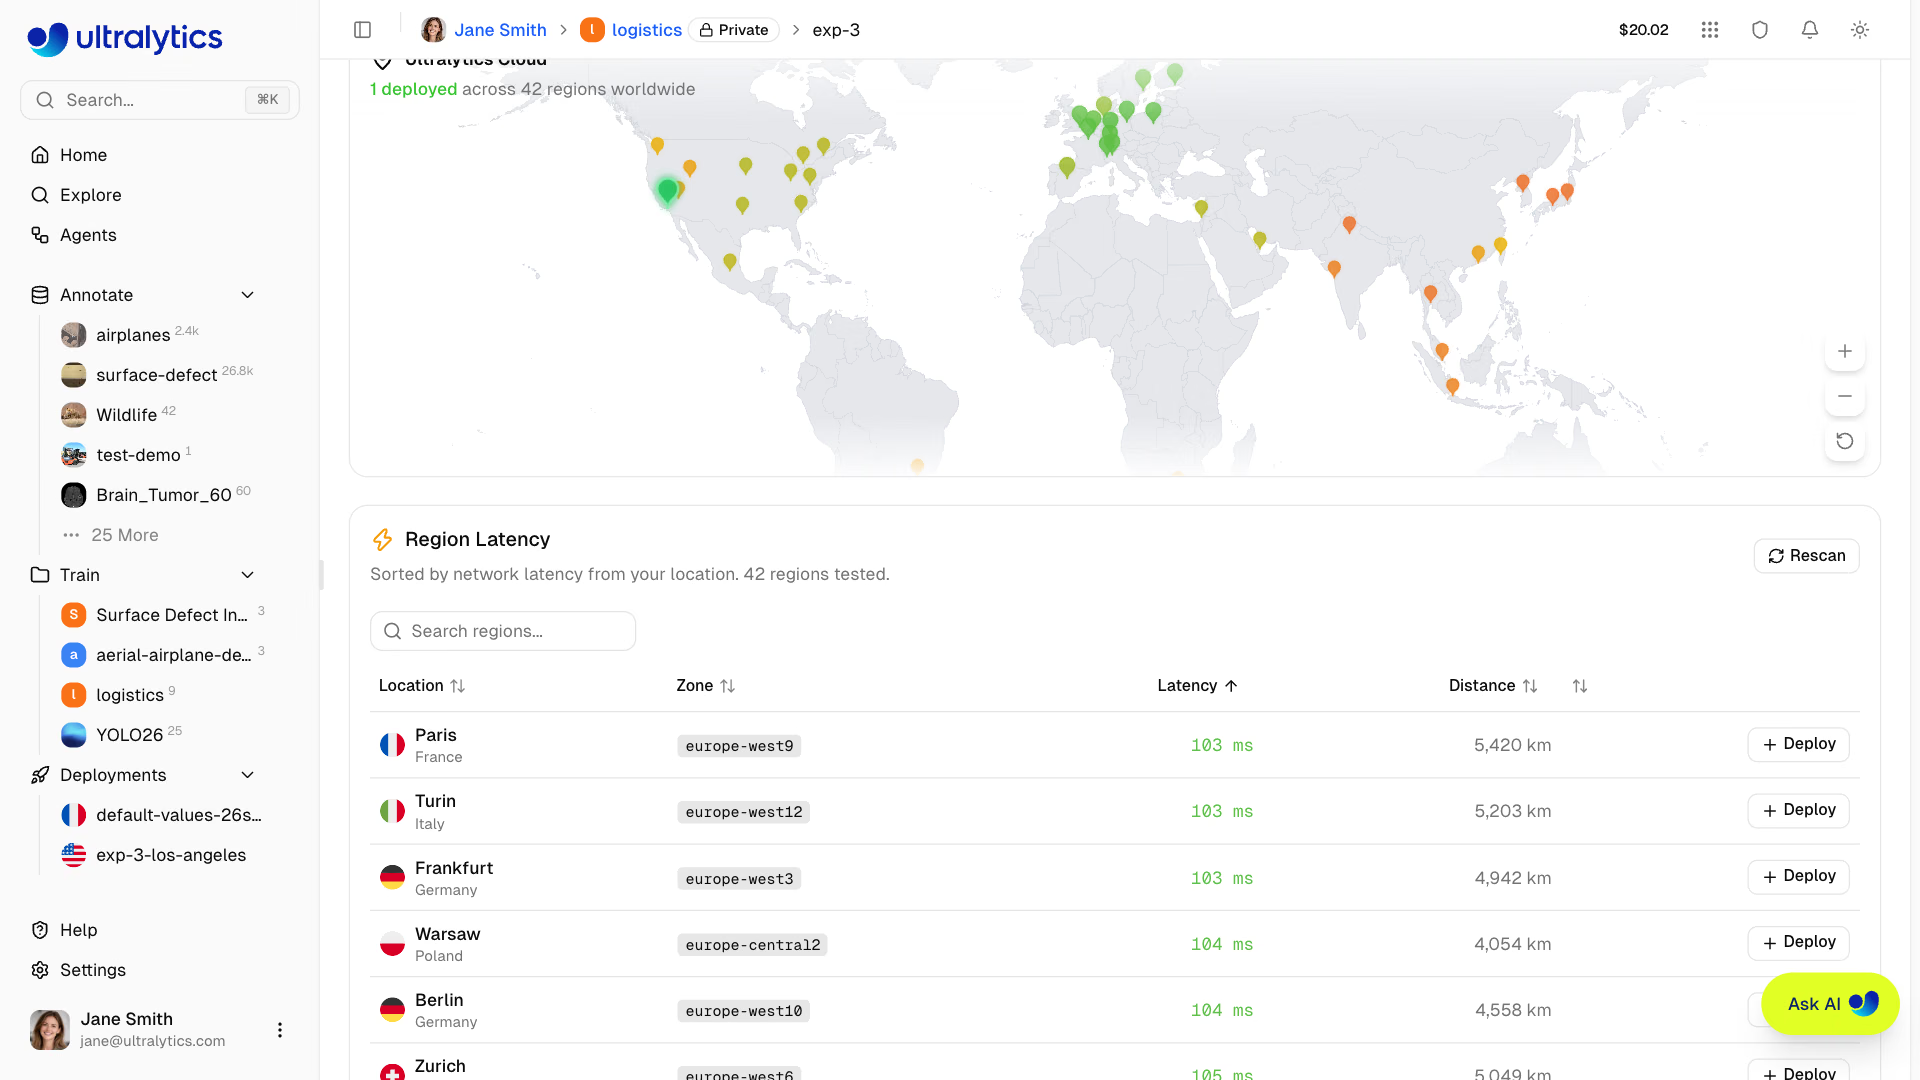
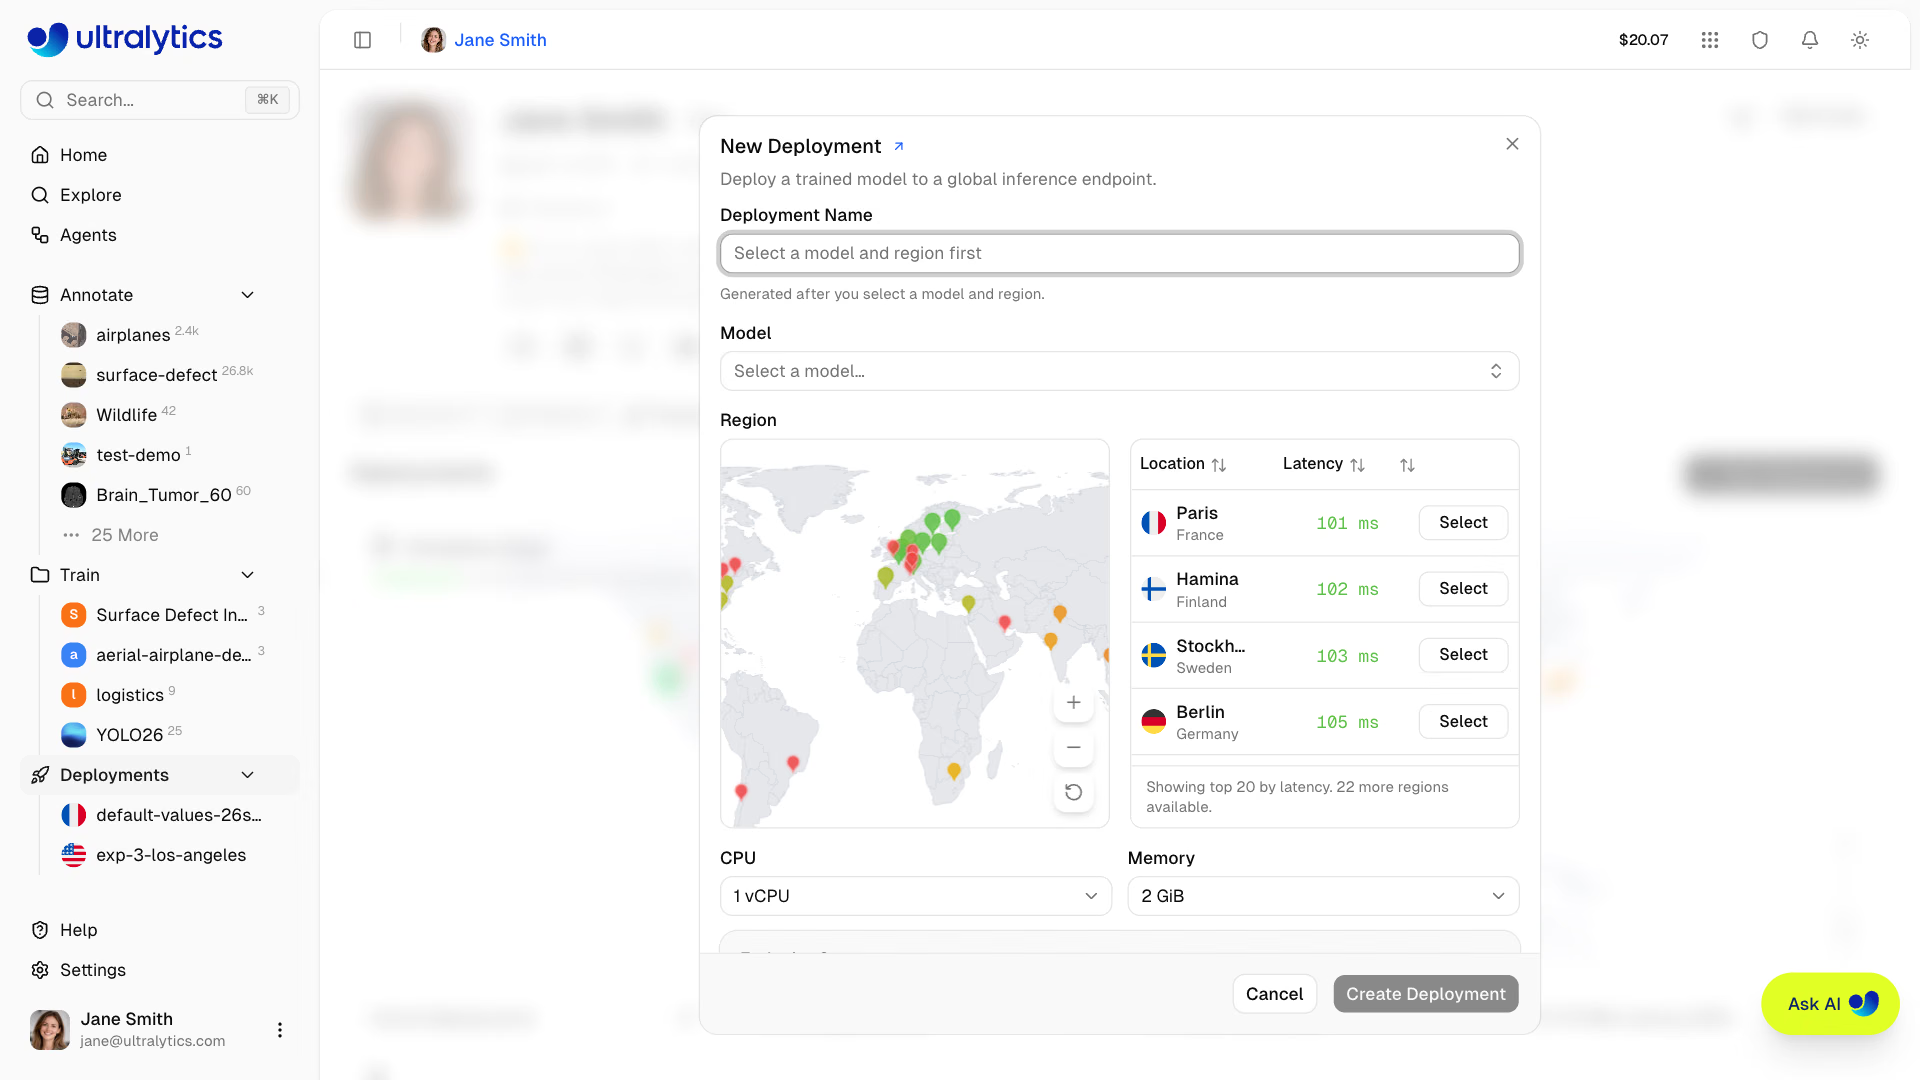
호출자와 가장 가까운 행에서 Deploy를 클릭하고 CPU, 메모리, 가격, 생성된 이름(예: yolo26n-iowa)을 확인한 다음 Create Deployment를 클릭합니다. 프로필의 Deployments 탭에서 New Deployment를 선택해 시작할 수도 있습니다:
트래픽 패턴에 따라 크기를 설정합니다:
| 트래픽 | 규모 | 비용 |
|---|---|---|
| 배치 작업, 내부 도구, 트래픽이 급증하는 데모 | 기본값 1 vCPU, 2 GiB; 0까지 축소 | 모든 요금제에서 무료 |
| 콜드 스타트를 기다릴 수 없는 지속적인 실시간 트래픽 | 사용자 지정 크기(1–8 vCPU, 2–32 GiB), 웜 인스턴스 1개 | 준비 상태가 된 시점부터 중지할 때까지 시간 단위로 과금되며 유휴 시간도 포함됩니다. 아이오와 기준 1 vCPU, 4 GiB는 시간당 약 $0.12입니다. |
| 여러 대륙에 있는 사용자 | 자체 라우터 뒤에 지역별 엔드포인트 하나씩 배치 | 각 엔드포인트는 크기에 따라 과금됩니다. |
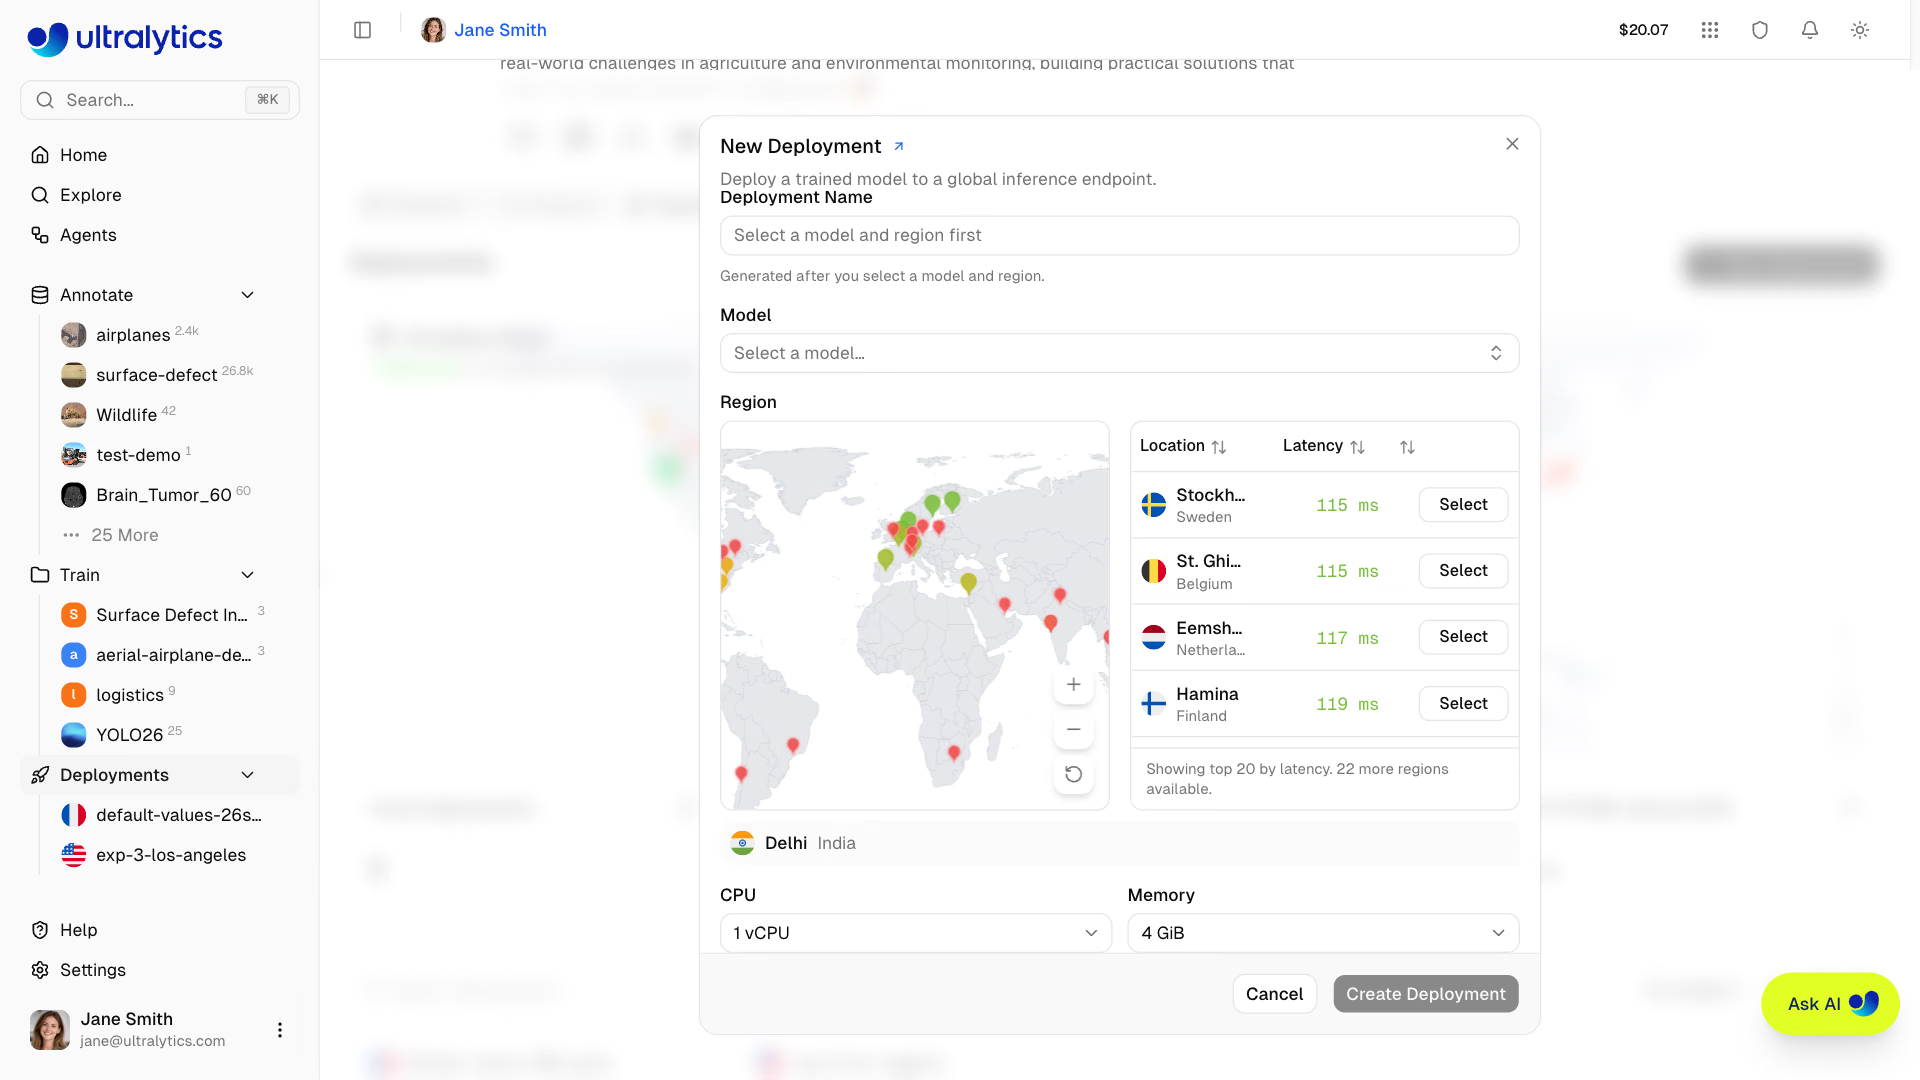
요금제별 배포 수는 Free 3개, Pro 10개, Enterprise 무제한이며, 중지된 엔드포인트도 개수에 포함됩니다. 배지가 Ready로 표시되면 엔드포인트가 트래픽을 수신합니다:
실전 예제: 프로덕션에서도 안정적으로 작동하는 클라이언트#
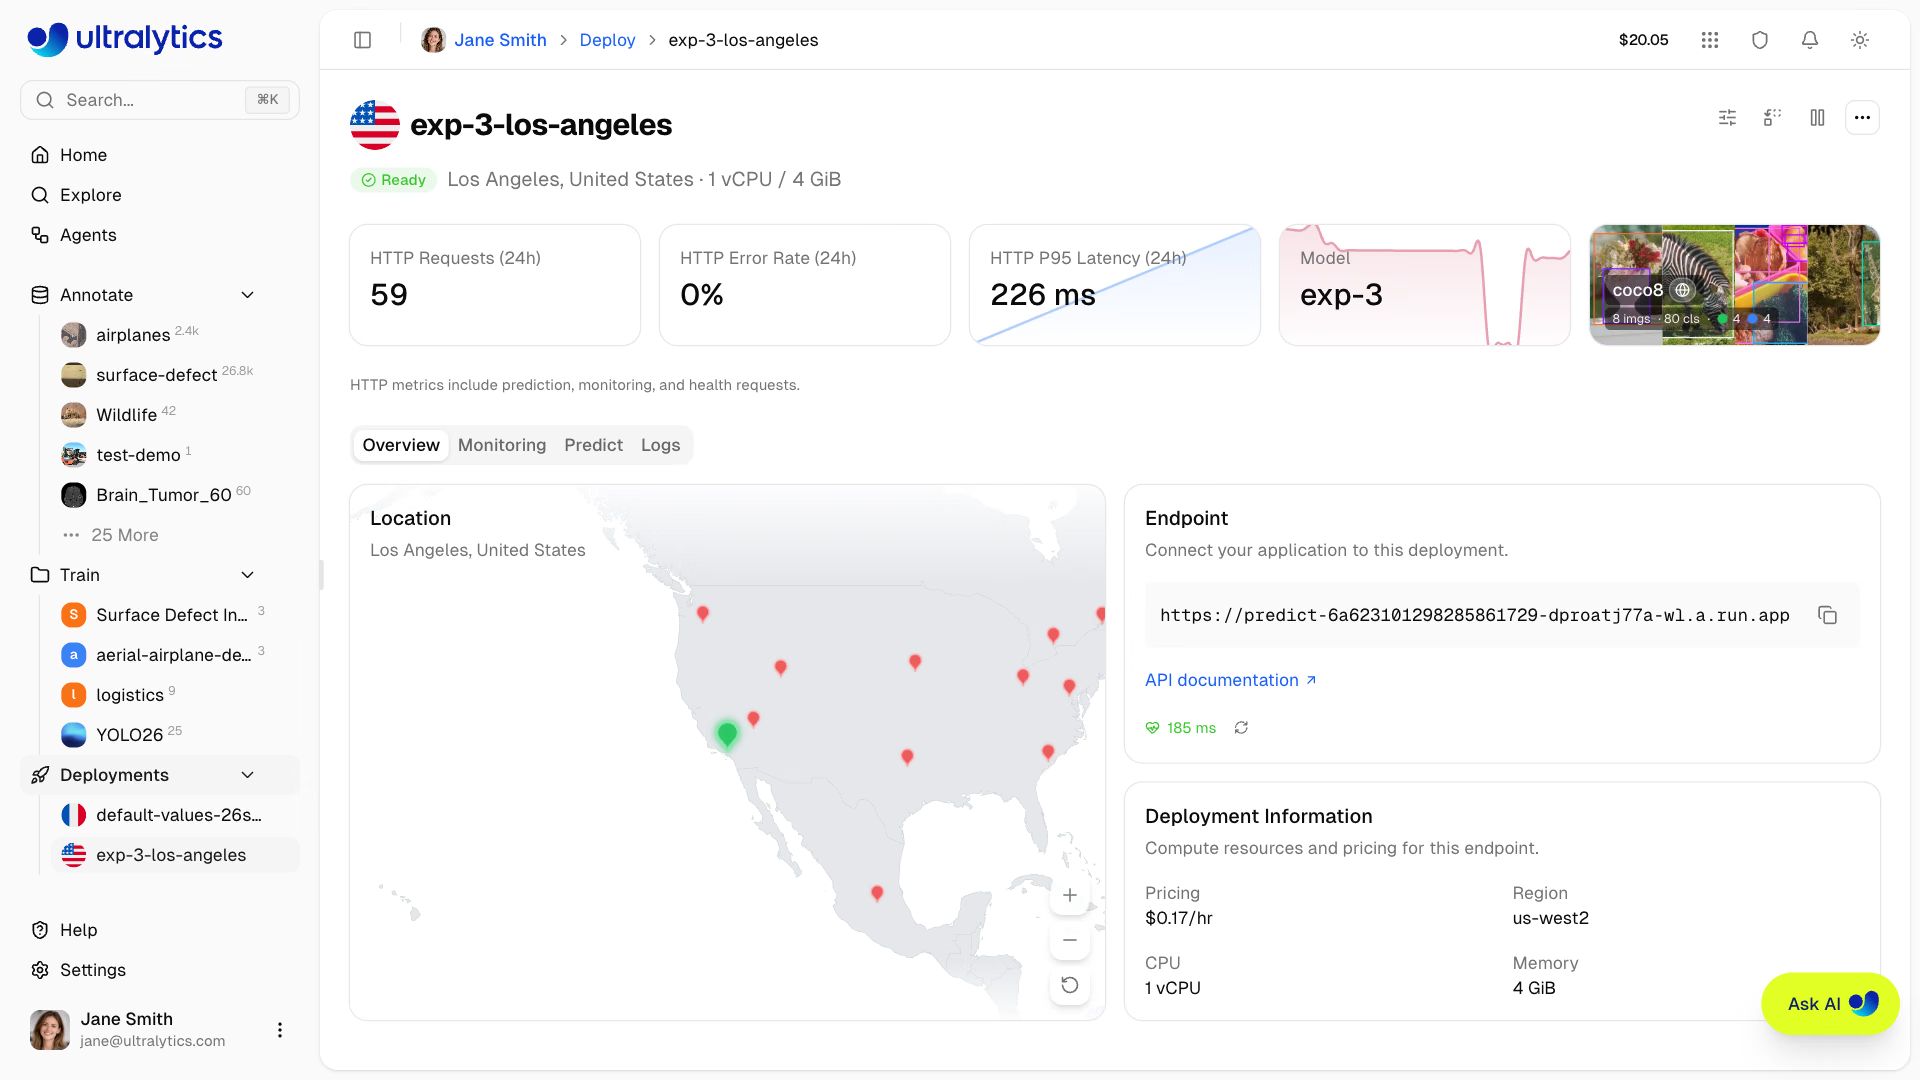
각 엔드포인트에는 https://predict-<id>-<hash>-<region>.a.run.app과 같은 URL이 있으며, /predict(POST), /health, 대화형 /docs 페이지를 제공합니다. 생성 시 연결된 API 키만 허용됩니다. 워크스페이스 소유자는 배포의 Predict 탭에 있는 Docs에서 해당 키가 미리 입력된 상태로 표시되는 것을 확인할 수 있으며, Python, JavaScript, cURL 코드 조각도 함께 제공됩니다. 코드 조각은 요청을 한 번 보내는 예제입니다. 프로덕션 코드는 콜드 스타트와 인스턴스 과부하에도 안정적으로 대응해야 합니다:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")429에 한 번 응답한 뒤 엔드포인트 응답 형식에 따라 bus.jpg에 대한 실제 YOLO26n 결과를 반환하는 로컬 스텁을 사용해 테스트했습니다:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
중요한 결정 사항을 한 줄씩 살펴보겠습니다:
timeout=90은 최대 약 1분까지 걸릴 수 있는 콜드 스타트에 대비합니다. 대부분의 HTTP 클라이언트의 기본 시간 제한은 이보다 훨씬 짧습니다.- 429 및 5xx 오류는 재시도하며, 엔드포인트가
Retry-After을 전송하면 이를 준수합니다. 각 엔드포인트는 단일 인스턴스에서 요청을 처리하며, 과부하 시429을 사용해 부하를 줄입니다. - 그 외 4xx 오류는 즉시 실패 처리합니다:
401은 잘못된 키를 의미하고413은 32 MB를 초과하는 본문을 의미합니다. 어느 쪽도 저절로 해결되지 않습니다. - 응답에는
images에 이미지(또는 비디오 프레임)당 항목 하나가 포함되며, 각 항목에는results(class,name,confidence,box및x1,y1,x2,y2)과 밀리초 단위의speed이 포함됩니다.
선택적 폼 필드는 conf(기본값 0.25), iou(0.7), imgsz(모델의 학습 크기), 비디오용 vid_stride, 0–1 좌표용 normalize=true입니다. 이에 해당하는 cURL 명령은 필드마다 한 줄씩 작성합니다:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
URL을 변경하지 않고 새 버전 배포하기#
배포 페이지의 Replace model을 사용하면 같은 워크스페이스에 있는 다른 완료된 모델로 교체할 수 있습니다. 새 모델이 준비될 때까지 기존 모델이 계속 요청을 처리하며, URL, 지역, 키는 그대로 유지됩니다. 롤아웃에 실패하면 이전 모델이 계속 서비스됩니다. 롤백은 이전 모델을 대상으로 같은 작업을 수행하면 되므로 해당 모델을 프로젝트에 보관하세요. Update configuration은 현재 위치에서 크기를 조정하며, Stop은 과금을 일시 중지하고 URL을 유지합니다.
일부 변경에는 새 엔드포인트가 필요합니다. 지역은 고정되어 있으므로 지역을 변경하려면 엔드포인트를 삭제하고 다시 만들어야 하며, 새 URL이 발급됩니다. 사용자 지정 도메인은 지원되지 않으므로 호출자에게 안정적인 브랜드 호스트 이름이 필요하면 자체 게이트웨이를 앞에 두세요. Platform 외부에서 실행하려면 모델을 내보내거나(배포용 내보내기) Triton Inference Server 뒤에서 직접 호스팅하세요.
주의할 점#
증상: 엔드포인트에 출처를 알 수 없는 트래픽이 유입됩니다. 해결 방법: 웹 앱이나 모바일 앱에 키를 넣지 말고 백엔드에서 엔드포인트를 호출하세요. 연결된 키를 삭제하거나 비활성화해도 엔드포인트가 해당 키 문자열을 계속 허용하므로 엔드포인트가 차단되지는 않습니다. 액세스를 취소하려면 배포를 중지하거나 삭제하고, 새 키에 연결된 새 배포를 만드세요.
증상: 아침의 첫 요청은 실패하지만 재시도는 성공합니다. 해결 방법: 기본 크기 엔드포인트는 트래픽이 없으면 인스턴스 수를 0으로 줄입니다. 최소 90초의 타임아웃을 설정하거나, 예상 트래픽이 발생하기 전에 /health 호출로 엔드포인트를 워밍업하거나, 모든 요청을 빠르게 처리해야 한다면 사용자 지정 크기로 전환하세요.
증상: 업로드가 413 오류와 함께 실패합니다. 해결 방법: 전용 엔드포인트는 최대 32 MB의 요청 본문을 허용합니다. 긴 비디오는 짧은 클립으로 나누거나 샘플링한 프레임을 전송하고, 서버 측에서 프레임을 건너뛰려면 vid_stride을 전달하세요.
정답 보기
알약 생산 라인 카메라의 예시 답변: v2-finetune을 europe-west1(독일 공장에서 지연 시간이 가장 짧은 생기슬랭)에 기본 크기로 배포합니다. 한 시간 유휴 상태 후 콜드 요청은 38초로, 90초 시간 제한 내에 처리됩니다. 웜 요청은 0.3초입니다. 교대 근무 중 생산 라인 PLC가 30초마다 프레임을 전송하므로 엔드포인트는 근무 시간 내내 웜 상태를 유지하고 첫 프레임만 콜드 스타트가 발생합니다. 각 교대 근무 시작 2분 전에 라인 컨트롤러에서 /health를 호출하면 콜드 스타트도 방지할 수 있으므로 무료 기본 크기를 유지해 사용자 지정 1 vCPU, 4 GiB 인스턴스보다 월 약 $90를 절약합니다. 모델을 v1-baseline으로 다시 교체하면 같은 URL에서 v1의 결과가 반환됩니다. 작업을 마치려면 다시 v2로 교체합니다.