재학습 루프 자동화
런북, 스크립트 기반 승격 게이트, 롤백이 가능한 자동 릴리스, 주간 검토를 통해 배포 하나를 반복 가능한 루프로 전환합니다.
첫 번째 배포는 프로젝트이지만, 그 이후의 배포는 모두 프로세스입니다. 루프를 스크립트로 자동화한 팀은 홀드아웃 알림이 발생할 때마다 오후 한나절 만에 재학습합니다. 그렇지 않은 팀은 압박을 받는 상황에서 기억에 의존해 프로세스를 다시 구성하다가 성능이 저하된 모델을 배포합니다. 이 문서에서는 필 모델을 미세 조정하고, 게이트를 통과시킨 다음 릴리스하는 전체 루프를 처음부터 끝까지 실행하고, 다음에는 이를 일상적으로 수행할 수 있도록 런북을 작성합니다.
실습형
모든 단계에 담당자가 있는 반복 주기#
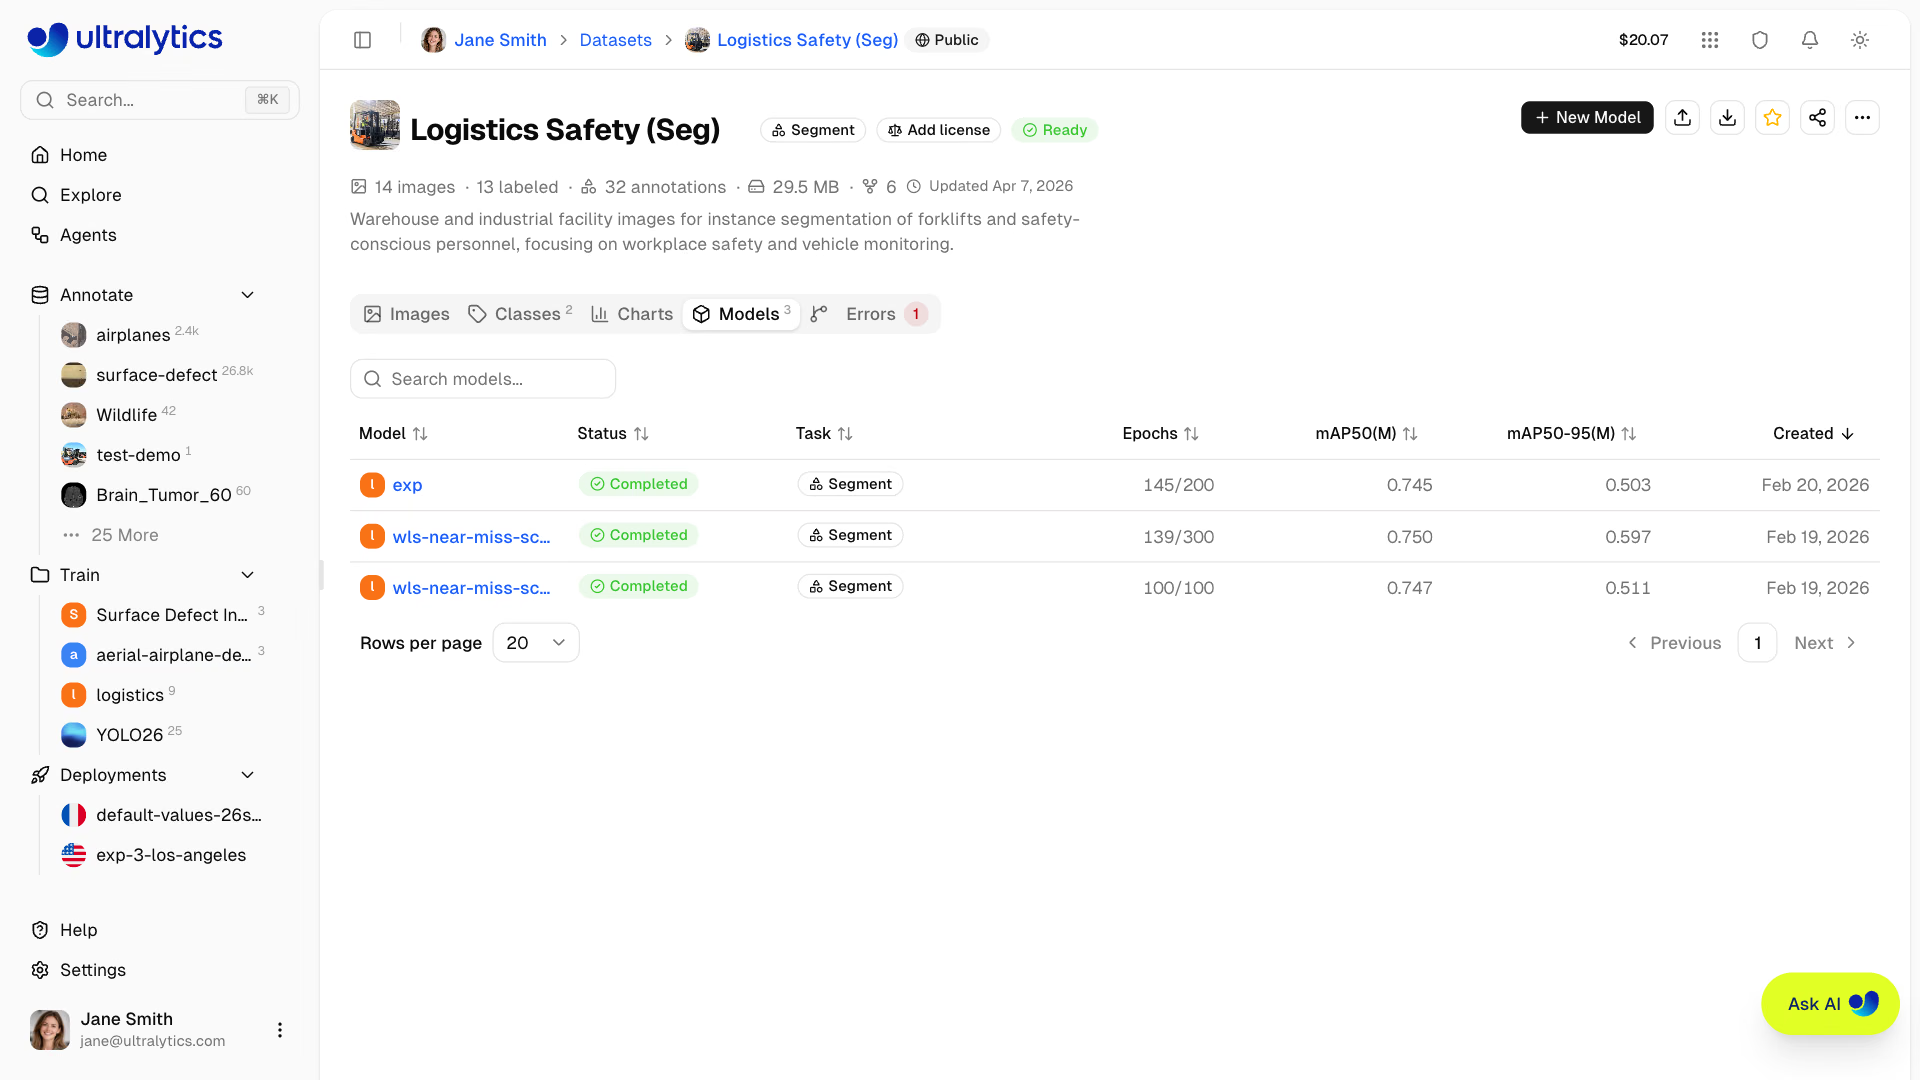
앞선 강의를 따라왔다면 계보 정보는 자동으로 제공됩니다. 모델의 Run Information 카드에는 상위 모델과 고정된 데이터셋 버전이 표시되고, 데이터셋의 Models 탭에는 각 버전으로 학습한 모든 모델이 나열되며, 배포 페이지에는 해당 모델을 제공하는 배포가 연결되어 있습니다. 정확도가 떨어지면 배포에서 시작해 거꾸로 추적합니다.
Agents는 데이터 수집 단계를 자동화합니다. Collect Uncertain Detections는 배포 모델로 추론을 수행하고, 지정된 신뢰도 범위에 해당하는 탐지 결과가 있는 이미지를 검토용 데이터셋에 복사합니다. Capture and Alert는 조건에 맞는 이미지를 저장하고 Slack에 알림을 게시합니다. 워크플로는 Run을 클릭할 때 실행되므로, 주간 검토에 실행 작업을 포함합니다.

작업 예시: Pill 모델의 전체 주기#
1. 배포된 모델에서 파인튜닝합니다. Platform에서 My Models 아래의 배포된 모델을 선택하고, Save Dataset Version을 활성화한 다음 옵티마이저를 명시적으로 설정합니다. 로컬에서는 다음과 같이 같은 단계를 수행합니다.
from ultralytics import YOLO

model = YOLO("pills-v1.pt")  # 배포된 모델의 best.pt
model.train(data="medical-pills.yaml", epochs=5, imgsz=320, optimizer="SGD", lr0=0.001, name="v2-finetune")
Train, Read, and Fine-Tune Runs에서 수행한 파인튜닝입니다. mAP50-95가 0.659에서 0.687로 향상되었습니다.
2. 배포된 모델을 기준으로 후보 모델을 검증합니다. 6강의 gate.py을 홀드아웃 데이터와 두 체크포인트에 적용합니다.
DATA = "medical-pills.yaml"  # 홀드아웃 데이터셋 YAML 또는 ul:// URI
BASELINE, CANDIDATE = "pills-v1.pt", "pills-v2.pt"  # 배포된 모델과 재학습한 후보 모델 비교
PASS mAP50-95 0.659 -> 0.687 beats noise
PASS every class keeps 90% of its AP (weak: none)
PASS inference 4.0 ms within 100 ms
verdict: ship the candidate검증 단계가 종료 코드 0을 반환하므로 CI에서 릴리스 단계로 계속 진행할 수 있습니다. (이 데모에서는 medical-pills 검증 분할을 홀드아웃 데이터로 사용합니다. 실제 운영에서는 모델이 본 적 없는 홀드아웃 버전을 사용합니다.)
3. 릴리스합니다. 후보 모델을 같은 작업 공간에 업로드하거나 학습한 다음, CI에서 ultralytics-platform SDK를 통해 Replace model을 호출하도록 하고 현재 제공 중인 모델을 확인합니다.
import time

from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "pill-detector-st-ghislain"
PROJECT, NEW_MODEL = "pill-inspection", "v2-finetune"

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    body = {"action": "replace", "project": PROJECT, "model": NEW_MODEL}
    reply = client.deployments.update(OWNER, DEPLOYMENT, body=body)
    print(reply["status"], "-", reply["message"])  # "deploying" while the new model starts
    while (deployment := client.deployments.retrieve(OWNER, DEPLOYMENT)["deployment"])["status"] == "deploying":
        time.sleep(15)
    print(f"status={deployment['status']} model={deployment.get('model')}")
    if deployment.get("model") != NEW_MODEL:  # a failed rollout leaves the previous model serving
raise SystemExit("Replacement failed; the previous model is still live")deploying을 한 번 반환한 뒤 ready을 반환하는 스텁 API를 대상으로 실행하면 다음과 같이 출력됩니다.
deploying - Replacement model is deploying
status=ready model=v2-finetunedeployments.update은 action: "replace"와 함께 PATCH /api/deployments/{owner}/{deployment}을 전송합니다. 새 모델이 준비될 때까지 이전 모델이 서비스를 제공합니다. 루프는 상태가 deploying에서 벗어날 때까지 retrieve을 폴링한 뒤, 제공 중인 모델을 확인합니다. 실패한 롤아웃도 이전 모델을 유지한 채 ready로 종료되기 때문입니다. 롤백하려면 NEW_MODEL을 이전 버전으로 설정해 같은 스크립트를 실행합니다. ultralytics과 함께 제공되는 ul cloud 명령줄 도구는 동일한 API를 래핑하며, API 참조에서 모든 호출을 확인할 수 있습니다.
4. 기준선을 재설정합니다. 새 체크포인트와 새 기록 파일을 사용해 8강의 holdout_check.py을 실행합니다.
런북 작성#
# Retraining runbook: pill-detector

## Trigger
- Holdout mAP50-95 more than 1 point below baseline for 2 consecutive weeks, OR
- Batch Annotation edit rate above 25% on a new batch.

## Steps
1. Collect: Save to dataset from Monitoring, plus the "Collect Uncertain Detections" agent into pill-review.
2. Label: Batch Annotation with the deployed model at the swept threshold; review every image; record the edit rate.
3. Merge into the training dataset; rerun the duplicate check, class audit, and Clustering.
4. Create dataset version v(n+1) with a description of what changed.
5. Fine-tune from the deployed model with Save Dataset Version on; optimizer SGD, lr0 0.001.
6. Run gate.py against the deployed model on the holdout. Stop here on any FAIL.
7. ML lead approves; CI runs release.py.
8. Watch endpoint_check.py for 24 hours; start a new holdout baseline.

## Rollback
- Run release.py with NEW_MODEL set to the previous version. Never delete that model while it's the rollback target.

## Owner
- ML lead approves step 7. On-call runs steps 1-6 and 8.
매주 15분 검토 시간을 캘린더에 등록하고 다음 두 가지를 확인합니다. 빨간색으로 표시된 항목(엔드포인트 검사, 홀드아웃, 편집률)이 있는가? 배포에 변경 사항이 있었는가? 있었다면 이유는 무엇인가? 대부분의 주에는 두 질문 모두 답이 아니며, 회의는 5분이면 끝납니다. 일반적인 분기는 다음과 같습니다.
   Week 1   : Holdout alert. Collect, label, retrain, gate, release v(n+1).
   Week 2-3 : Quiet. Checks green.
   Week 4   : New defect class requested. Label, new version, retrain v(n+2).
   Week 5-7 : Quiet.
   Week 8   : Second plant in Poland. Check regions; add an endpoint in europe-central2.
   Week 9-11: Quiet.
   Week 12  : Quarterly holdout refresh and review.
주의할 점#
증상: 릴리스에 문제가 생겼는데 이전 모델이 사라졌습니다. 해결 방법: 프로젝트에 프로덕션 모델을 최소 두 개는 유지하세요. 모델을 삭제하면 휴지통으로 이동하며, 모델을 영구 삭제하면 해당 모델을 계속 서빙하는 배포도 함께 제거됩니다.
증상: 10%/50%/100% 카나리 배포를 계획했지만 모델 교체 시 모든 트래픽이 한 번에 전환됩니다. 해결 방법: 엔드포인트는 모델 하나만 서빙합니다. 카나리 배포를 하려면 후보 모델을 두 번째 엔드포인트에 배포하고 자체 라우터에서 트래픽을 분할한 다음, 모델을 교체하고 두 번째 엔드포인트를 삭제하세요.
증상: 모든 후보가 게이트를 통과하는데도 프로덕션 성능이 저하됩니다. 해결 방법: 어떤 실행에서도 학습에 사용하지 않은 홀드아웃 버전에서만 게이트가 올바르게 작동합니다. 홀드아웃은 별도의 비공개 데이터셋에 보관하고 학습 데이터와 절대 병합하지 마세요.
정답 보기
Pill 생산 라인의 전체 주기 사례입니다. 트리거: 야간 근무 홀드아웃 검사 점수가 0.05 하락했습니다. 수집: 저녁 근무 시간대 Monitoring 예시 180개를 pill-review에 저장하고, Collect Uncertain Detections 에이전트에서 120개를 추가했습니다. 배포된 v2-finetune을 사용한 Batch Annotation의 임계값은 0.35, 편집률은 18%였습니다. 검토 및 병합을 완료하고 감사 결과가 정상이었으며 버전은 v6: +300 night-shift frames입니다. v2-finetune에서 v3-night을 SGD, lr0 0.001, 20 에포크로 파인튜닝합니다. 야간 이미지 100개를 포함한 이미지 300개의 홀드아웃으로 게이트를 확인한 결과, mAP50-95가 0.66에서 0.71로 향상되고 취약한 클래스가 없었으며 4ms가 소요되어 통과했습니다. release.py와 NEW_MODEL = "v3-night"은 status=ready model=v3-night을 보고하고, holdout_check.py은 0.71의 새 기준선을 기록합니다. v2-finetune는 롤백 대상으로 프로젝트에 유지되며, 런북과 게이트 및 릴리스 스크립트는 함께 커밋됩니다.