스마트 어노테이션 및 배치 레이블링
검수 작업량을 측정하여 레이블링 모델과 신뢰도 임계값을 선택한 다음, 배치 어노테이션을 실행하고 편집률로 결과를 검증합니다.
박스를 직접 그리면 시간당 약 100장의 이미지를 처리할 수 있지만, 품질이 좋은 사전 레이블을 검토하는 작업은 몇 배 더 빠를 수 있습니다. 하지만 신뢰도 임계값이 적절하지 않으면 레이블링 모델이 절약하는 것보다 더 많은 작업을 만들 수 있으며, 검토하지 않은 결과는 다음 모델이 자체 오류를 학습하게 만듭니다. 이 강의에서는 실제 레이블 데이터에서 임계값별 검수 작업량을 측정하므로, 추측이 아니라 수치를 바탕으로 임계값을 선택할 수 있습니다.
실습형
사전 레이블 지정 방법 세 가지#
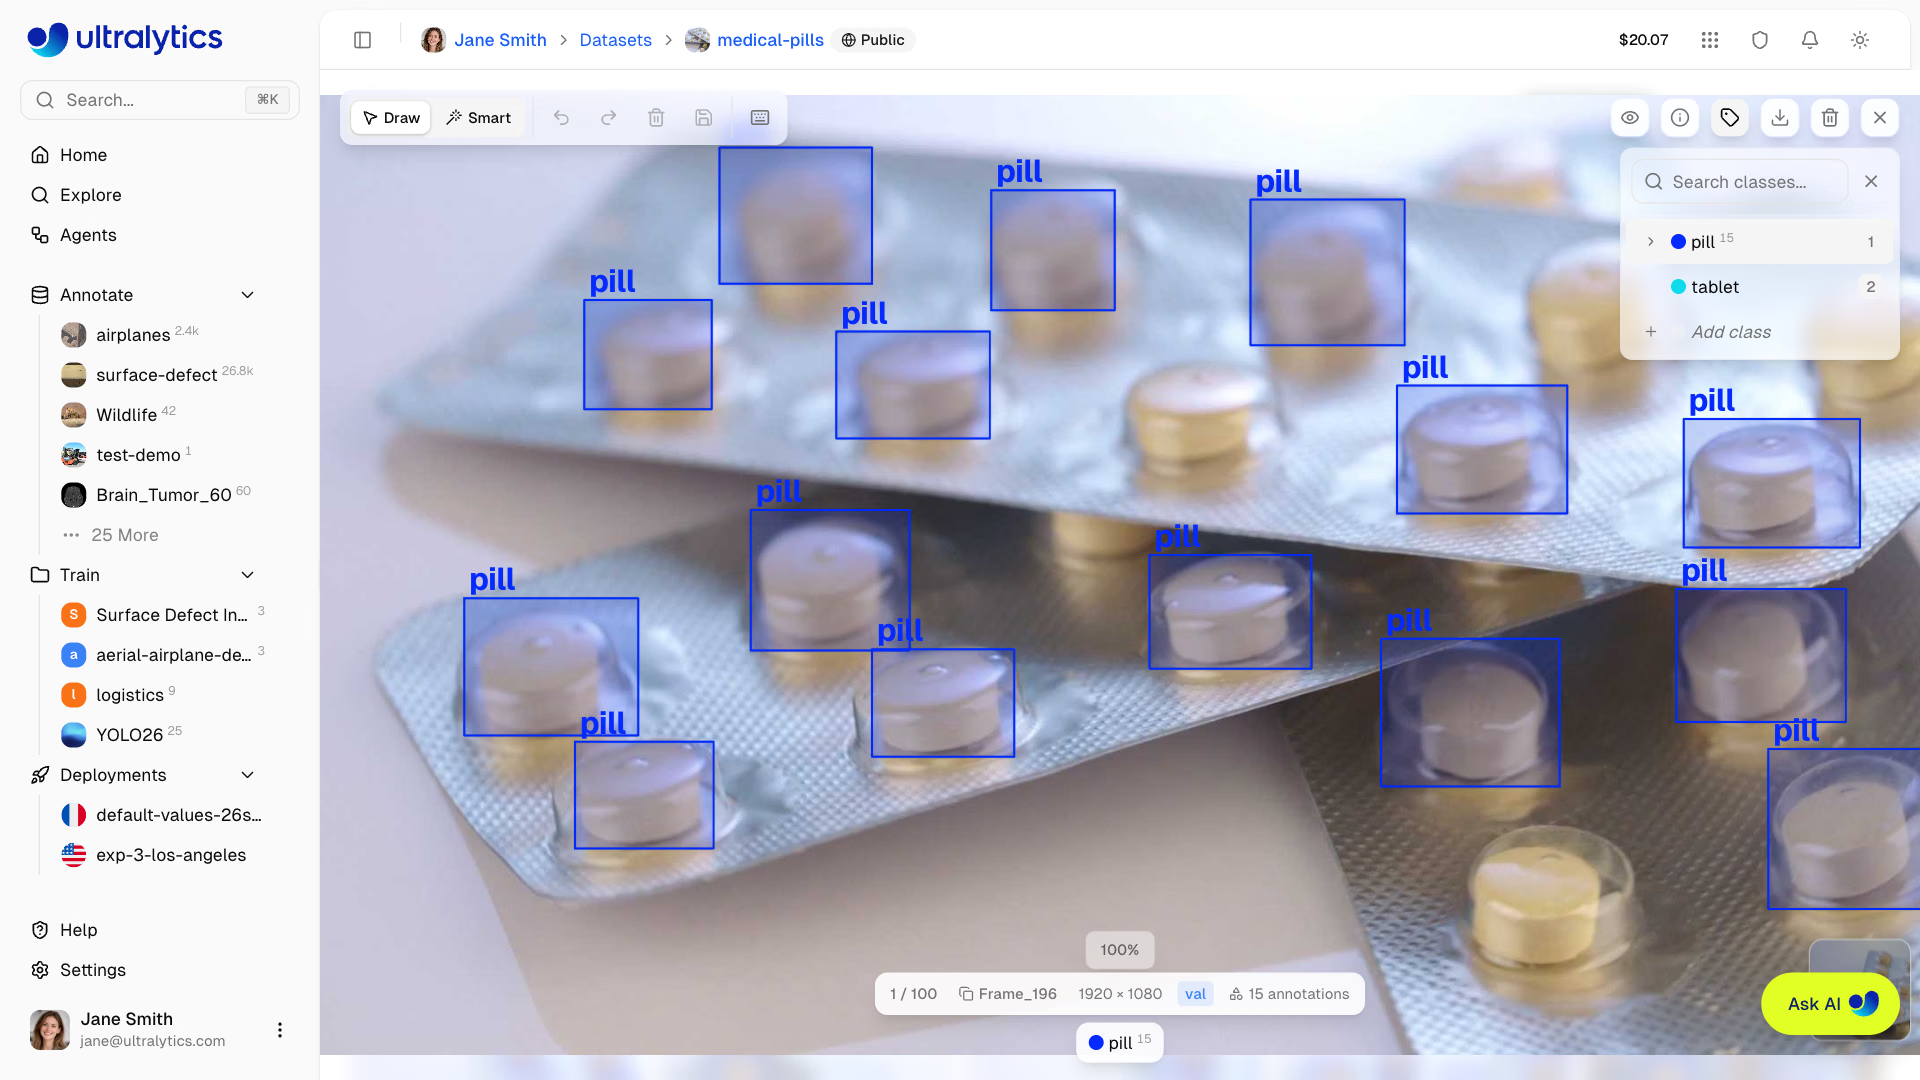
어노테이션 편집기에서 Draw 모드(V)는 수동 작업이며, Smart 모드(S)에서는 모델이 레이블을 제안합니다.
| 계열 | 작동 방식 | 작업 | 비용 |
|---|---|---|---|
| SAM (SAM 2.1 Tiny~Large, SAM 3, 기본값은 SAM 3.1) | 객체를 클릭하면 마스크를 생성하고, 바깥을 클릭하면 영역을 추가하며, 안쪽을 클릭하면 영역을 뺍니다. A은 자동 적용을 전환합니다. | 탐지, 세그멘테이션, 시맨틱, OBB | 무료 |
| YOLO(공식 모델 또는 자체 모델) | Predict은 모델의 탐지 결과를 추가합니다. 클래스 매핑은 모델 클래스와 데이터셋 클래스를 정렬하며, IoU 0.7 이상의 중복 결과는 건너뜁니다. | 탐지, 세그멘테이션, 시맨틱, OBB, 포즈 | 편집기에서 무료 |
| 클래스 프롬프트 지정(기본값은 Moondream 3.1, YOLOE-26x, SAM 3 Text 등) | 이미지에서 데이터셋의 클래스 이름을 찾습니다. 유료 제공업체 모델은 자체 API 키로 실행합니다. | 클래스가 1~200개인 탐지 데이터셋 | 호스팅 모델은 무료 |
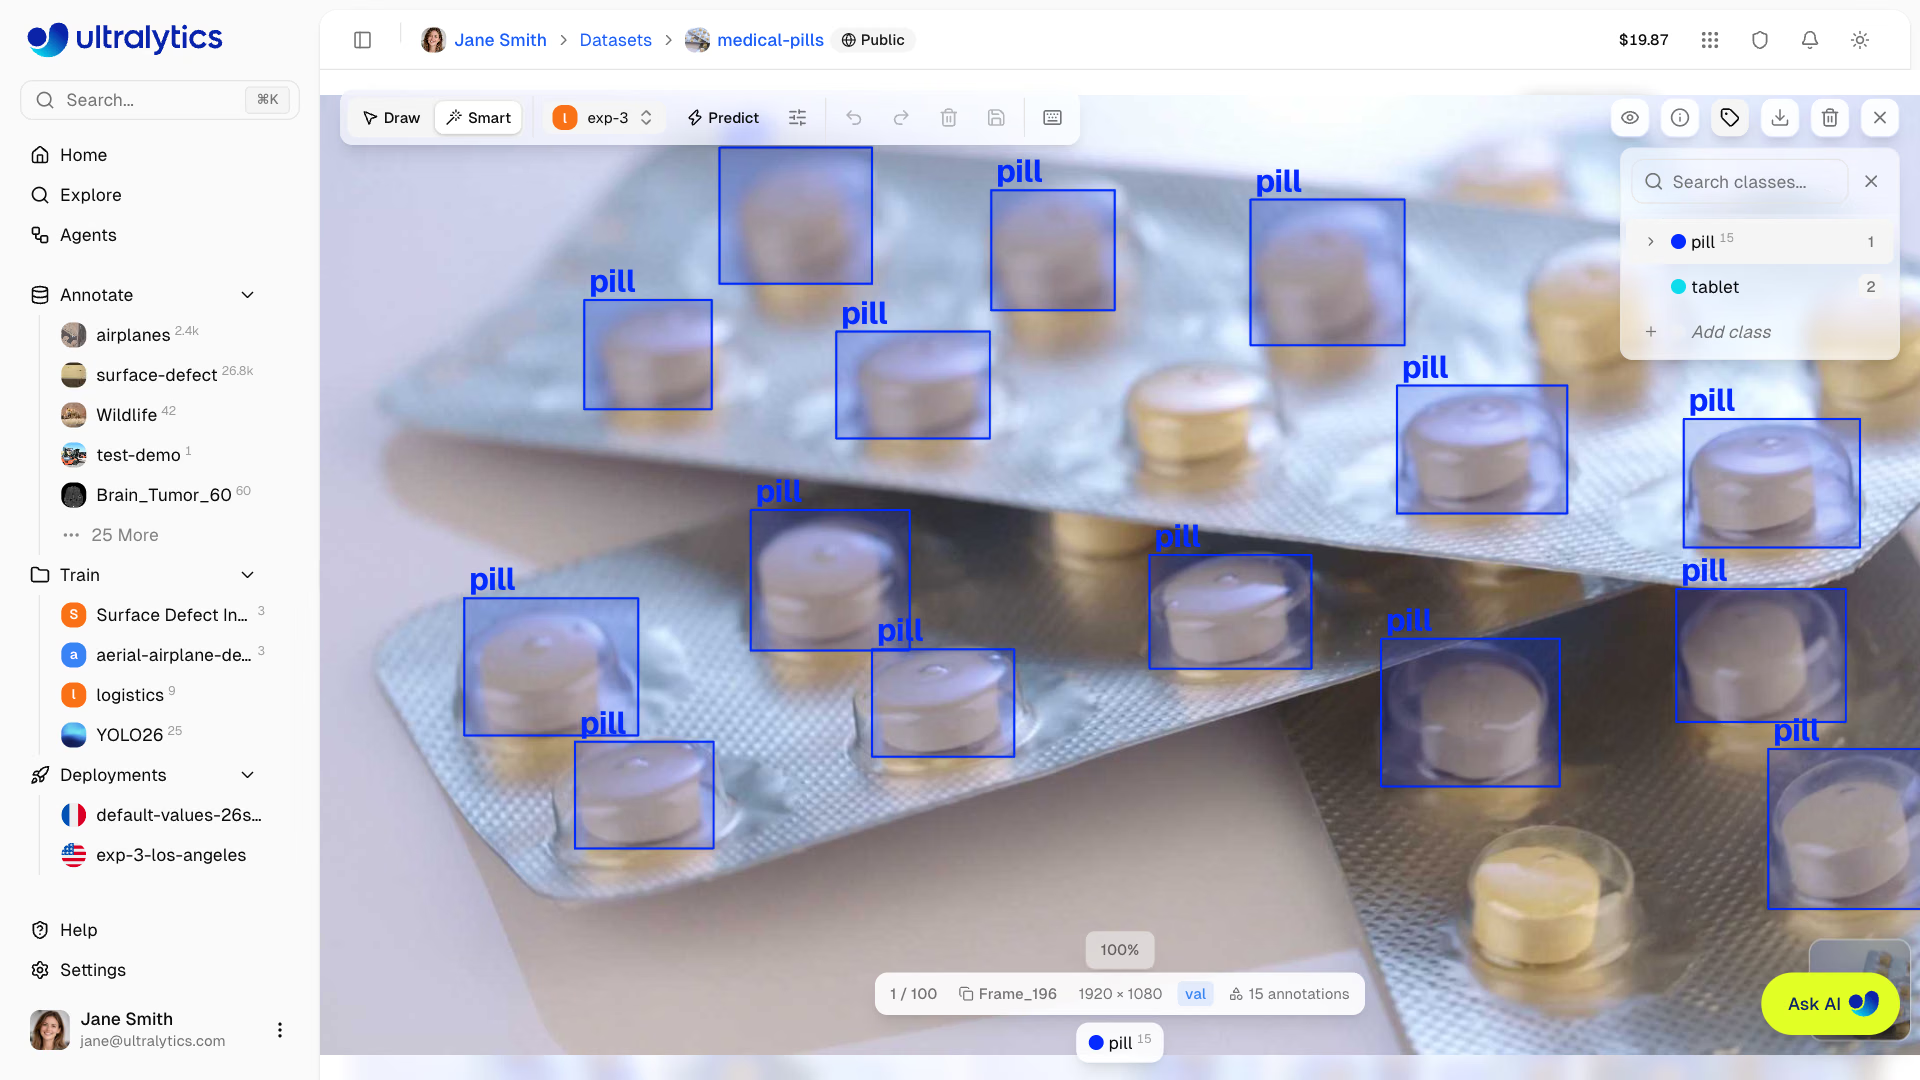
SAM은 객체당 한 번 클릭하면 되며 가장 정밀한 도형을 제공합니다. 모델 예측은 이미지당 한 번 클릭하면 되지만 모델의 성능에 따라 결과가 달라집니다. 따라서 이 강의의 나머지 부분에서는 모델을 선택하고 조정하는 방법을 다룹니다.
레이블링 모델 선택하기#
수작업 레이블 100~200개로 학습한 성능이 낮은 v0도 처음부터 직접 그리는 것보다는 낫고, v1에서는 대개 유용한 능동 학습 파트너가 됩니다. 클래스 프롬프트 모델의 성능은 도메인에 따라 크게 달라집니다. 일상 사진에서 거의 모든 객체를 찾는 모델도 PCB, X-ray 또는 소매 이미지에서는 대부분의 객체를 놓칠 수 있으므로, 모델을 신뢰하기 전에 예측 10개를 확인하세요.
실습 예제: 임계값별 검수 작업량 측정하기#
신뢰도 임계값에 따라 검토자가 어떤 작업에 시간을 쓰는지가 결정됩니다. 너무 낮으면 오탐 박스를 삭제하고, 너무 높으면 모델이 놓친 박스를 그려야 합니다. 이미 정답 레이블이 있는 이미지에서 측정해 보겠습니다. 여기서는 사전 학습된 YOLO26n을 레이블링 모델로 사용해 COCO128의 레이블이 지정된 이미지 128개를 측정합니다.
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5작동 방식과 결과:
- 모델은 낮은
conf=0.05에서 한 번 예측합니다. 각 임계값은 동일한 예측 결과를 필터링하므로 빠르게 테스트할 수 있습니다. review_work은 각 예측을 IoU 0.5 이상인 동일 클래스의 정답 박스와 연결합니다. 연결되지 않은 예측은 검토자가 삭제할 박스이고, 연결되지 않은 정답은 검토자가 그릴 객체입니다.- 이미지당 편집 횟수는 0.25~0.4에서 최저치인 4.7에 도달합니다. 이보다 낮으면 삭제가 급증하고, 높으면 누락이 급증합니다.
- 최적의 임계값에서도 검토자는 이미지당 약 3.6개의 박스를 그립니다. COCO의 긴 꼬리에 포함된 작은 객체는 나노 모델이 탐지하기 어렵기 때문입니다.
결정 규칙: 이미지당 편집 횟수가 가장 적은 임계값을 선택하세요. 모든 임계값에서 그리기가 더 많다면 레이블링 모델이 데이터에 비해 성능이 너무 낮으므로 더 큰 모델이나 파인 튜닝 모델을 사용하세요. 0.5에서도 삭제가 더 많다면 모델이 서로 비슷한 클래스를 혼동하는 것이므로 더 많은 레이블을 지정하기 전에 혼동 행렬을 확인하세요. 자체 프로젝트에서는 이미 레이블을 지정한 이미지 50~100개에 파인 튜닝 모델을 사용해 임계값 테스트를 실행하세요.
배치 어노테이션 실행하기#
배치 어노테이션은 전체 데이터셋에 YOLO 또는 클래스 프롬프트 모델 하나를 실행합니다. 더 많은 작업 > 배치 어노테이션에서 열거나, 편집기에서 예측을 실행한 뒤 표시되는 알림에서 모두 어노테이션을 선택하세요.
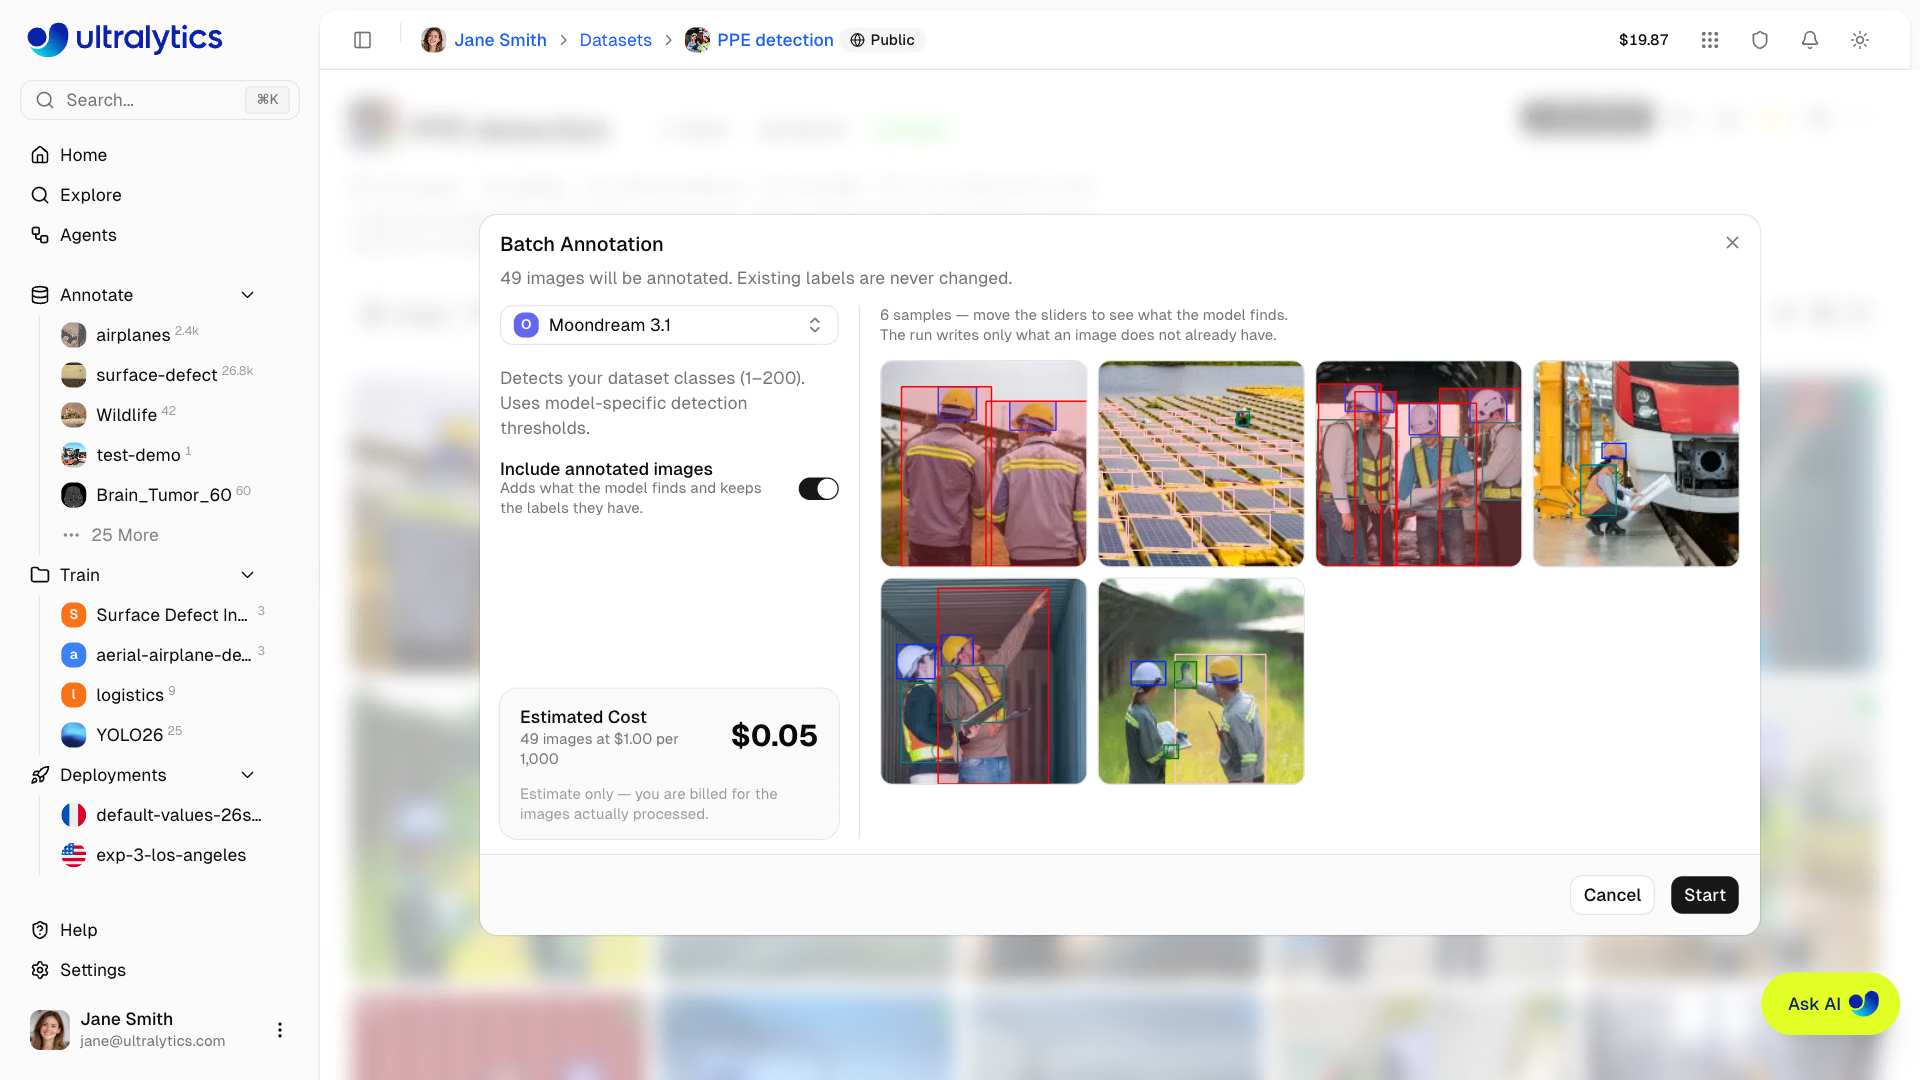
- 모델을 선택하세요. 탐지 데이터셋에서는 Moondream 3.1이 기본으로 선택되어 열립니다. 파인 튜닝 모델 또는 YOLO 모델로 전환하세요.
- YOLO 모델을 사용하는 경우 신뢰도를 임계값 테스트에서 선택한 값(기본값은
0.25)으로, IoU를0.7로 설정하고 샘플 미리 보기를 확인하세요. - 레이블이 지정되지 않은 이미지에만 레이블을 지정하려면 어노테이션된 이미지 포함을 끄세요.
- 예상 비용(이미지 1,000개당 $1.00, 최소 $0.01)을 확인하고 시작을 클릭하세요.
실행을 시작하면 먼저 데이터셋 버전이 저장되므로 실행 전 상태를 복원할 수 있습니다. 중지를 선택하면 지금까지 처리된 이미지가 유지되고 해당 비용이 청구됩니다.
검토한 다음 편집률 측정하기#
예측 결과는 일반 어노테이션으로 저장되므로 검토되지 않았다는 표시가 없습니다. 클래스로 필터링해 희귀 클래스부터 확인하고, 어노테이션을 오름차순(누락 가능성이 높은 이미지), 내림차순(박스가 합쳐질 수 있는 복잡한 장면)으로 정렬하세요. 그런 다음 버전을 만들고 버전 탭에서 버전 비교를 연 다음, 시작 버전으로 v_auto을 선택하세요.
| 개수 | 의미 |
|---|---|
| 추가됨 | 모델이 놓친 객체와 수정된 각 박스의 수정본 |
| 제거됨 | 오탐과 수정된 각 박스의 원본 |
| 편집률 | (추가됨 + 제거됨) ÷ v_auto의 어노테이션 수. 수정된 박스가 두 번 계산되므로 상한값입니다. |
배치별 편집률을 추적하세요. 편집률이 높아지면 새 이미지가 레이블링 모델이 학습한 데이터와 달라지기 시작했다는 조기 경고입니다. 어노테이션 모범 사례 강의에서는 레이블링 가이드와 검토자 간 일치도를 다룹니다.
주의할 점#
증상: 재학습할 때마다 점수가 비슷하고 같은 객체가 계속 누락됩니다. 해결 방법: 검토하지 않은 사전 레이블은 레이블링 모델의 체계적인 오류를 정답으로 데이터셋에 반영합니다. 예를 들어 혼동하기 쉬운 클래스, 일관되게 느슨한 박스 경계, 모델이 전혀 탐지하지 못하는 객체가 이에 해당합니다. 학습 버전에 포함하기 전에 모든 이미지를 검토합니다.
증상: Batch Annotation이 완료됐지만 대부분의 객체에 여전히 레이블이 없습니다. 해결 방법: 먼저 편집기에서 대표 이미지 10장으로 모델을 실행합니다. 객체를 몇 개 이상 놓친다면 시드 세트에 직접 레이블을 지정한 후 v0을 학습합니다.
증상: 예측 박스에 잘못된 클래스 이름이 표시됩니다. 해결 방법: 모델 클래스와 데이터셋 클래스가 다르면 클래스 매핑 단계에서 각 모델 클래스를 데이터셋 클래스에 매핑하거나 건너뜁니다. 신중하게 매핑하세요. 잘못 매핑하면 해당 클래스의 모든 박스에 잘못된 이름이 지정됩니다.
정답 보기
작업 예시: 스윕 결과 알약 검사 파인튜닝에 0.35가 선택됩니다. Batch Annotation으로 1,240개의 어노테이션이 포함된 v4을 저장합니다. 검토 후 Compare versions에서 v4 → v5에 추가 96개와 제거 152개가 표시되므로, 수정률은 (96 + 152) ÷ 1,240 = 20%입니다. 추가보다 제거가 많다는 것은 과다 예측을 의미합니다. 제거된 박스를 살펴보면 모델이 블리스터 팩의 반사를 알약으로 표시하는 것을 확인할 수 있습니다. 다음 두 가지 조치를 취합니다. 다음 배치에서는 신뢰도를 한 단계 높이고(0.35 → 0.45) 수정률이 떨어지는지 확인합니다. 또한 다음 학습 버전에 광택 있는 팩을 검토한 이미지 30개를 추가해 파인튜닝 과정에서 차이를 학습하도록 합니다.