Platform 프로젝트 계획 및 예산 책정
프로젝트의 각 수명 주기 단계를 Platform 또는 자체 스택에 배정하고, 크레딧을 사용하기 전에 월별 비용을 추산합니다.
컴퓨터 비전 프로젝트는 모델 때문에 실패하는 경우가 드뭅니다. 대신 라벨 수정 사항이 학습용 사본에 반영되지 않거나, 체크포인트의 데이터 출처를 추적할 수 없거나, 항상 실행되는 엔드포인트가 매달 $150를 조용히 소진하는 등 단계 간 인계에서 실패합니다. Ultralytics Platform은 이러한 인계 과정을 하나의 작업 공간에서 연결합니다. 이 강의에서는 무엇이든 업로드하기 전에 프로젝트의 어느 단계를 Platform이 관리할지, 비용은 얼마인지 결정합니다.
실습형
루프를 연결하는 Platform#
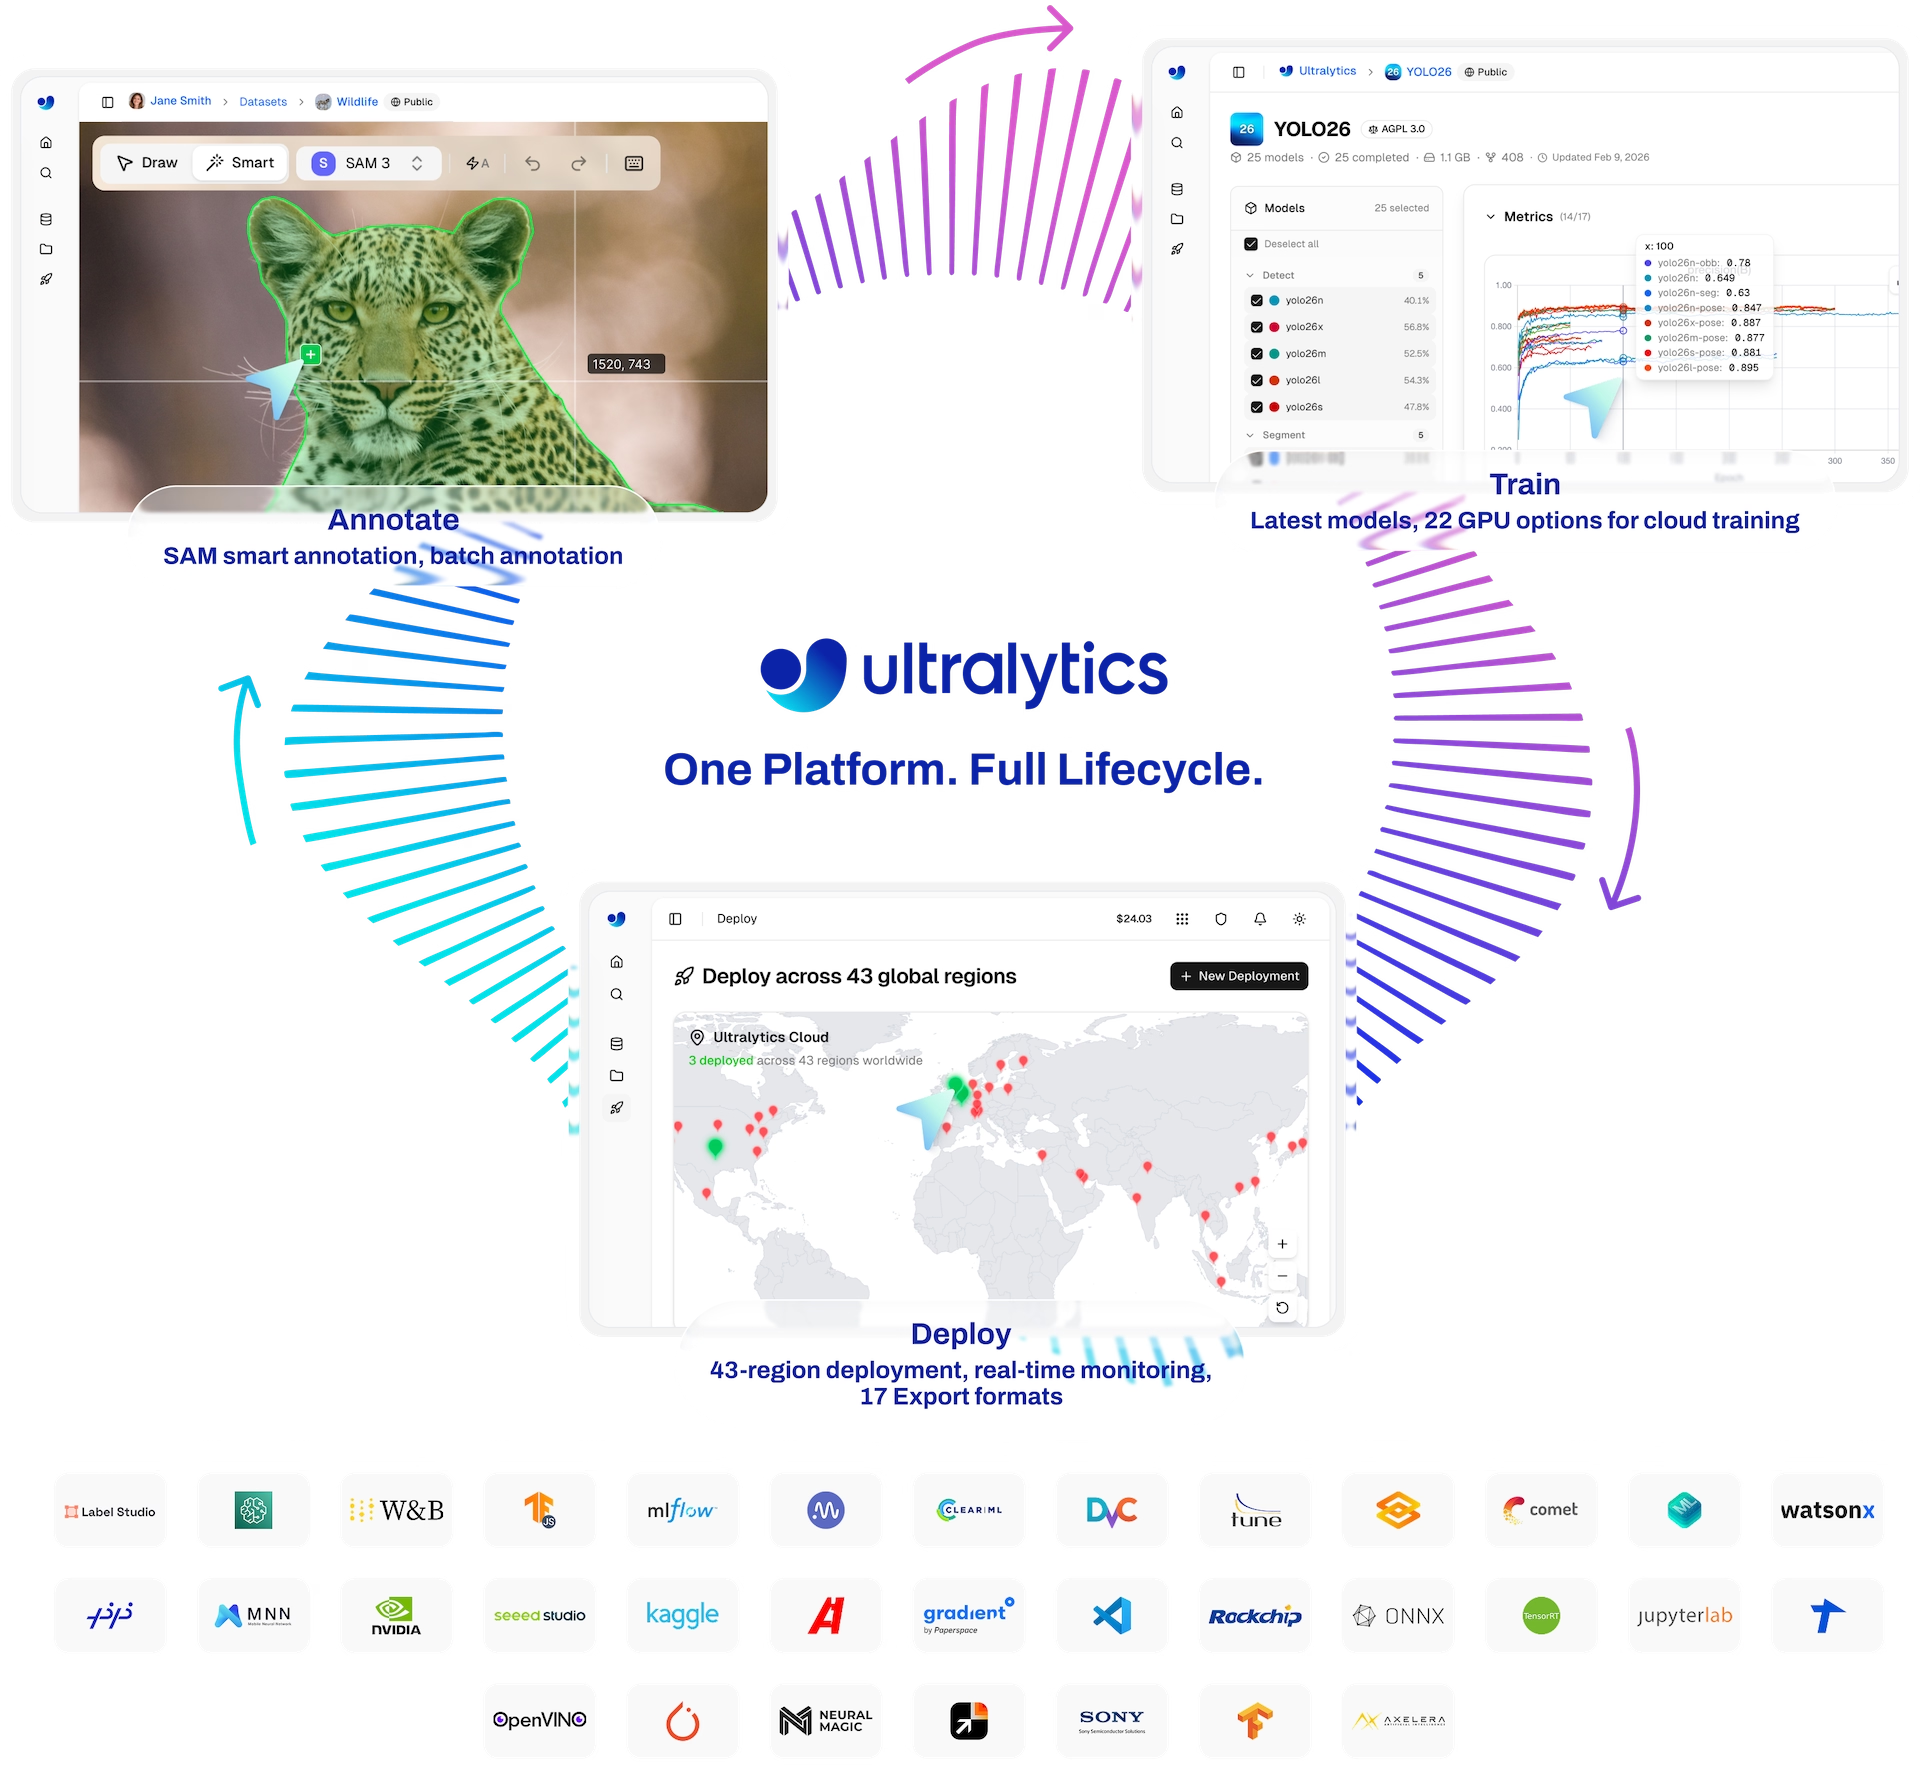
모든 프로덕션 컴퓨터 비전 시스템은 동일한 루프를 따르며, 비용이 많이 드는 부분은 각 상자가 아니라 상자 사이를 잇는 화살표입니다.
Platform의 가치는 각 단계가 다음 단계에 필요한 정보를 기록한다는 점입니다. 이 표를 안내도로 활용하세요. 마지막 열에는 각 단계를 다루는 강의가 나와 있습니다.
| 단계 | Ultralytics Platform에서 수행하는 작업 | 다음 단계로 전달되는 항목 | 강의 |
|---|---|---|---|
| 데이터 | 이미지, 비디오, 아카이브(YOLO, COCO, NDJSON)를 업로드하거나 URL을 가져옵니다. Google Cloud Storage, Amazon S3, Azure Blob Storage에서 직접 읽을 수 있습니다(Pro). 온프레미스(Enterprise). | 태스크 유형과 분할 정보가 포함된 데이터셋 | 2 |
| 주석 달기 | 깊이(쌍으로 된 맵으로 가져오기)를 제외한 모든 YOLO 작업의 수동 도구, SAM, YOLO 및 클래스 프롬프트 기반 스마트 주석, 일괄 주석 | 레이블과 각 일괄 실행 전에 저장된 버전 | 3 |
| 데이터 정리 | 클러스터링, 유사한 이미지 찾기, 클래스 병합, 분할 도구, 번호가 지정된 버전 | 변경할 수 없는 데이터셋 버전 | 4 |
| 학습 | 비용 예상이 제공되는 26가지 클라우드 GPU 유형 또는 프로젝트로 스트리밍되는 로컬 실행 | 데이터셋 버전, 비용, 명령과 연결된 모델 | 5 |
| 비교 | 프로젝트 차트, 차이점이 표시되는 표 보기, 검증 인사이트 | 출시할 가치가 있는 실행 결과 | 6 |
| 배포 | 42개 리전의 전용 엔드포인트, 동일한 URL에서 모델 교체 | 모델과 연결된 엔드포인트 URL | 7 |
| 모니터링 | 요청, 오류, P95 지연 시간 지표, 로그, 예측 통계, 데이터셋에 저장 | 프로덕션 이미지가 데이터셋에 다시 저장됩니다 | 8 |
두 가지 도구로 전체 워크플로를 처리합니다. Agents는 불확실한 탐지 결과를 검토용 데이터셋에 모으는 것과 같은 시각적 워크플로를 구축하고, Ask AI는 직접 실행할 수 있는 동일한 ul cloud 명령을 사용해 대화에서 학습, 비교, 주석 달기, 내보내기, 배포를 수행할 수 있습니다.
직접 관리할 항목 결정하기#
플랫폼이 의도적으로 담당하지 않는 몇 가지 경계가 있습니다. 계획에서 각 항목의 담당자를 지정하세요:
- 독점 시스템에서 프레임 가져오기(DICOM 아카이브, OEM 카메라, 공정 이력 시스템): 자체 코드로 프레임을 버킷이나 업로드 위치에 저장합니다.
- 호출 알림. 플랫폼은 엔드포인트 지표를 표시하고 작업 이벤트를 Slack에 게시하지만, 지연 시간이나 오류 임계값에 대한 알림은 보내지 않습니다. 8강에서 직접 확인 기능을 구축합니다.
- 시간 경과에 따른 정확도. 레이블이 지정된 홀드아웃 데이터와 그 이력은 직접 관리합니다(8강).
- 애플리케이션 로직. 카운팅, 추적, 구역 규칙은 자체 서비스에서 처리합니다. Ultralytics Solutions와 프로덕션 환경의 Ultralytics YOLO 과정에서 이러한 내용을 다룹니다.
- 트래픽 라우팅. 엔드포인트는 생성된 URL을 사용하며 사용자 지정 도메인을 지원하지 않으므로, 카나리 배포, 다중 리전 라우팅, 브랜드 호스트 이름에는 자체 게이트웨이가 필요합니다.
플랫폼은 별도의 프레임워크가 아닙니다. 플랫폼 모델은 일반 best.pt 파일로 다운로드되며, YOLO("best.pt")에서 이를 로드하고 검증한 뒤 내보냅니다. 로컬 model.train(..., project="username/my-project")는 API 키를 설정한 상태로 플랫폼에 스트리밍됩니다. 두 환경 사이를 이동할 때 변환할 필요가 없습니다.
실습 예제: 시작 전에 프로젝트 예산 책정하기#
세 가지 항목에 크레딧이 사용됩니다. 클라우드 학습(GPU 요금 × 사용 시간), 일괄 주석 및 전체 데이터셋 얼굴 흐리게 처리(이미지 1,000장당 $1.00), 사용자 지정 크기 엔드포인트(가동 시간 기준 시간당 과금)입니다. 이 과정의 나머지 모든 기능은 무료입니다. 이 계산기는 소규모 탐지 프로젝트에 대한 플랫폼의 실제 요금을 사용합니다:
# Monthly Platform budget for a small detection project (rates from the billing and deployment docs)
TRAIN_RUNS = 8  # experiments per month
COST_PER_RUN = 0.23  # dialog estimate: ~1,000 images, YOLO26n, 100 epochs, RTX PRO 6000 ($2.09/h)
BATCH_ANNOTATION_IMAGES = 3_000  # $1.00 per 1,000 images
HOURS_PER_MONTH = 730

# Custom endpoint sizes keep one warm instance; us-central1 rates are $0.000024/vCPU-s and $0.0000025/GiB-s
warm_endpoint_hourly = (2 * 0.000024 + 4 * 0.0000025) * 3600  # 2 vCPU, 4 GiB

lines = {
    "cloud training": TRAIN_RUNS * COST_PER_RUN,
    "batch annotation": BATCH_ANNOTATION_IMAGES / 1000 * 1.00,
    "default endpoint (1 vCPU, 2 GiB, scales to zero)": 0.0,
    "warm endpoint (2 vCPU, 4 GiB, always on)": warm_endpoint_hourly * HOURS_PER_MONTH,
}
for item, usd in lines.items():
    print(f"{item:<50} ${usd:>7.2f}")
print(f"{'total with a warm endpoint':<50} ${sum(lines.values()):>7.2f}")
cloud training $ 1.84
batch annotation $ 3.00
default endpoint (1 vCPU, 2 GiB, scales to zero) $ 0.00
warm endpoint (2 vCPU, 4 GiB, always on) $ 152.42
total with a warm endpoint $ 157.26결과 읽는 방법:
COST_PER_RUN값은 학습 대화상자의 예상치이며, 데이터셋 크기, 모델, 에포크 수, 이미지 크기, GPU를 반영합니다. 자체 데이터셋에 대한 예상치로 바꾸세요(5강). H100 SXM에서 이미지 5,000장, YOLO26s, 100에포크를 사용하면 약 $1.56입니다.- 엔드포인트 비용이 대부분을 차지합니다. 소규모 프로젝트의 학습과 레이블링에는 몇 달러가 들지만, 인스턴스를 한 달에 730시간 동안 가동 상태로 유지하면 아이오와에서 약 $150가 듭니다(리전별 요금은 다르며, 배포 대화상자에서 정확한 시간당 가격을 확인할 수 있습니다).
- 결정 원칙: 모든 엔드포인트를 무료 기본 크기로 시작하세요. 사용자가 최대 1분의 콜드 스타트를 허용할 수 없고 트래픽이 안정적이어서 가동 시간 비용을 정당화할 수 있을 때만 사용자 지정 크기로 변경하세요.
요금제#
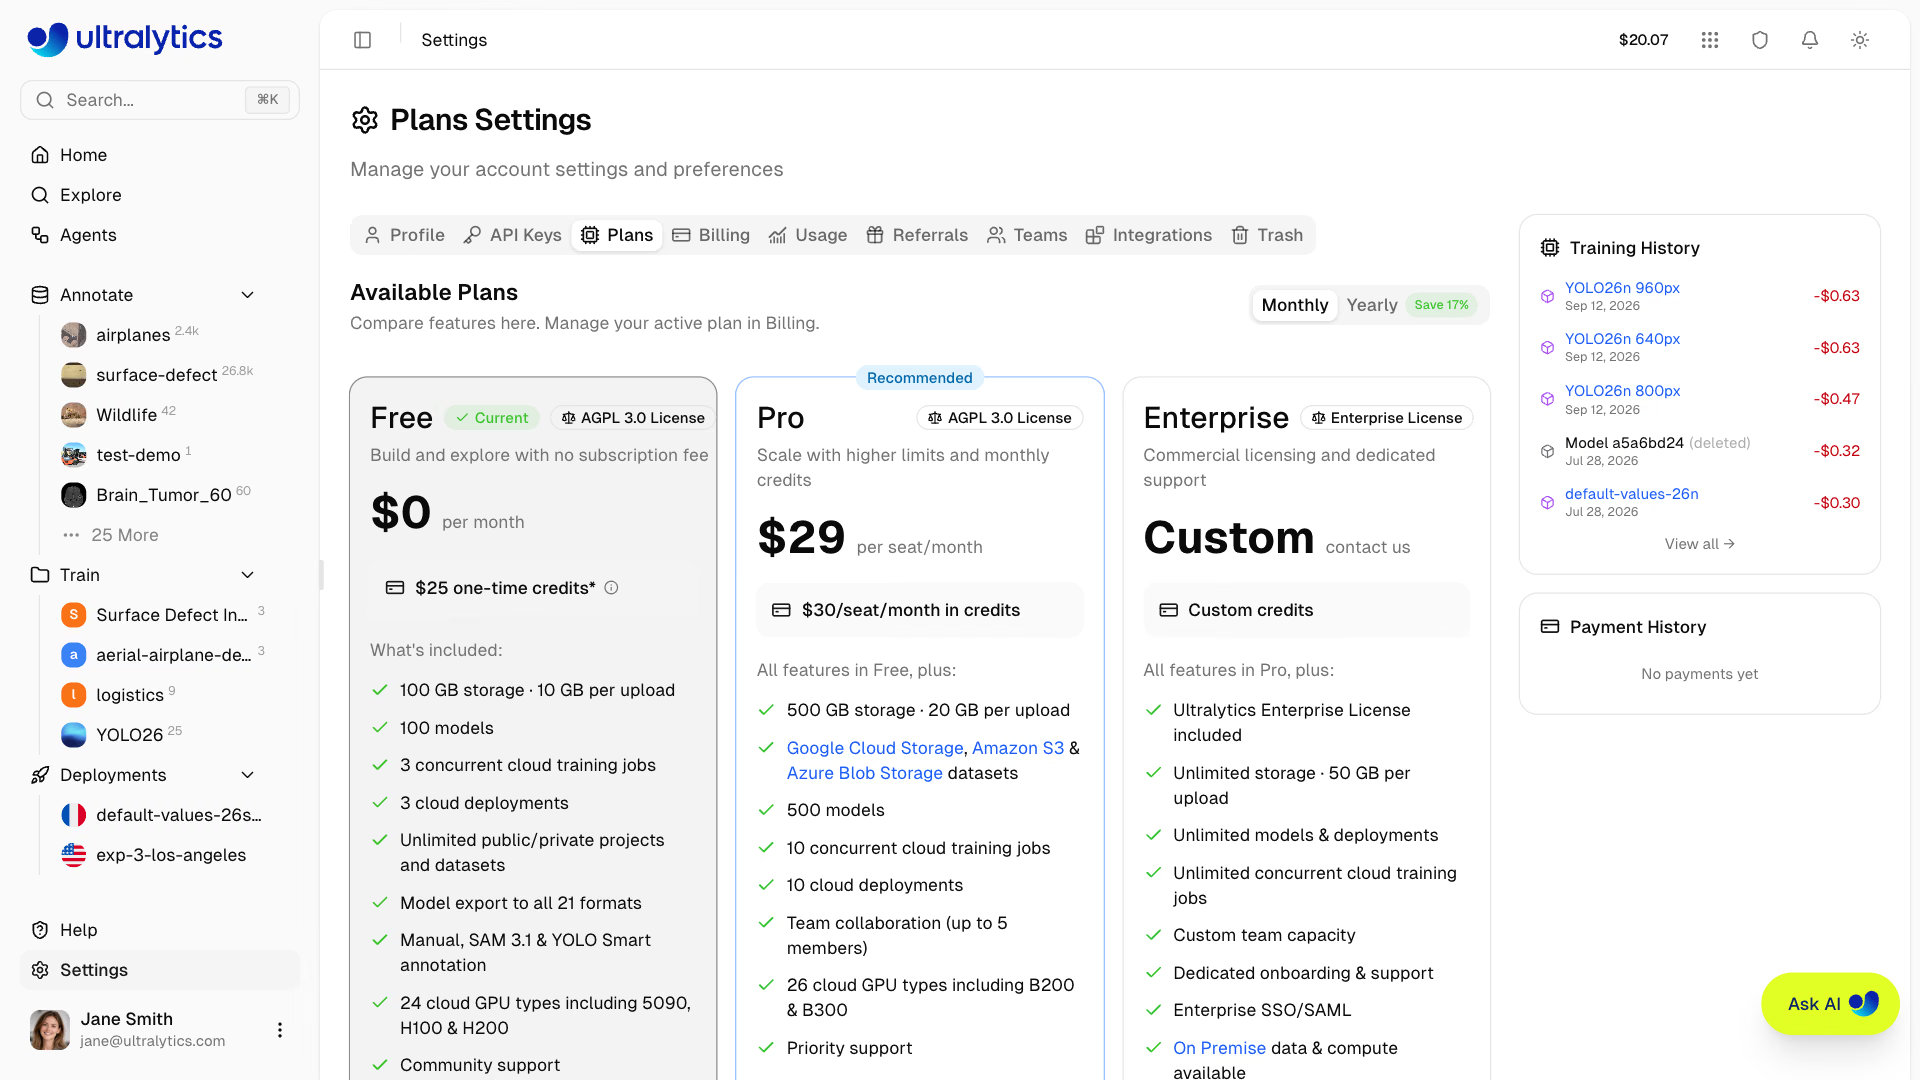
| 무료 | Pro(좌석당 월 $29) | Enterprise | |
|---|---|---|---|
| 크레딧 | 가입 시 $5, 회사 이메일을 인증하면 $25 | 좌석당 월 $30, 이월 불가 | 사용자 지정 |
| 스토리지 / 단일 업로드 | 100 GB / 10 GB | 500 GB / 20 GB | 무제한 / 50 GB |
| 모델 / 동시 학습 | 100 / 3 | 500 / 10 | 무제한 |
| 전용 배포 | 3 | 10 | 무제한 |
| 클라우드 GPU 유형 | 24 | 26개(B200, B300 포함) | 26 |
| 클라우드 스토리지 데이터셋, 팀 | — | 예, 최대 5명 | 예, 사용자 지정 크기 |
| 온프레미스, SSO, Enterprise 라이선스 | — | — | 예 |
결정 원칙: 학습하는 동안에는 무료 요금제를 사용하고, 연결된 클라우드 스토리지, 팀, 엔드포인트 3개 초과 또는 동시 학습 3개 초과가 필요할 때 Pro로 전환하세요. Pro의 월간 크레딧 $30은 위 예산의 학습 및 레이블링 비용을 충당합니다. 결제 문서에서 모든 요금을 확인할 수 있습니다.
주의할 점#
증상: 고객 이미지가 포함된 데이터셋이 Explore에 표시되고 낯선 사람이 이를 복제할 수 있습니다. 해결 방법: Free 및 Pro에서는 새 데이터셋과 프로젝트의 기본 공개 설정이 공개입니다. 매번 새 데이터셋 및 새 프로젝트 대화상자에서 공개 설정 스위치를 전환하세요. 나중에 데이터셋을 비공개로 변경해도 이미 생성된 복제본은 제거되지 않습니다.
증상: EU 고객이 EU 데이터 상주를 요청했지만 워크스페이스는 미국에 데이터를 저장합니다. 해결 방법: 데이터 리전(US, EU 또는 AP)은 온보딩 시 선택하며 지원팀만 변경할 수 있습니다. 가입하기 전에 계약을 확인해 결정합니다(강의 9).
증상: 트래픽이 없어도 하루 약 5달러의 크레딧이 소모됩니다. 해결 방법: 사용자 지정 크기는 유휴 여부와 관계없이 가동 시간에 대해 요금이 청구됩니다. 사용하지 않는 엔드포인트를 중지하거나, 무료로 0까지 축소되는 기본 크기로 되돌립니다.
정답 보기
알약 검사 라인 카메라를 위한 계획 예시입니다. 데이터: 야간 프레임 덤프를 플랫폼에 업로드(담당자: Ana). 주석 달기: 최신 파인튜닝 모델로 일괄 주석을 실행한 뒤 검토(Ana). 데이터 정리, 학습, 비교: 플랫폼(Ravi). 배포: europe-west1의 기본 크기 엔드포인트 하나. 라인 PLC가 30초마다 호출하므로 0으로 축소될 만큼 오랫동안 유휴 상태인 경우가 드뭅니다(Ravi). 모니터링: 플랫폼 대시보드와 cron 상태 확인, 팀 CI에서 주간 홀드아웃 작업(온콜 담당자). 예산: 실행 10회 × $0.23 + 이미지 2,000장 × $0.001 = 무료 엔드포인트 기준 월 약 $4.30이며, Pro의 크레딧 $30으로 충당됩니다. 데이터 리전은 공장이 독일에 있으므로 EU로 설정하고, 모든 데이터셋은 비공개로 설정합니다.