검증 및 진단
best.pt를 기준 모델과 비교해 검증하고, 혼동 행렬, 클래스별 수치, 예측 이미지를 살펴본 뒤 구체적인 수정 목록을 작성하세요.
단일 mAP 값은 모델이 얼마나 잘못 예측하는지는 알려주지만, 무엇을 잘못 예측하는지는 알려주지 않습니다. 작은 객체를 놓치는 문제, 서로 다른 두 클래스를 혼동하는 문제, 박스가 헐겁게 맞는 문제는 모두 mAP를 낮추며 각각 필요한 해결 방법이 다릅니다. 잘못 추측하면 엉뚱한 데이터를 수집하느라 일주일을 허비하게 됩니다.
이 강의에서는 best.pt에서 Val 모드를 실행하고 기준 모델과 비교합니다. 다음 작업의 수정 목록을 작성할 수 있을 때까지 혼동 행렬과 예측 이미지를 살펴봅니다. 성능 지표 가이드는 자세한 내용을 제공하는 참고 자료입니다.
실습형
예제: best.pt 검증하기#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f} mAP50-95 {metrics.box.map:.3f}")val.py의 실제 출력:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
플롯은 새 runs/detect/val 폴더에 저장됩니다(그다음은 val-2 등). 수치를 기준값과 나란히 비교하세요:
| 모델 | mAP50 | mAP50-95 |
|---|---|---|
사전 학습된 yolo26n.pt(pill 클래스 없음) | 0.001 | 0.0002 |
pills_v1(10 에포크, imgsz 320, CPU) | 0.977 | 0.659 |
수치가 보여주는 내용:
- 정밀도 0.970, 재현율 0.957: 균형이 잘 잡혀 있습니다. 오탐도 누락도 적습니다.
- mAP50 0.977: 겹침 기준을 느슨하게 적용하면 모델이 거의 모든 알약을 찾습니다.
- mAP50-95 0.659: 겹침 기준을 엄격하게 적용하면 많은 박스가 정확히 맞지 않습니다. 이처럼 큰 차이는 데이터 누락보다는 위치 추정 문제를 가리킵니다. 더 많은 에포크, 더 큰
imgsz또는 더 정확한 라벨이 필요합니다.
정밀도, 재현율, mAP 간의 상충 관계는 탐지 지표를 올바르게 해석하기를 참조하세요.
질문에 따라 확인할 파일 알아보기#
| 질문 | 파일 |
|---|---|
| 어떤 클래스가 서로 혼동되며, 어떤 클래스가 누락되나요? | confusion_matrix_normalized.png |
| 각 클래스의 정밀도와 재현율은 어떻게 상충하나요? | BoxPR_curve.png |
| 배포 시 어떤 신뢰도 임계값을 사용해야 하나요? | BoxF1_curve.png: 최댓값은 적절한 시작 conf입니다. |
| 실패 사례는 어떤 모습인가요? | val_batch0_labels.jpg 대 val_batch0_pred.jpg |
| 모델이 과적합되고 있나요? | 학습 폴더의 results.png |
혼동 행렬 읽기#
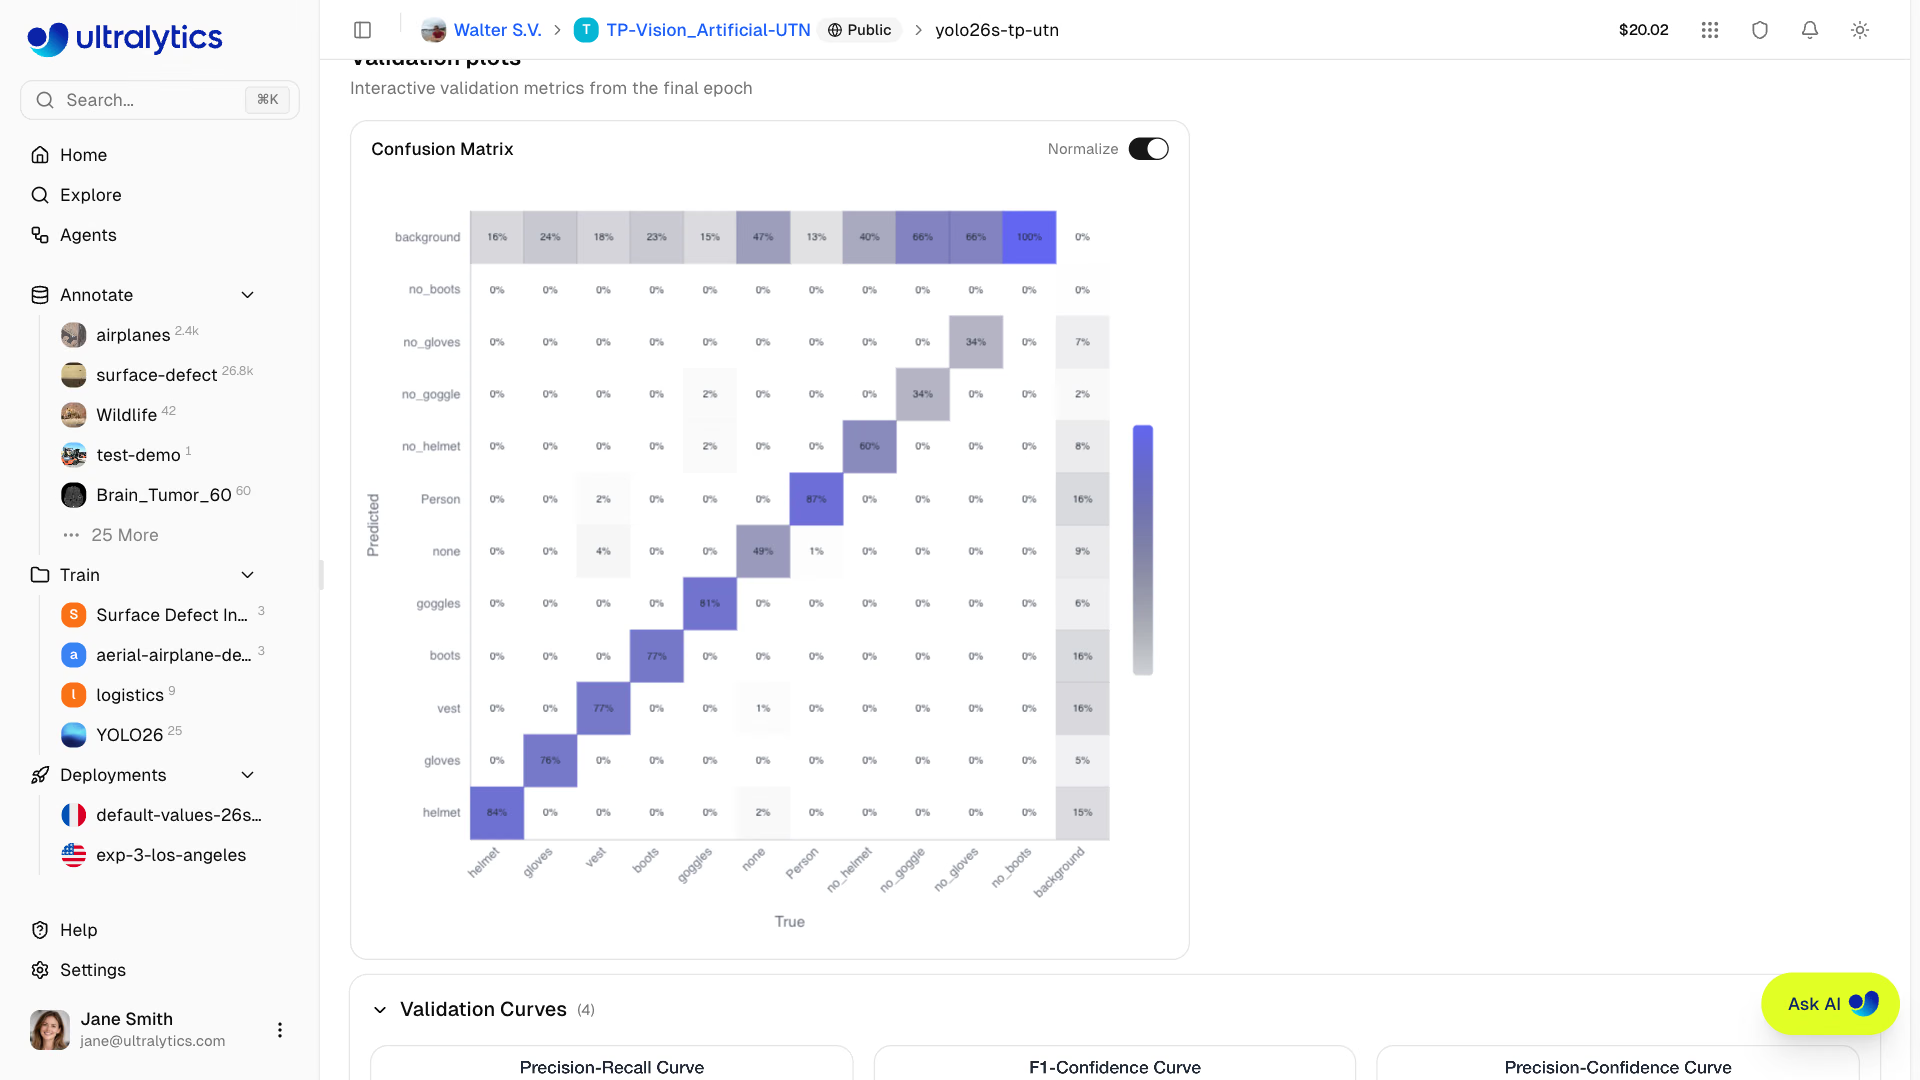
혼동 행렬은 가장 유용한 단일 진단 도구입니다. Ultralytics 그래프에서는 열이 실제 클래스이고 행이 예측 클래스이며, 여기에 background 행과 열이 추가됩니다. 정규화된 버전은 각 열을 해당 열의 합계로 나누므로 각 클래스의 객체가 어디로 분류되었는지 보여줍니다. Pills는 클래스가 하나뿐이므로 다음의 3개 클래스 창고 예제로 연습해 보세요(설명을 위한 수치입니다).
| 예측 ↓ / 실제 → | 지게차 | 사람 | 팔레트 | 배경 |
|---|---|---|---|---|
| 지게차 | 0.78 | 0.03 | 0.18 | 0.45 |
| 사람 | 0.04 | 0.91 | 0.00 | 0.20 |
| 팔레트 | 0.10 | 0.00 | 0.65 | 0.35 |
| 배경 | 0.08 | 0.06 | 0.17 | — |
- 대각선: 각 클래스에서 올바르게 탐지된 비율입니다. 팔레트는 0.65로 성능이 가장 낮은 클래스입니다.
- 대각선 외 항목: 클래스 간 혼동입니다. 실제 팔레트의 18%가 지게차로, 지게차의 10%가 팔레트로 예측되었습니다.
- 배경 행: 누락입니다. 팔레트의 17%가 전혀 탐지되지 않았습니다.
- 배경 열: 빈 공간에 박스가 그려지는 오탐입니다. 이 중 45%는 지게차로 분류되었습니다.
각 셀 유형에 해당하는 해결책은 다음과 같습니다.
| 패턴 | 해결 방법 |
|---|---|
| 두 클래스가 서로 혼동됨 | 두 클래스를 구분할 수 있는 예시를 추가합니다. 팔레트를 싣고 있는 지게차, 지게차 옆에 쌓인 팔레트 등을 포함합니다. |
| 배경 행의 값이 높음(누락) | 해당 클래스가 누락되는 조건에서 그 클래스의 예시를 더 추가합니다. |
| 배경 열의 값이 높음(오탐) | 빈 통로 등 오탐을 유발하는 장면의 배경 이미지를 추가합니다. |
클래스별 수치 읽기#
클래스가 여러 개이면 검증 로그에 클래스별 행이 출력되고, 코드에서 사용할 클래스별 mAP50-95는 metrics.box.maps에 저장됩니다. 창고 예제를 계속 살펴보겠습니다.
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
pallet 5 7 0.58 0.48 0.51 0.31pallet의 값은 다른 클래스보다 훨씬 낮고, 검증 데이터에는 인스턴스가 7개뿐입니다. 모델이 팔레트를 잘 탐지하지 못하거나, 판단할 검증 데이터가 너무 적을 수 있습니다. 어느 쪽이든 필요한 조치는 같습니다. 학습과 검증에 사용할 팔레트를 더 수집하세요.
실패 사례 살펴보기#
val_batch0_labels.jpg과 val_batch0_pred.jpg을 나란히 여세요. 차이는 이미지로 표현된 실패 사례이며, 그 안의 패턴을 보면 원인을 진단할 수 있습니다. 이미지 가장자리의 누락, 작은 객체, 특정 조명 조건, 혼동하기 쉬운 유사 객체 등이 그 예입니다. 이러한 데이터셋 패턴을 살펴보는 것이 거의 항상 하이퍼파라미터 튜닝보다 효과적입니다.
알약 모델의 검증 이미지에서 뚜렷하게 보이는 알약은 신뢰도 점수가 1.0에 가깝습니다. 신뢰도가 약 0.3~0.5인 낮은 점수의 박스는 다른 블리스터 팩 아래에 일부 가려진 알약과 이미지 가장자리에서 잘린 알약에 집중됩니다. 이는 conf을 조정해서 해결할 문제가 아니라 라벨링 정책의 문제입니다. 절반쯤 가려진 알약도 포함해야 할까요? 기준을 정하고 문서화한 뒤 모든 이미지에 동일하게 적용하세요.
그런 다음 results.png을 여세요. 학습 손실과 검증 손실은 함께 낮아져야 합니다. 학습 손실은 계속 낮아지는데 검증 손실이 높아지면 모델이 과적합되고 있는 것입니다. 두 손실이 모두 높은 상태로 멈춰 있다면 과소적합입니다. 두 현상 모두 편향-분산 상충 관계를 기준으로 살펴볼 수 있습니다.
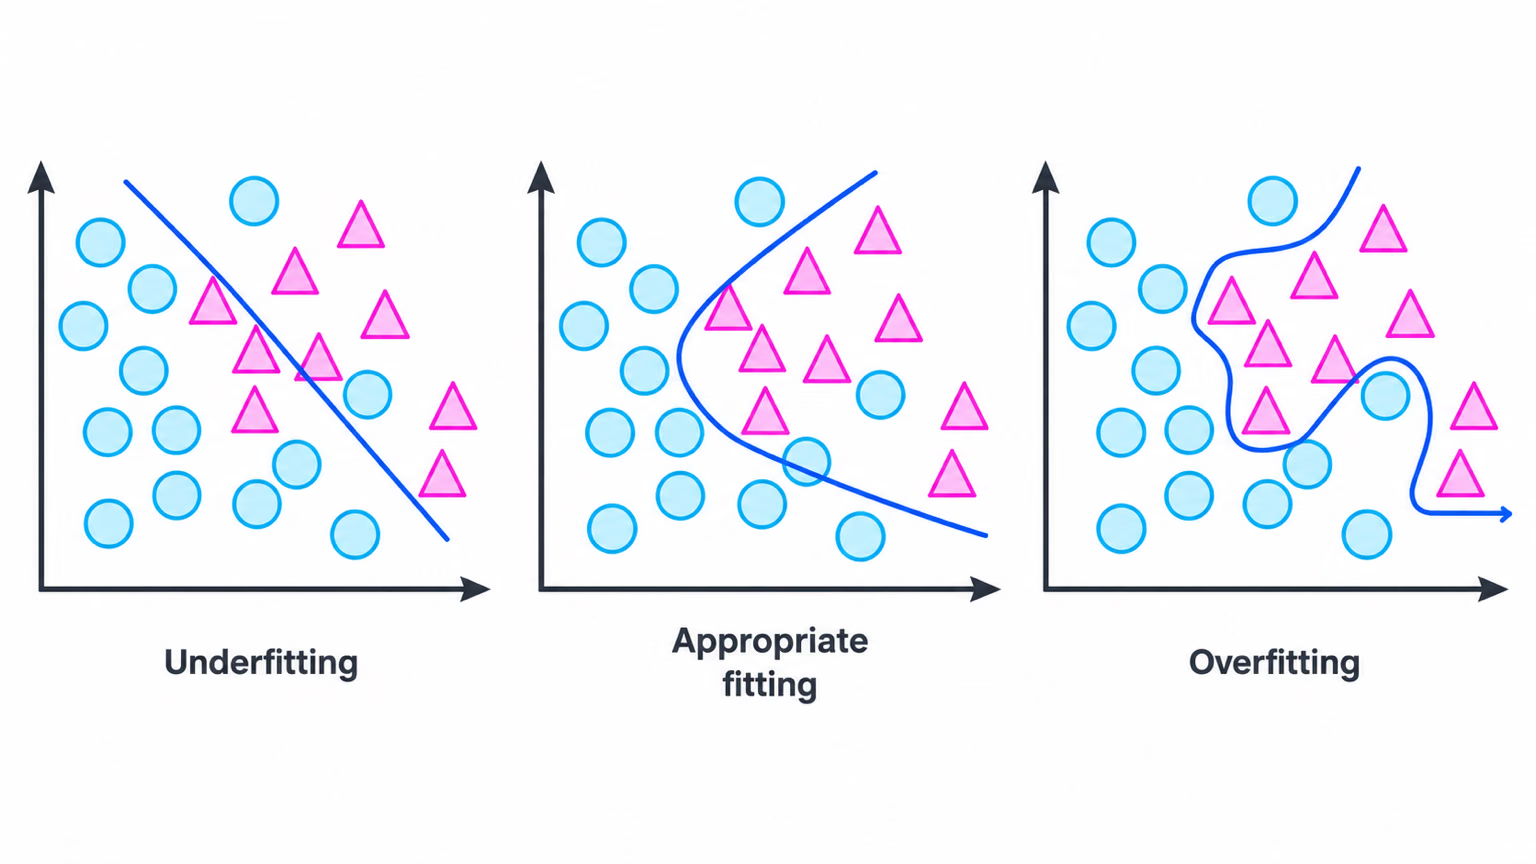
과적합을 해결하는 방법을 효과가 높은 순서대로 살펴보면, 더 다양해진 데이터, 더 적은 에포크 또는 더 엄격한 patience, 그리고 데이터 증강(hsv_h, degrees, translate, scale, fliplr, mosaic, ...)입니다. 기본 증강 설정은 이미 강력하므로, 좌우 방향이 중요한 경우 fliplr을 끄는 것처럼 이유가 있을 때만 변경하세요.
발견한 문제를 해결 목록으로 만들기#
하이퍼파라미터를 튜닝하기 전에 데이터를 먼저 수정하고, 무엇이 도움이 되었는지 알 수 있도록 각 반복에서 한 가지씩만 변경하세요. 이 반복 과정의 데이터셋 측면은 첫 파인튜닝과 반복 작업 과정에서 다룹니다.
이런 실수는 피하세요#
증상: mAP50-95 점수가 0.659였던 모델의 점수가 갑자기 0.403이 됩니다. 원인: pills_v1은 imgsz=320로 학습했지만 imgsz=640로 검증했습니다. 객체가 모델이 학습한 어떤 객체보다 두 배 크게 보입니다. 해결 방법: 학습에 사용한 imgsz 크기로 검증하고 배포하며, 실행 결과는 같은 크기에서만 비교하세요.
검증은 전체 정밀도-재현율 곡선을 추적할 수 있도록 conf=0.001에서 실행됩니다. 따라서 val_batch0_pred.jpg에는 앱에서 절대 보고하지 않을 박스도 표시됩니다. 배포 임계값은 BoxF1_curve.png에서 정한 다음 predict으로 확인하세요.
이미지가 23장뿐이면 한 에포크의 정밀도가 0.93에서 0.80으로 떨어졌다가 다시 올라가기도 합니다. 에포크와 실행 전반의 추세를 살펴보고, 1~2점 차이를 신뢰하기 전에 검증 세트를 늘리세요.
정답 보기
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.