객체 탐지 지표를 올바르게 해석하기
검증을 실행하고 정밀도, 재현율, mAP50-95, 클래스별 AP, 혼동 행렬을 함께 살펴본 다음 목표에 따라 배포 임계값을 선택합니다.
단일 수치는 안심을 줍니다. mAP 0.83이면 끝이라고 생각하기 쉽습니다. 하지만 같은 mAP에도 절반의 경우 실패하는 클래스, 일관되게 부정확한 박스, 또는 매분마다 알림을 발생시키는 임계값이 숨어 있을 수 있습니다. 실제 검증을 실행하고, 무엇을 어디서 수정해야 하는지 알 수 있도록 결과를 한 줄씩 살펴보겠습니다.
실습형
각 예측의 점수 계산 방식#
검증에서는 예측된 모든 박스를 정답과 대조합니다. 예측의 클래스가 올바르고 아직 매칭되지 않은 정답 박스와의 IoU가 임계값을 넘으면 참 양성(TP)입니다. 그렇지 않으면 거짓 양성(FP)입니다. 매칭되지 않은 정답 객체는 모두 거짓 음성(FN)입니다.
| 지표 | 공식 | 답하는 질문 |
|---|---|---|
| 정밀도 | TP / (TP + FP) | 모델이 박스를 그렸을 때, 그중 맞는 박스는 얼마나 자주 나올까요? |
| 재현율 | TP / (TP + FN) | 실제 객체 중 모델이 찾아낸 객체는 몇 개일까요? |
| F1 | 2 × P × R / (P + R) | 두 지표의 균형을 나타내는 하나의 수치 |
신뢰도 임계값을 낮추면 박스 수가 늘어납니다. 재현율은 높아지고 정밀도는 낮아집니다. 정밀도-재현율 곡선은 모든 임계값에서 이러한 상충 관계를 나타내며, 곡선 아래 면적은 한 클래스의 평균 정밀도(AP)입니다. mAP50은 IoU 0.5에서 클래스별 AP의 평균을 계산하므로 눈에 띄게 부정확한 박스도 인정됩니다. mAP50-95는 IoU 0.5~0.95의 임계값 10개에서 평균을 계산하므로 정밀한 박스에 더 높은 점수를 부여합니다. Ultralytics 모델 표의 대표 지표입니다.
검증 실행#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml")

print(f"precision={metrics.box.mp:.3f} recall={metrics.box.mr:.3f}")
print(f"mAP50={metrics.box.map50:.3f} mAP50-95={metrics.box.map:.3f}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 4 17 0.551 0.962 0.943 0.669
person 3 10 0.551 0.8 0.848 0.387
dog 1 1 0.36 1 0.995 0.597
horse 1 2 0.36 1 0.995 0.696
elephant 1 2 0.656 0.969 0.828 0.545
umbrella 1 1 0.543 1 0.995 0.895
potted plant 1 1 0.833 1 0.995 0.895위에서 아래로 읽어 보세요:
- Instances 17, Images 4. COCO8은 스모크 테스트용입니다. 이미지 네 장으로는 배포 결정을 내릴 수 없습니다. 모든 수치는 예시로만 보세요.
- mAP50 0.943 vs mAP50-95 0.669. 대부분의 객체를 찾았지만, 많은 박스가 부정확합니다. 차이가 크다는 것은 객체 탐지가 아니라 위치 추정이 약점이라는 뜻입니다.
personAP50-95 0.387. 가장 흔한 클래스의 성능이 가장 낮습니다. 이 클래스가 병목입니다.- P 0.551, R 0.962. 이 열은 모든 클래스에서 F1을 최대화하는 단일 신뢰도 값, 즉 여기서는 낮은 임계값에서 계산됩니다. 예측에 사용하는 0.25에서 계산된 값이 아닙니다. 이 값을 "모델의 정밀도"라고 인용하지 마세요.
클래스별 AP와 배포 임계값#
같은 실행 결과에 클래스별 AP와 모든 신뢰도 임계값에서의 정밀도 및 재현율이 포함되므로, 추측이 아닌 목표에 따라 임계값을 선택할 수 있습니다:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
metrics = model.val(data="coco8.yaml", plots=False, verbose=False)
box = metrics.box

# Per-class AP from the same run: the average hides the weakest class
for i, c in enumerate(box.ap_class_index):
    print(f"{model.names[int(c)]:13} AP50={box.ap50[i]:.3f}  AP50-95={box.ap[i]:.3f}")

# Precision and recall at every confidence threshold for one class
row = list(box.ap_class_index).index(0)  # class 0 = person
for conf in (0.1, 0.25, 0.5, 0.75):
    j = int(conf * (len(box.px) - 1))
    print(f"person @ conf {conf:.2f}: precision {box.p_curve[row, j]:.2f}, recall {box.r_curve[row, j]:.2f}")
all 4 17 0.551 0.962 0.943 0.669
person AP50=0.848 AP50-95=0.387
dog AP50=0.995 AP50-95=0.597
horse AP50=0.995 AP50-95=0.696
elephant AP50=0.828 AP50-95=0.545
umbrella AP50=0.995 AP50-95=0.895
potted plant AP50=0.995 AP50-95=0.895
person @ conf 0.10: precision 0.63, recall 0.80
person @ conf 0.25: precision 1.00, recall 0.54
person @ conf 0.50: precision 1.00, recall 0.40
person @ conf 0.75: precision 1.00, recall 0.14이제 임계값은 느낌이 아니라 의사결정 규칙입니다:
| 의사결정 기준의 목표 | 선택 기준 | 이 실행 결과 |
|---|---|---|
| 알림의 오탐 비율을 최대 5%로 제한 (정밀도 ≥ 0.95) | 재현율을 최대한 높이면서 목표를 충족하는 가장 낮은 임계값 | 0.25: 정밀도 1.00, 재현율 0.54 |
| 사람 5명 중 최대 1명만 놓침 (재현율 ≥ 0.80) | 정밀도를 최대한 높이면서 목표를 충족하는 가장 높은 임계값 | 0.10: 정밀도 0.63, 재현율 0.80 |
여기서는 어느 쪽도 충분하지 않습니다. 정밀도를 높이면 사람의 절반을 놓치고, 재현율을 높이면 알림의 3분의 1이 오탐이 됩니다. 이는 임계값 문제가 아니라 "반복 개선"이 필요하다는 근거입니다. 검증을 실행하면 실행 폴더에 BoxPR_curve.png, BoxP_curve.png, BoxR_curve.png, BoxF1_curve.png, confusion_matrix.png도 저장되므로, 그래프에서 같은 상충 관계를 확인할 수 있습니다. 성능 지표 가이드에서 각 지표를 설명합니다.
다음으로 수정할 항목#
혼동 행렬은 성능이 낮은 클래스가 무엇으로 잘못 분류되는지 알려줍니다. forklift의 AP가 낮고 지게차가 pallet_jack로 예측된다면, 이는 위치 추정 문제가 아니라 클래스 혼동입니다. 시각적 차이를 보여주는 예시를 추가하거나, 다운스트림 코드에서 클래스를 구분할 필요가 없다면 클래스를 병합하세요. 모델 평가 인사이트 가이드에서 워크플로를 설명합니다.
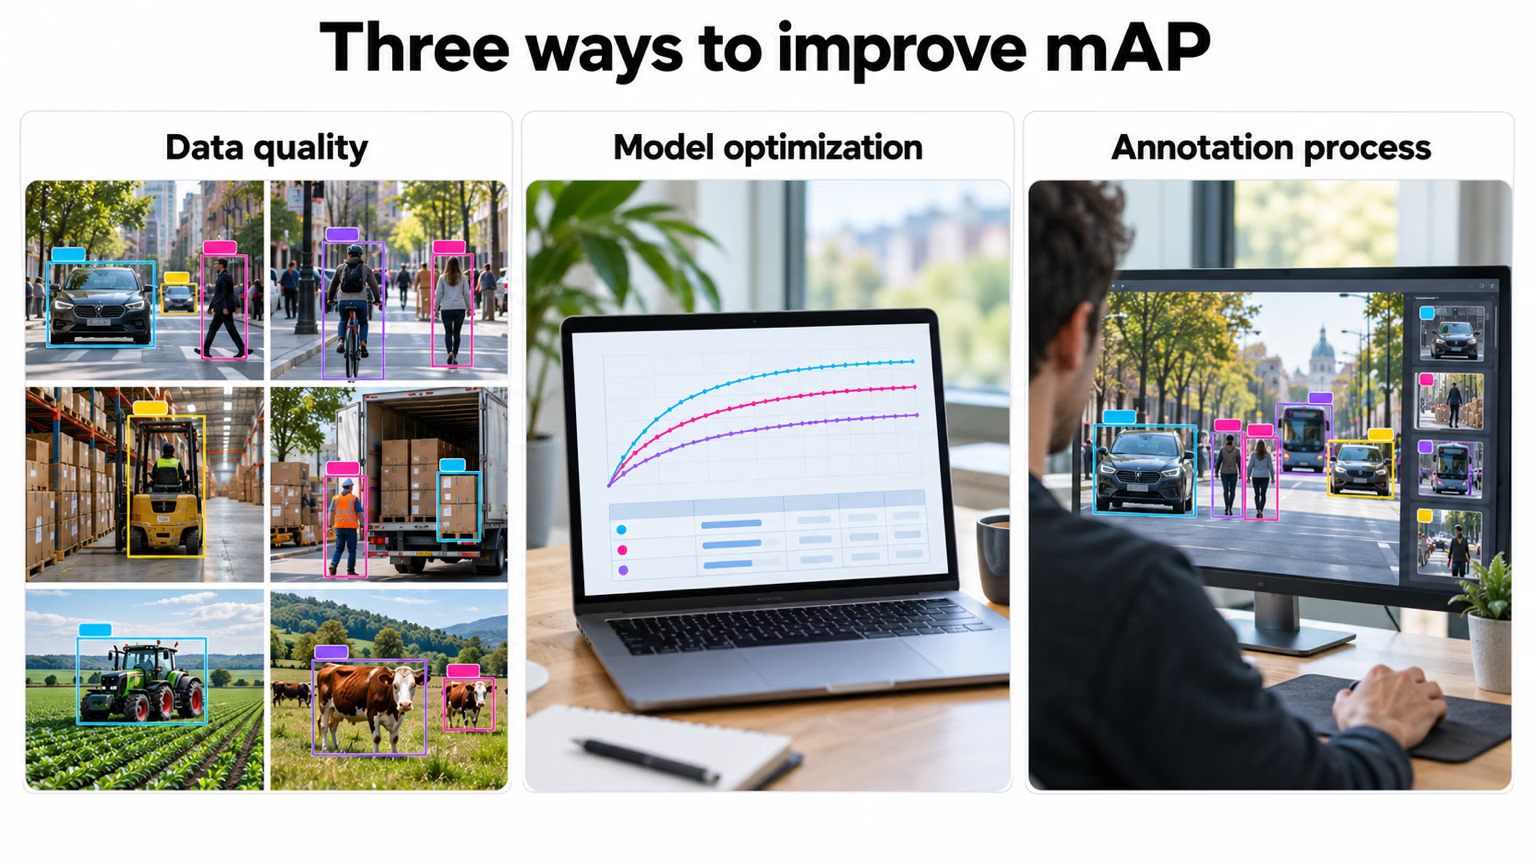
대부분의 수정은 첫 번째와 세 번째 항목, 즉 병목 클래스의 데이터와 라벨 개선에 해당합니다. 모델이나 학습 설정은 이전 세 강의의 데이터 검사를 통과한 뒤에만 변경하세요.
| 고정된 테스트 세트에서 얻은 근거 | 결정 |
|---|---|
| 비즈니스에 중요한 모든 클래스가 정밀도 및 재현율 목표를 충족합니다 | 배포하고 모니터링합니다 |
| 한 개 클래스 또는 조건이 목표를 충족하지 못합니다 | 반복 개선: 해당 격차를 해소하기 위한 데이터와 라벨을 보강합니다 |
| 모든 클래스의 성능이 크게 부족하거나 클래스가 시각적으로 겹칩니다 | 작업 사양, 클래스 또는 카메라 구성을 재검토합니다 |
주의할 점#
mAP 0.83 뒤에 0.40인 클래스가 숨겨져 있을 수 있습니다. 그 클래스가 비즈니스 가치를 좌우한다면, 모델의 성능은 0.83이 아닙니다. 보기 좋게 평균만 높게 나온 성능이 실제로는 실패한 모델입니다.
증상: "점수가 0.94"인 모델이 측정이나 크롭에 사용하기에는 너무 느슨한 박스를 그립니다. 해결: mAP50-95를 보고하고, mAP50과의 차이를 위치 추정의 정확도를 나타내는 신호로 해석합니다.
증상: 이미지 수십 장으로 완벽해 보이는 수치가 나오거나, 학습 세트와 거의 쌍둥이인 데이터에서 수치가 나옵니다. 해결: 중요 클래스마다 검증 데이터를 수백 개 인스턴스까지 늘리고, 어떤 지표를 보기에 앞서 이전 강의의 근접 중복 검사를 실행합니다.
정답 보기
판독 결과: yolo26n.pt의 사람 카운터, COCO8 검증
병목은 전체 0.669에 비해 AP50-95가 0.387인 person입니다. 또한 인스턴스 수가 가장 많은 클래스(17개 중 10개)이므로, 가장 성능이 낮을 뿐 아니라 사람 카운터에 가장 중요한 클래스이기도 합니다. AP50은 0.848이므로 모델은 대부분의 사람을 찾지만 박스가 느슨하게 그려집니다. 위치나 크기를 측정하는 작업과 달리, 사람 수를 세는 작업에서는 이 점이 덜 중요합니다.
정밀도 ≥ 0.95를 만족하는 가장 낮은 임계값은 conf 0.25이며, 이때 정밀도는 1.00이지만 재현율은 0.54에 불과합니다. 즉, 카운터가 사람의 거의 절반을 놓치게 됩니다. 재현율 ≥ 0.80을 원한다면 conf 0.10이 필요하며, 이때 집계된 수의 3분의 1은 오탐입니다.
결정: 반복 개선합니다. 배포 카메라에서 사람 데이터를 수집하고 라벨링하세요. 특히 작거나 가려진 사람, 프레임 가장자리에 있는 사람을 포함해야 합니다. 그런 다음 수백 명 규모의 고정 테스트 세트로 다시 검증하세요. 검증 이미지가 4장뿐이라면 어느 쪽으로든 배포 여부를 결정할 근거가 부족합니다.