박스와 마스크: 실제로 세그멘테이션이 필요한 경우
실제 이미지에서 마스크가 박스보다 제공하는 이점을 측정하고, 프로젝트에 모양 정보가 필요한지 다운스트림 소비자를 기준으로 결정합니다.
AI 비전을 떠올릴 때 대부분의 사람이 생각하는 것은 마스크이며, 팀이 라벨링 예산을 가장 많이 쓰는 부분이기도 합니다. 마스크는 객체의 정확한 모양을 알려 주지만, 박스는 객체의 위치만 알려 줍니다. 이 차이가 일부 제품의 성패를 완전히 좌우하지만, 대부분의 제품에는 아무런 영향을 주지 않습니다.
실습형
마스크가 제공하는 정보#
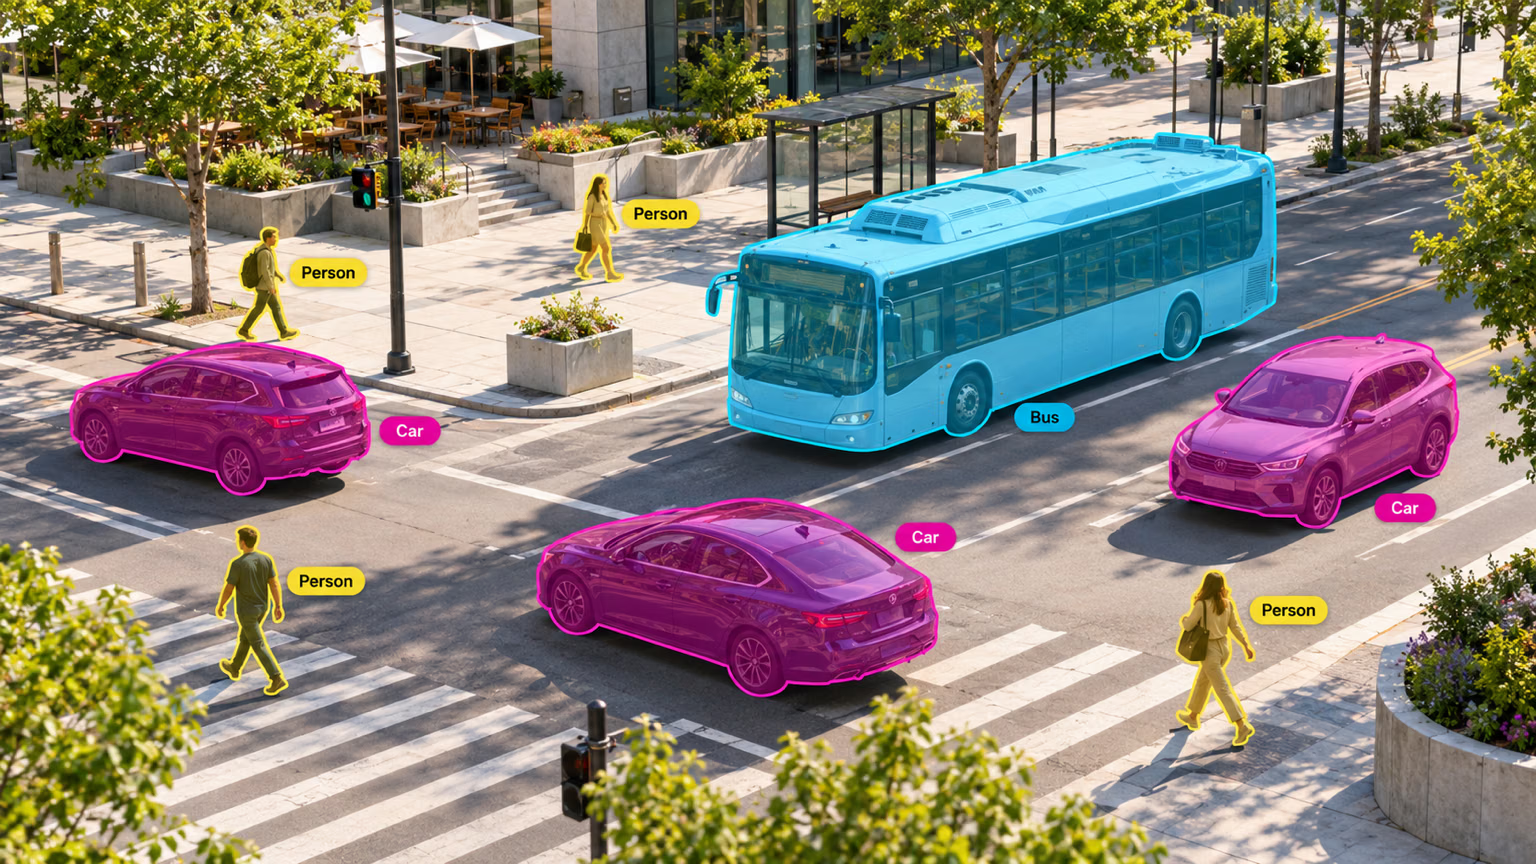
각 객체에 대해 세그먼트 태스크는 탐지기가 반환하는 클래스, 박스, 신뢰도에 더해 객체에 속하는 픽셀까지 반환합니다. 따라서 위 이미지에서 각 자동차는 버스 및 사람들과 구분되는 자체 윤곽을 갖습니다. 마스크는 폴리곤(masks.xy) 또는 바이너리 이미지(masks.data)로 읽을 수 있습니다.
모양 정보는 수치에 얼마나 영향을 미칠까요? 각 객체의 박스 면적과 마스크 면적을 비교합니다:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)버스는 박스 면적의 62%만 차지하고, 사람 한 명은 31%만 차지합니다. 박스만으로 계산하는 페인트 면적, 유출 크기, 선반의 빈 공간 등은 모두 그만큼 오차가 생깁니다. 제품이 이와 같은 수치를 보고한다면 마스크가 필요합니다. 제품이 객체를 계수하거나 위치를 찾기만 한다면 추가 픽셀은 아무런 차이를 만들지 않습니다.
증상: 마스크 영역이 박스 영역보다 3~4배 작아 보입니다. 원인: 기본적으로 masks.data은 추론 크기(여기서는 640×480)로 반환되지만, 박스는 원본 이미지 픽셀(1080×810) 기준입니다. 해결: 위에서처럼 retina_masks=True을 전달하거나 직접 수치를 스케일링합니다.
데모가 아니라 소비자의 요구를 기준으로 결정합니다#
| 다운스트림 요구 사항 | 박스만으로 충분한가요? | 이유 |
|---|---|---|
| 객체를 계수하거나 존재 여부 확인 | 예 | 위치만으로 충분합니다 |
| 객체가 구역에 들어오면 알림 전송 | 예 | 박스가 선을 넘는지 확인하면 충분합니다 |
| 프레임 간 객체 추적 | 예 | 트래커는 박스를 연결합니다 |
| 두 번째 분류기에 전달할 크롭 생성 | 예 | 크롭에는 박스만 있으면 됩니다 |
| 면적 또는 점유율 측정(잡초, 녹, 유출) | 아니요 | 불규칙한 모양에서는 박스 면적이 의미가 없습니다 |
| 객체 분리(배경 제거, AR) | 아니요 | 정확한 경계가 필요합니다 |
| 간격 또는 접촉 여부 확인(로봇 그리퍼, 충돌) | 아니요 | 박스가 객체 크기를 과대평가합니다 |
| 서로 닿아 있는 불규칙한 객체 분리 | 대개 아니요 | 겹치는 박스는 어느 픽셀이 어느 객체에 속하는지 불분명하게 합니다 |
제품에 필요한 모든 항목의 답이 "예"라면 탐지기를 배포하세요. 모양 정보가 실질적인 가치를 더할 때만 YOLO26 세그멘테이션을 사용하세요.
인스턴스 세그멘테이션과 시맨틱 세그멘테이션 비교#
인스턴스 세그멘테이션은 각 객체에 자체 마스크를 부여하므로 겹치는 자동차 세 대도 세 대로 구분됩니다. 시맨틱 세그멘테이션은 각 픽셀에 클래스만 지정합니다. 모든 자동차 픽셀이 하나의 "자동차" 영역으로 표시되므로 개별 객체 수를 알 수 없습니다. 세포, 과일, 결함처럼 개별 객체를 계수하거나 측정하려면 인스턴스 세그멘테이션을 사용합니다. 도로와 인도, 작물과 토양처럼 영역의 점유율을 측정하려면 시맨틱 세그멘테이션을 사용합니다.
모양 정보를 라벨링하는 데 드는 비용#
박스는 두 번 클릭하면 만들 수 있습니다. 정밀한 폴리곤은 수십 번 클릭해야 할 수 있으며, 경계마다 주석 작업자 간에 의견 차이가 생길 수 있습니다. 가방이 사람에 포함되는지, 그림자가 자동차의 일부인지 등을 판단해야 합니다. 일반적인 기준을 그대로 따르기보다 직접 비용을 측정하세요. 주석 작업자가 객체 20개를 박스로 표시하는 데 걸리는 시간과 같은 객체 20개를 폴리곤으로 표시하는 데 걸리는 시간을 측정한 다음, 그 차이에 데이터셋 크기를 곱합니다.
AI 지원 도구를 사용하면 작업량 차이를 크게 줄일 수 있습니다. 스마트 어노테이션 및 배치 라벨링은 클릭이나 박스를 바탕으로 마스크를 제안하므로 주석 작업자는 직접 윤곽을 그리는 대신 경계를 수정합니다. 다만 모든 경계를 사람이 검토해야 합니다.
라벨링을 시작하기 전에 가림, 투명 객체, 그림자, 프레임 가장자리에 잘린 객체, 부착된 물체(가방, 손잡이, 화물)에 관한 규칙을 정하고 같은 문서를 어노테이터와 검토자에게 제공하세요. Annotation Best Practices에서는 규칙을 적용하는 방법을 다루며, COCO-Seg dataset은 대규모 데이터에서 일관된 마스크를 보여줍니다.
마스크를 표본 검사할 때 번짐(마스크가 경계를 넘어 확장됨), 구멍(객체 내부 영역을 놓침), 유령 경계(마스크가 JPEG 아티팩트를 따라감), 모호한 부분(여행 가방 손잡이가 여행 가방 마스크에 포함되는가?)을 확인하세요.
정답 보기
두 제품이 버스 카메라를 공유한다고 가정해 보겠습니다. 하나는 보행자 계수기이고, 다른 하나는 차량이 장면을 얼마나 차지하는지 보고하는 도로 점유율 보고서입니다. 한 번 실행해 두 결과를 모두 측정합니다:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- 보행자 계수기 → 박스. 두 방식 모두 계수 결과는 4입니다. 마스크는 라벨링 비용만 늘릴 뿐 결과에는 영향을 주지 않습니다.
- 점유율 보고서 → 마스크. 박스는 버스가 장면의 47%를 차지한다고 계산하지만, 실제 점유율은 29%입니다. 박스 기반 보고서는 오차가 절반을 넘습니다.