현실을 반영하는 데이터셋
라벨을 더 지정하기 전에 실제 데이터셋의 커버리지 공백을 감사하고, 공백을 하드 네거티브가 포함된 데이터 수집 계획으로 전환합니다.
실망스러운 비전 모델 대부분은 모델 자체가 나쁜 것이 아닙니다. 배포 장소와 다른 데이터셋으로 학습한 우수한 모델인 경우가 많습니다. 이전 강의에서 COCO 객체 감지 모델은 드론에서 촬영한 보트를 하나도 찾지 못했습니다. COCO의 보트는 측면에서 촬영되었기 때문입니다. 5분만 감사해도 라벨링에 비용을 쓰기 전에 이러한 공백을 발견할 수 있습니다.
실습형
모델은 세상이 아니라 데이터셋을 학습합니다#
모델은 이미 본 예시들 사이를 보간합니다. 화창한 낮의 도로에서 학습하고 밤의 안개 낀 차고에 배포하면 모델은 실패합니다. 자동차가 다르게 보이기 때문이 아니라, 해당 조건에서 자동차를 본 적이 없기 때문입니다. 이러한 불일치를 도메인 시프트라고 합니다. 검증 이미지도 동일하게 편향된 데이터에서 가져오면 검증으로는 이를 감지할 수 없습니다.
해결책은 알고리즘 변경이 아니라 구조적인 접근입니다. 라벨링을 시작하기 전에 배포 환경의 샘플을 의도적으로 수집합니다. 자세한 방법은 데이터 수집 및 어노테이션 가이드를 참조하세요.
실제 데이터셋 감사하기#
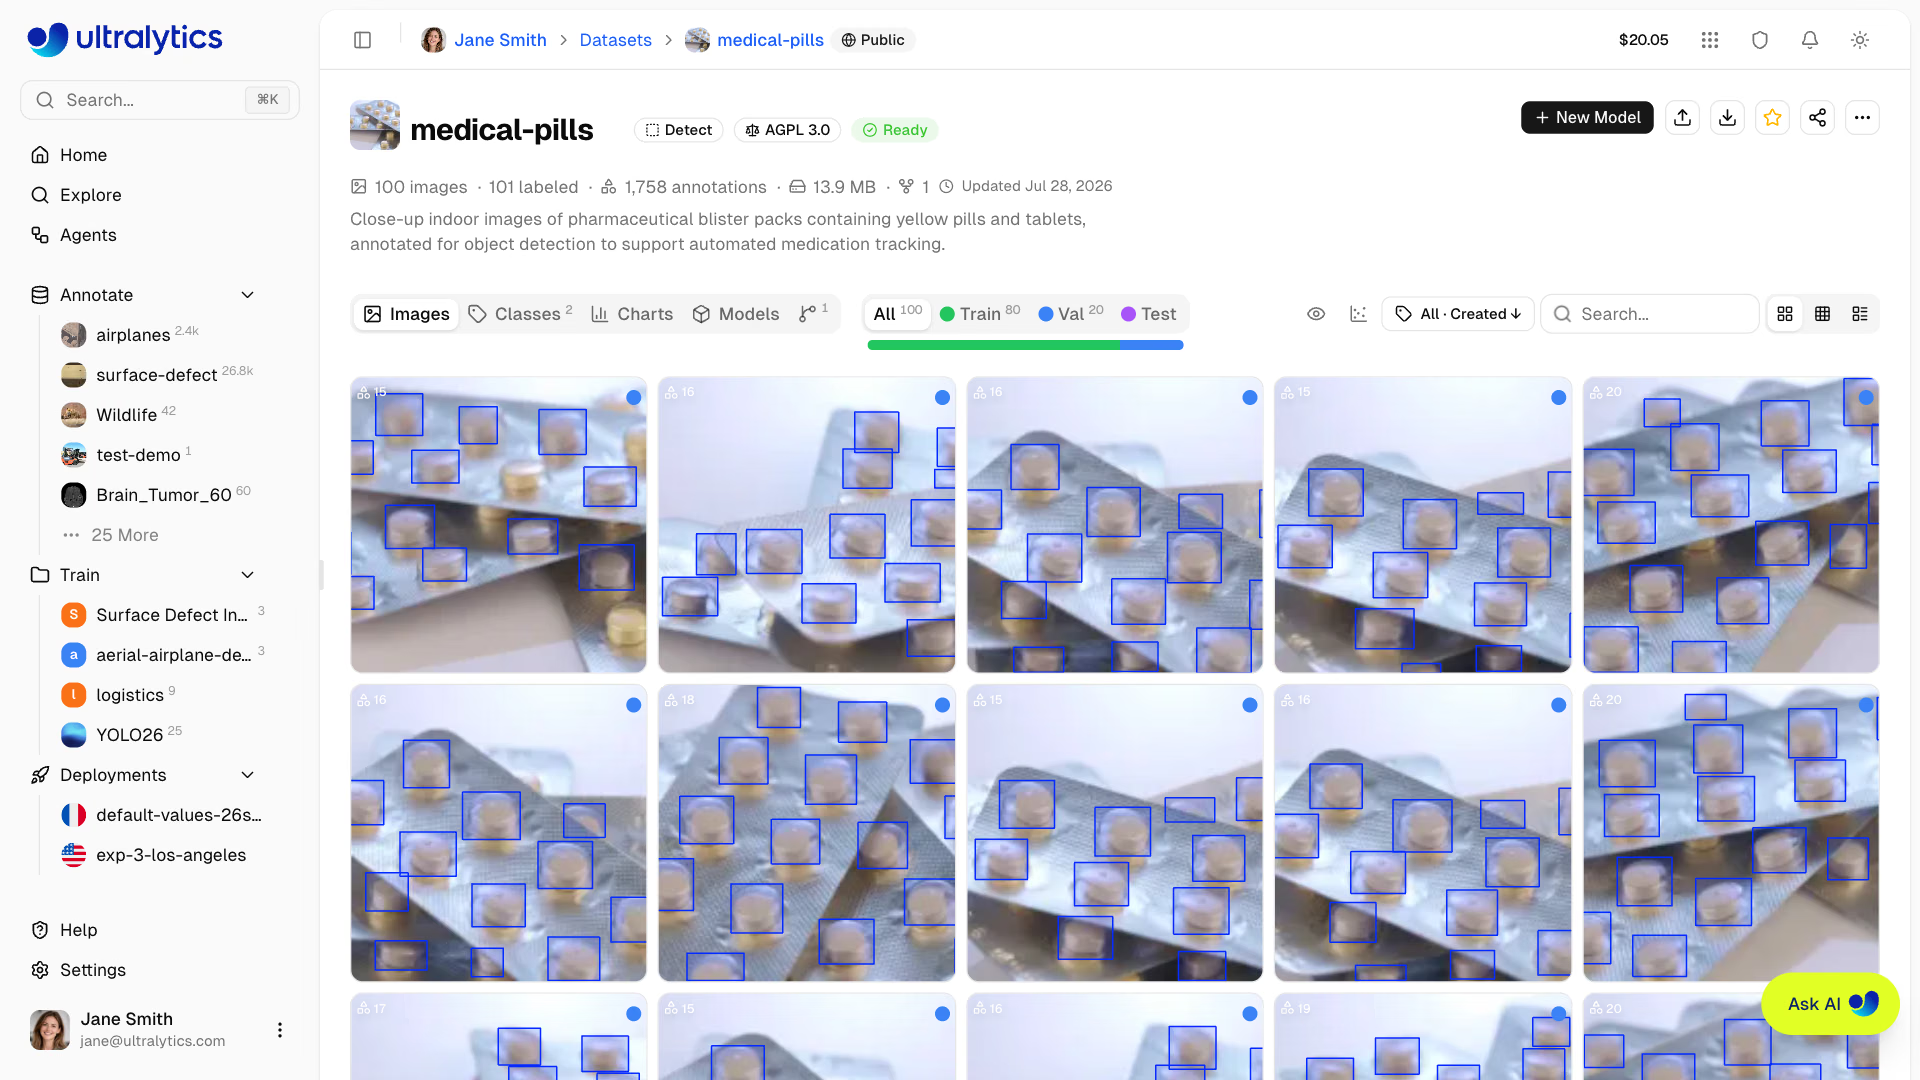
위의 medical-pills 데이터셋은 블리스터 팩을 근접 촬영하고 모든 알약에 박스를 표시한 데이터셋으로, 감사를 수행하기에 적합합니다. Ultralytics Platform은 데이터셋 페이지에서 주요 개수를 보여줍니다. 아래 스크립트는 ultralytics에 포함된 사본에서 커버리지를 파악하는 수치를 계산합니다.
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)다음과 같이 한 줄에 하나씩 결과를 확인합니다.
| 결과 | 의미 | 결정 |
|---|---|---|
| 해상도 한 가지, 1920×1080 | 카메라 한 대, 설정 한 가지 | 배포할 모든 카메라 모델에서 데이터를 수집합니다 |
| 밝기 범위가 171~198에 불과합니다 | 밝고 균일한 스튜디오 조명만 있고 어두운 조건은 없습니다 | 약국 카운터에 배포하기 전에 어두운 조명, 역광, 혼합 조명에서 촬영한 이미지를 수집합니다 |
| 배경 이미지 0개 | 모델은 알약이 없는 장면을 본 적이 없습니다 | 빈 블리스터 팩, 다른 정제, 아무것도 없는 카운터를 하드 네거티브로 추가합니다 |
| 박스 중앙값은 이미지의 1.4%이며, 박스 5개 중 1개는 1% 미만입니다 | 작은 객체 | imgsz을 충분히 높게 설정하고 멀리서 촬영한 이미지를 의도적으로 포함합니다 |
클래스 한 개, pill | 알약 종류가 구분되지 않습니다 | 개수 세기에는 적합합니다. 의사결정에 필요한 경우에만 클래스를 추가합니다 |
검증 이미지에도 이 조건들이 모두 포함되어 있으므로, 이 항목들은 검증 점수에 드러나지 않습니다.
커버리지를 구성하는 네 가지 축#
| 축 | 수집할 항목 | 누락 시 흔히 발생하는 실패 |
|---|---|---|
| 조명 | 새벽, 정오, 해 질 녘, 야간, 눈부심, 역광, 깜박이는 형광등 | 교대 시간이나 직사광선 아래에서 재현율이 급락합니다 |
| 날씨와 대기 상태 | 비, 안개, 눈, 먼지, 렌즈 결로 | 물방울을 오탐하고 안개 속 객체를 놓칩니다 |
| 가림과 혼잡도 | 일부가 가려진 타깃, 혼잡한 장면, 프레임 가장자리에서 잘린 객체 | 타깃이 완전히 보이지 않을 때마다 놓칩니다 |
| 카메라와 시점 | 렌즈, 설치 높이와 각도, 해상도, 압축, 모션 블러 | 파일럿 카메라에서는 작동하지만 다음 설치 장소에서는 실패합니다 |
마리나 사례에서 놓친 축은 시점입니다. 같은 클래스라도 새로운 각도에서 촬영하자 재현율이 0으로 떨어졌습니다.
하드 네거티브와 배경 이미지#
객체 감지 모델은 타깃이 아닌 것이 무엇인지도 학습해야 합니다. 하드 네거티브는 겉보기에 타깃과 비슷합니다. 지게차 감지 모델의 경우 팔레트 잭, 시저 리프트, 광택 바닥에 비친 지게차, 지게차 사진이 인쇄된 안전 포스터가 이에 해당합니다.
YOLO 형식에서 배경 이미지는 라벨 파일이 없는 이미지일 뿐이며, 그릴 항목이 없습니다. Ultralytics 학습 팁에서는 오탐을 줄이기 위해 배경 이미지를 약 0~10% 포함할 것을 권장합니다. COCO 자체에는 약 1%가 포함되어 있습니다. 이 비율은 무작위로 골라낸 빈 프레임이 아니라 자체 환경에서 수집한 하드 네거티브로 채웁니다. 데이터 증강으로 밝기와 각도를 다양하게 만들 수는 있지만, 모델이 한 번도 본 적 없는 팔레트 잭을 만들어 낼 수는 없습니다.
주의할 점#
증상: 라벨링된 이미지 10,000장이 모두 낮 시간에 파일럿 카메라에서 촬영되었습니다. 해결: 배포 카메라에서 몇 주 동안 전체 조건 범위의 데이터를 기록하고, 커버리지를 감사한 다음 라벨링 비용을 지불합니다. Synthetic data는 알려진 공백을 메울 수 있지만 실제 촬영 데이터를 대체하지는 않습니다.
증상: 검증 mAP는 높지만 첫 신규 현장에서 성능이 좋지 않습니다. 해결: 검증 데이터에도 데이터셋의 맹점이 있다는 점을 기억하세요. 학습 이미지 10장과 프로덕션 프레임 10장을 무작위로 뽑아 동료에게 어느 쪽인지 구분해 보라고 하세요. 구분할 수 있다면 도메인 갭이 있는 것입니다.
조건별 목표 수량을 설정한 샘플링 계획을 세우려면 고성능 YOLO 데이터셋 구축에서 고품질 대표 데이터 수집을 계속 살펴보세요.
정답 보기
혼합된 매장 조명이 있는 약국 카운터에 배포할 medical-pills의 경우, 감사 결과(밝기 171–198, 1920×1080 소스 1개, 배경 이미지 0개)와 이미지를 빠르게 훑어본 결과를 바탕으로 그리드를 채우세요. 같은 밝은 표면 위에 같은 포장 제품이 놓여 있고 손은 보이지 않습니다:
| 클래스 | 밝은 스튜디오 조명 | 어둡거나 따뜻한 색조의 매장 조명 | 역광 / 눈부심 | 손에 일부 가려짐 | 휴대폰 카메라 |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| 배경 | 0 | 0 | 0 | — | 0 |
우선순위별 수집 계획:
- 어둡거나 따뜻한 색조의 매장 조명 — 카운터의 일반적인 환경이지만 현재 이미지는 0개입니다.
- 손에 일부 가려짐 — 실제 상호작용에서는 거의 매번 발생합니다.
- 휴대폰 카메라 — 두 번째 센서와 해상도에 해당합니다.
- 역광 / 눈부심 — 호일 포장에 창문과 천장 조명이 반사됩니다.
하드 네거티브: 빈 블리스터 포장(같은 호일 포장이지만 알약은 없음)과 카운터 위의 다른 둥근 물체 — 동전, 단추, 사탕입니다. 이를 배경 이미지로 데이터셋의 약 5–10%가 되도록 추가하세요.