어노테이션 품질
YOLO 라벨의 구성 요소를 파악하고, 라벨 파일의 오류 행을 린트로 검사하며, 가이드라인과 측정 가능한 교정 라운드를 통해 어노테이터 간 일관성을 유지하세요.
일관성 없는 라벨로 학습한 모델은 그 불일치를 학습합니다. 명확한 규칙 하나에 따라 그린 박스 5만 개가 서로 다른 해석 20가지에 따라 그린 박스 50만 개보다 낫고, 대개 더 큰 모델을 사용하는 것보다 라벨을 다시 지정하는 편이 저렴합니다. 이 강의에서는 라벨 린터, 한 페이지 분량의 가이드라인, 어노테이터 간 일치도를 나타내는 수치를 제공합니다.
실습형
라벨의 실제 의미#
YOLO 형식에서는 각 이미지에 대응하는 .txt 파일이 있으며, 파일에는 객체마다 한 행이 들어 있습니다. 좌표는 이미지의 너비와 높이를 기준으로 0–1 범위로 정규화되므로 이미지 크기를 조정해도 라벨이 유지됩니다. 행의 레이아웃은 작업에 따라 달라집니다:
| 작업 | 라벨 하나 | 참고 사항 |
|---|---|---|
| 검출 | class x_center y_center width height | 박스 중심과 크기 |
| 인스턴스 분할 | class x1 y1 x2 y2 ... xn yn | 폴리곤 윤곽선 |
| 자세 추정 | class x y w h px1 py1 v1 ... pxn pyn vn | 박스 다음에 가시성 정보를 선택적으로 포함한 키포인트 |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | 회전된 박스의 네 모서리 |
| 분류 | 라벨 파일 없음 | 클래스별 폴더 하나에 이미지를 정리합니다. |
| 시맨틱 세그멘테이션 | 이미지마다 PNG 마스크 하나 | 각 픽셀 값은 클래스 인덱스입니다. |
| 깊이 추정 | 이미지마다 깊이 PNG 또는 NPY 하나 | 각 픽셀 값은 거리입니다. |
클래스 인덱스는 0부터 시작하며 데이터셋 YAML의 이름에 매핑됩니다. 객체가 없는 이미지에는 라벨 파일이 필요하지 않습니다. 이것이 배경 이미지가 사용되는 방식입니다. 탐지 형식, 시맨틱 세그멘테이션, 깊이 데이터셋 페이지에서 실제 예제를 확인할 수 있습니다.
라벨 파일 린트 검사#
잘못된 행은 오류 없이 넘어갈 수 있습니다. 좌표가 1보다 크거나, 클래스 ID가 YAML에 정의되어 있지 않거나, 같은 객체에 박스가 두 번 그려져도 모두 모델이 학습하려는 노이즈가 됩니다. 간단한 린터로 학습 전에 이런 문제를 찾아내세요:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label files직접 만든 샘플은 린터가 찾아내는 각 오류를 보여 주고, 실제 데이터셋은 문제없이 통과합니다. 라벨링 배치가 끝날 때마다, 그리고 학습을 실행하기 전에 린터를 실행하세요. 몇 초면 충분합니다.
라벨이 일관성을 잃는 이유#
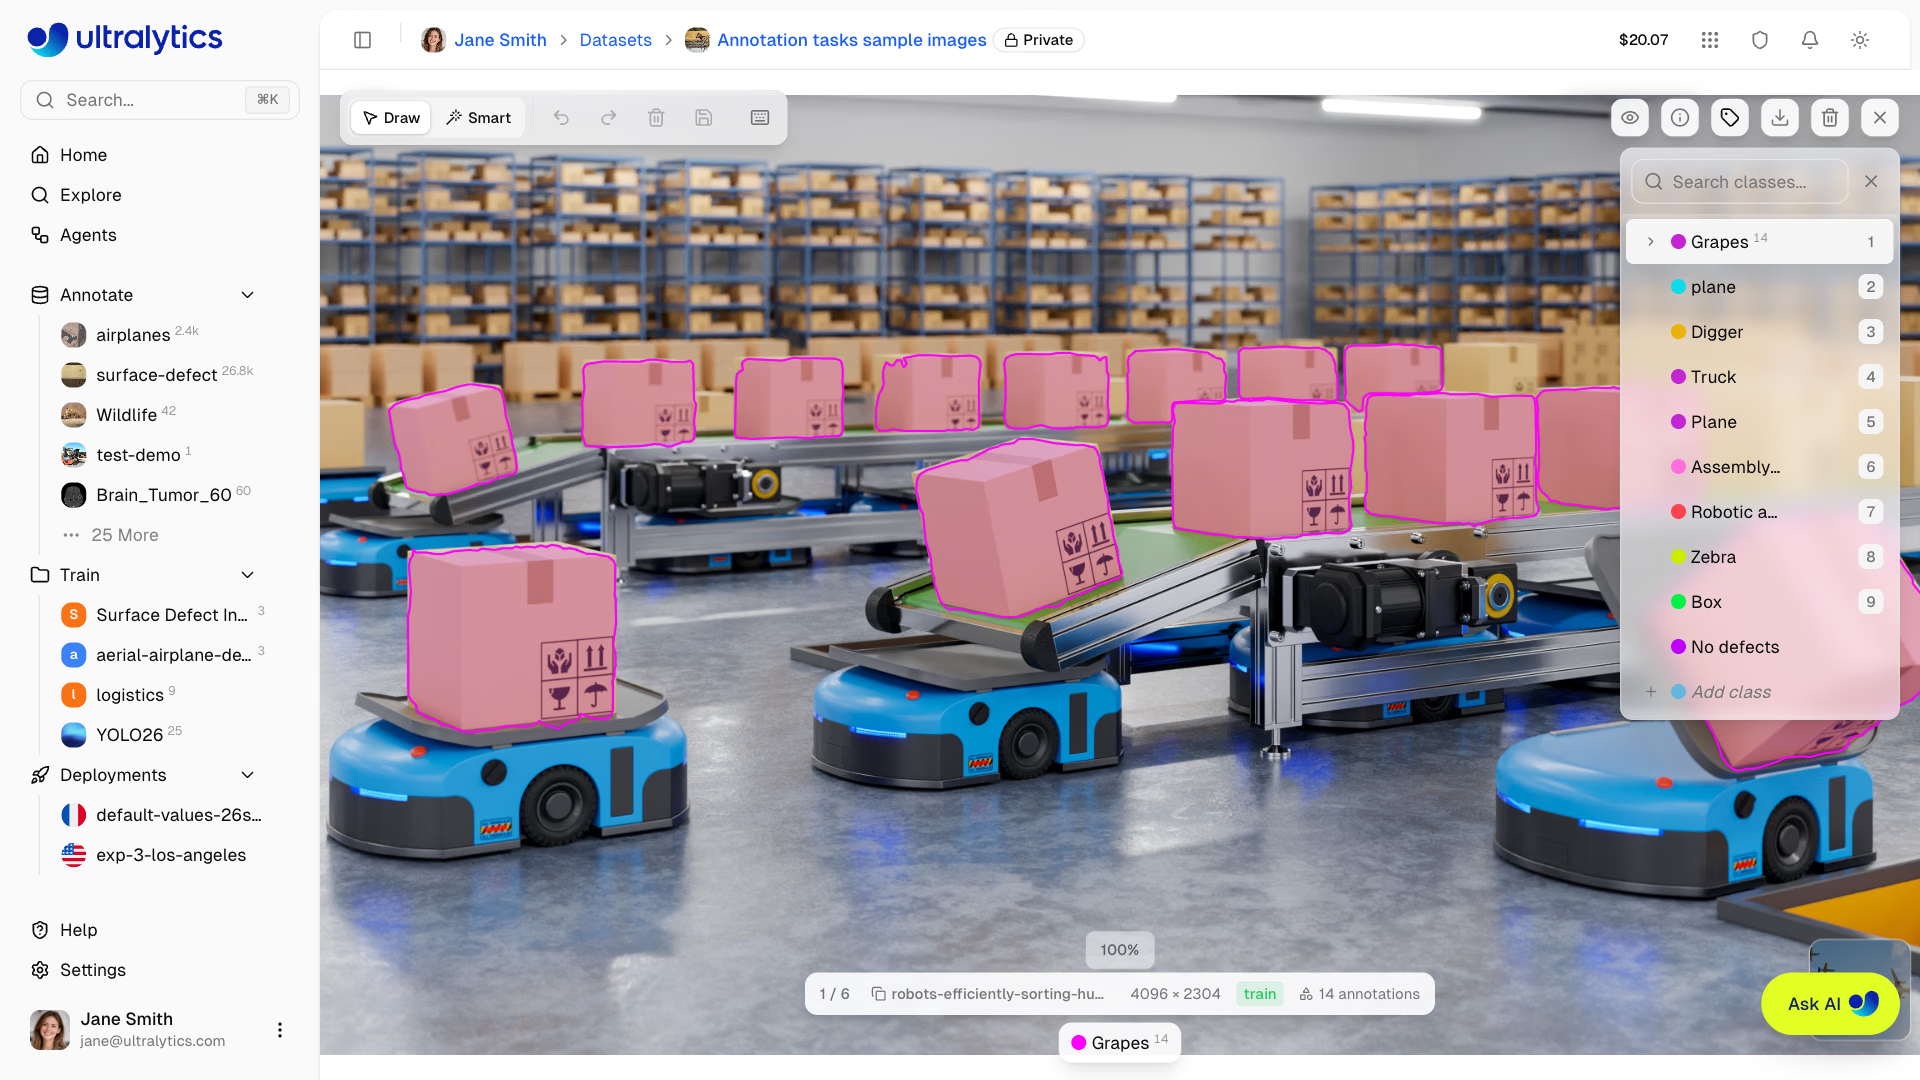
이 편집기의 클래스 패널을 살펴보세요. 상자 폴리곤 14개가 Grapes으로 저장되어 있고, 목록 아래에는 Box 클래스가 있으며 plane와 Plane도 서로 다른 두 개의 클래스로 존재합니다. 모든 행이 유효하므로 린터는 어느 문제도 찾아내지 못하지만, 가이드라인에 따라 라벨을 검토하는 사람은 두 문제를 몇 초 만에 알아챌 수 있습니다. 대부분의 라벨 오류가 이와 같습니다. 파일은 유효하지만 결정이 잘못된 것입니다.
어노테이터가 부주의해서 라벨을 잘못 지정하는 경우는 드뭅니다. 규칙이 모호하고 각자 합리적이지만 서로 다른 판단을 내리기 때문에 일관성이 깨집니다:
- 박스는 어디에서 끝나야 하나요? 그림자, 사람이 들고 있는 가방, 지게차 포크에 실린 화물 중 어디까지 포함하나요?
- 잘림. 프레임 밖으로 절반이 나간 사람도
person으로 라벨링해야 하나요? 어느 정도까지 보일 때 라벨링해야 하나요? - 가림. 바퀴 하나만 보이는 자동차도 라벨링하나요, 아니면 건너뛰나요?
- 클래스 경계. 픽업트럭은
car인가요, 아니면truck인가요? 스쿠터는bicycle인가요, 아니면other인가요? - 라벨링 금지 사례. 객체를 보여 주는 반사, 포스터, 화면입니다.
모두가 같은 선택을 한다면 어떤 선택이든 괜찮습니다.
한 페이지 분량의 가이드라인#
한 페이지 안에 들어가야 하며, 모든 규칙에 예시 이미지를 포함하고, 경계 사례를 먼저 다룹니다:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
교정 라운드에서 일치도 측정#
어노테이터 한 명에서 20명으로 규모를 늘리기 전에, 모두가 같은 이미지 50개에 라벨을 지정한 뒤 결과를 비교합니다:
일치도는 두 어노테이터가 같은 클래스로 그리고 IoU가 0.5 이상인 객체의 비율입니다. 이는 평가자 간 신뢰도를 실무적으로 측정하는 방법입니다:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%이 67% 안에는 두 종류의 불일치가 숨어 있습니다. Bob이 그린 지게차 박스는 80픽셀 더 위에서 시작합니다. 마스트 끝부분까지 포함했지만 IoU가 0.83으로 여전히 일치하므로, 일치로 계산됩니다. 제품에서 높이를 측정한다면 박스 규칙을 더 엄격하게 정하세요. 세 번째 객체는 실제로 의견이 갈린 사례입니다. Alice는 person이라고 하고 Bob은 pallet_jack이라고 합니다. 이 경우 더 명확한 규칙과 예시 이미지가 필요하고, 그다음 다시 라운드를 진행해야 합니다. 교정에 사용한 이미지 50개는 보관하세요. 새 어노테이터가 합류할 때마다 온보딩 테스트로 활용할 수 있습니다.
검토자가 조용히 라벨을 수정하면 피드백 루프가 사라지고, 어노테이터는 무엇을 잘못했는지 배우지 못합니다. 사유를 적어 반려하고 어노테이터가 수정하도록 하세요. 처음 100개 이미지에서는 더 느리지만, 그 이후에는 훨씬 빨라집니다.
추적할 항목#
| 지표 | 알 수 있는 내용 |
|---|---|
| 처리량(시간당 객체 수) | 처리 용량과 비용 |
| 거부율 | 품질이 저하되고 있는지 여부 |
| 공유 중첩 데이터셋에서의 일치도 | 어노테이터가 여전히 같은 규칙을 적용하는지 여부 |
일치도가 떨어지면 무언가 달라진 것입니다. 새 어노테이터, 새 카메라, 모호한 배치, 피로 등이 원인일 수 있습니다. 나중에 모델이 특정 조건에서 실패하면 해당 이미지를 다시 라벨링에 보내세요. 이 반복 과정을 능동 학습이 자동화하며, 실제 환경에서 정확도를 높이는 효과도 대부분 이 과정에서 얻을 수 있습니다. Ultralytics Platform의 데이터셋에서 실패 사례를 살펴보고 필터링하세요. 대규모로 이 과정을 운영하는 방법은 데이터셋 품질 관리와 어노테이션 모범 사례를 참조하세요.
정답 보기
10개 이미지로 교정 라운드를 진행한 뒤 작성한 medical-pills의 pill 클래스 가이드라인:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
일치도 점수를 해석하는 방법은 다음과 같습니다. 첫 번째 라운드에서 82%를 기록했다고 가정해 보세요. 일치하지 않은 객체를 원인별로 정렬합니다. 블리스터 포장에서는 흔히 두 가지 문제가 발생합니다. 태블릿이 아니라 플라스틱 포장 부분을 둘러싸도록 박스를 그리는 문제는 첫 번째 박스 규칙과 예시 이미지로 해결하고, 눈부심으로 가려진 태블릿을 한 어노테이터가 건너뛰는 문제는 두 번째 포함 규칙으로 해결합니다. 새로운 이미지 10개로 다시 실행하고, 점수가 90% 기준을 넘을 때만 규모를 확장하세요.