Выбери задачу и спланируй конвейер
Свяжи каждый вопрос о продукте с одной из семи задач Ultralytics YOLO, указав веса, поле результата, формат разметки и метрику для принятия решения, а затем подтверди план, запустив каждую задачу на одном изображении.
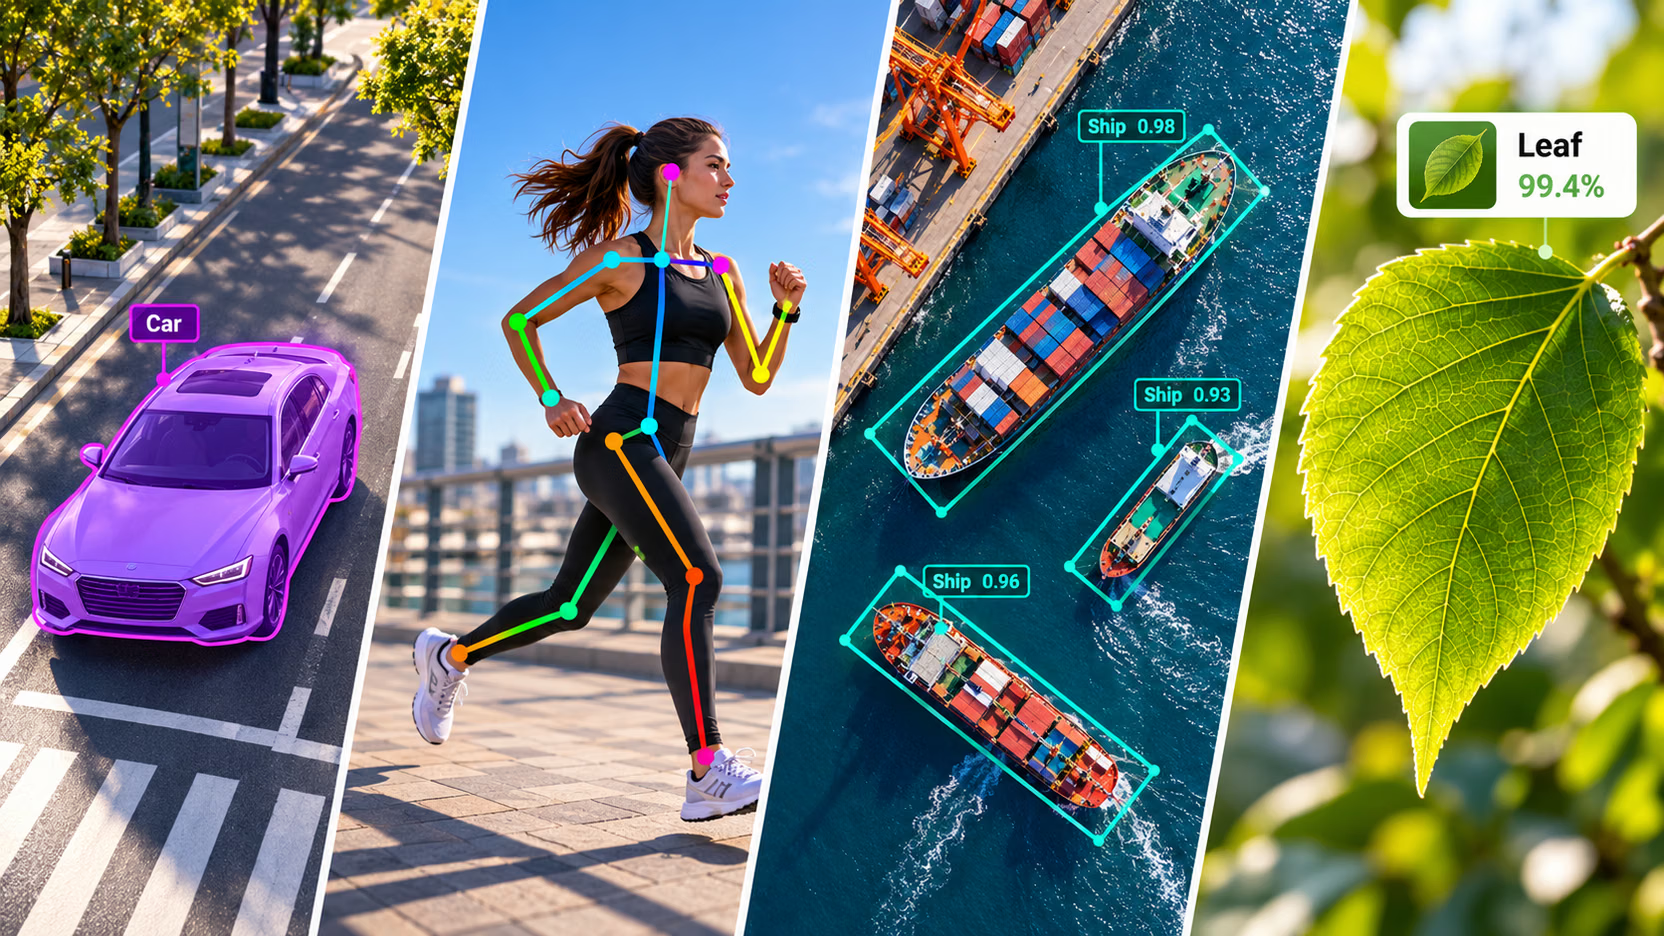
После выпуска детектора запросы редко сводятся к «больше рамок». Обычно спрашивают: «Какова площадь разлива?», «Согнута ли спина рабочего?», «В какую сторону направлен корабль?» и «Эта деталь бракованная?». На уличной фотографии, которую мы используем в этом курсе, ограничивающая рамка автобуса занимает 48% кадра, тогда как сам автобус — 29%, поэтому ответ о площади на основе рамки ошибся бы более чем в полтора раза. Выбранная задача определяет формат разметки, поэтому выбрать её до начала разметки — самое дешёвое решение в проекте; если изменить задачу позже, придётся размечать данные заново.
Практические занятия
Одна фотография — четыре разных ответа#

Задай один вопрос об одной фотографии — какую часть кадра занимает автобус и как далеко он находится? — и получи на него ответы от четырёх задач Ultralytics YOLO:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraРазберём всё по пунктам:
- detect отвечает на вопрос где. Рамка также захватывает дорогу под автобусом и четырёх человек перед ним, поэтому площадь получается на 63% больше реальной.
- segment отвечает на вопрос какую форму имеет объект. 29,2% — это реальная площадь автобуса на изображении; это значение нужно для любых правил расчёта площади, покрытия или перекрытия.
- semantic отвечает на вопрос какие пиксели относятся к каким классам. Площадь близка к площади маски, но модель обозначает автобус как
train: она присваивает поверхностям классы из обучающего набора данных (Cityscapes, урок 4) и никогда не разделяет отдельные автомобили. - depth отвечает на вопрос как далеко. Медианная глубина внутри маски автобуса составляет 4,5 м — две задачи вместе отвечают на вопрос, на который по отдельности не отвечает ни одна из них.
Если продукт сообщает площадь, долю покрытия или степень перекрытия, рамка — неподходящий инструмент. Используй маску (сегментация объектов) или карту классов (семантическая сегментация поверхностей).
Краткий обзор семи задач#
В курсе Основы компьютерного зрения подробно разбирается, как выбирать между задачами; если выбор неочевиден, вернись к разделу Семь задач компьютерного зрения. Здесь — краткое практическое повторение для остальной части курса. Каждый ряд соответствует задаче, которую установленный пакет ultralytics обучает, валидирует, запускает для предсказаний и экспортирует через один и тот же API; полное справочное описание смотри в обзоре задач.
| На какой вопрос отвечает результат | Задача | Веса YOLO26 | Поле результата | Формат разметки | Метрика для принятия решения |
|---|---|---|---|---|---|
| Где находится каждый объект? | detect | yolo26n.pt | boxes | класс + рамка | mAP50-95 для рамок |
| Каковы точная форма и площадь каждого объекта? | segment | yolo26n-seg.pt | masks + boxes | класс + полигон | mask mAP50-95 |
| К какому классу относится каждый пиксель? | semantic | yolo26n-sem.pt | semantic_mask | карта классов PNG или полигоны | mIoU |
| Где находятся суставы или ориентиры? | pose | yolo26n-pose.pt | keypoints + boxes | класс + рамка + ключевые точки | pose mAP50-95 (OKS) |
| Как повёрнут каждый объект? | obb | yolo26n-obb.pt | obb | класс + 4 угла | OBB mAP50-95 |
| Что изображено на всём изображении (или фрагменте)? | classify | yolo26n-cls.pt | probs | отдельная папка для каждого класса | точность top-1 |
| Как далеко от камеры находится каждый пиксель? | depth | yolo26n-depth.pt | depth | карта глубины для каждого изображения (16-битный PNG или NPY) | δ1 (delta1) |
Первую задачу ты уже используешь в продакшене. В уроках 2–8 разбираются пять следующих задач, а в уроках 9 и 10 они объединяются в цепочки и запускаются в продакшене. Последняя задача — монокулярная оценка глубины, которая предсказывает расстояние в метрах для каждого пикселя одного изображения. Для её разметки нужны датчики глубины или 3D-рендереры, а не аннотаторы, поэтому у неё собственный формат датасета; в этом курсе она включена везде, где используется общий рабочий процесс: в этом плане, цикле валидации и проверке экспорта в последнем уроке.
Рассматривай по одному вопросу за раз#
Пройди вопросы по порядку и остановись на первом ответе «да»:
Схема охватывает распространённые случаи. Для большинства остальных подойдут четыре дополнительных правила:
| Если запрос… | Выбери | Потому что |
|---|---|---|
| требует узнать и количество, и площадь («сколько разливов и какого они размера») | segment | семантическая сегментация объединяет соприкасающиеся объекты в одну область |
| касается длинных тонких объектов, расположенных вплотную друг к другу и снятых сверху | obb | ограничивающие рамки, выровненные по осям, перекрываются, и NMS отбрасывает настоящие объекты, даже если тебе никогда не понадобится угол поворота |
| требует определить, что находится спереди, а что сзади, или что слева, а что справа | pose | OBB задаёт ось, но не направление движения |
| по условию на каждом изображении виден ровно один объект (фиксированная инспекционная станция) | classify | самая дешёвая разметка и самая быстрая модель |
Задача фиксируется при создании датасета — на Ultralytics Platform это поле Task Type в окне создания нового датасета. Поэтому выбрать задачу нужно до первой разметки:

Один API, семь полей результатов#
Для всех задач используется один и тот же вызов; модель считывает свою задачу из файла весов. Меняется только то, какое поле результата заполняется, и именно его будет считывать твой код:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']Результаты сегментации и позы содержат boxes, поэтому уже имеющийся у тебя код детекции продолжит с ними работать. Результаты классификации, семантической сегментации и оценки глубины описывают всё изображение и вообще не содержат полей для отдельных объектов.
Код детекции, который перебирает result.boxes, при работе с моделью OBB останавливается с ошибкой TypeError: 'NoneType' object is not iterable: result.boxes — это None, а повёрнутые детекции находятся только в result.obb. Перенеси код детекции на OBB, считывая result.obb, а не проверяя None и получая ноль детекций.
Когда одной модели недостаточно#
Большинство производственных систем, решающих задачи помимо детекции, имеют одну из трёх архитектур:
- Сначала детекция, затем классификация. Детектор находит мелкие объекты на большом кадре; классификатор изображений анализирует каждый фрагмент в исходном разрешении и определяет его точную категорию: тип шлема, класс дефекта, артикул товара.
- Поза плюс трекинг. Ключевые точки описывают один кадр; трекер превращает их в временной ряд для каждого человека, по которому можно считать повторения упражнений или выявлять падения.
- Сначала сегментация, затем измерение. Модель возвращает пиксели, а обычный код преобразует их в площади, ширину, коэффициенты покрытия или расстояния (если использовать оценку глубины).
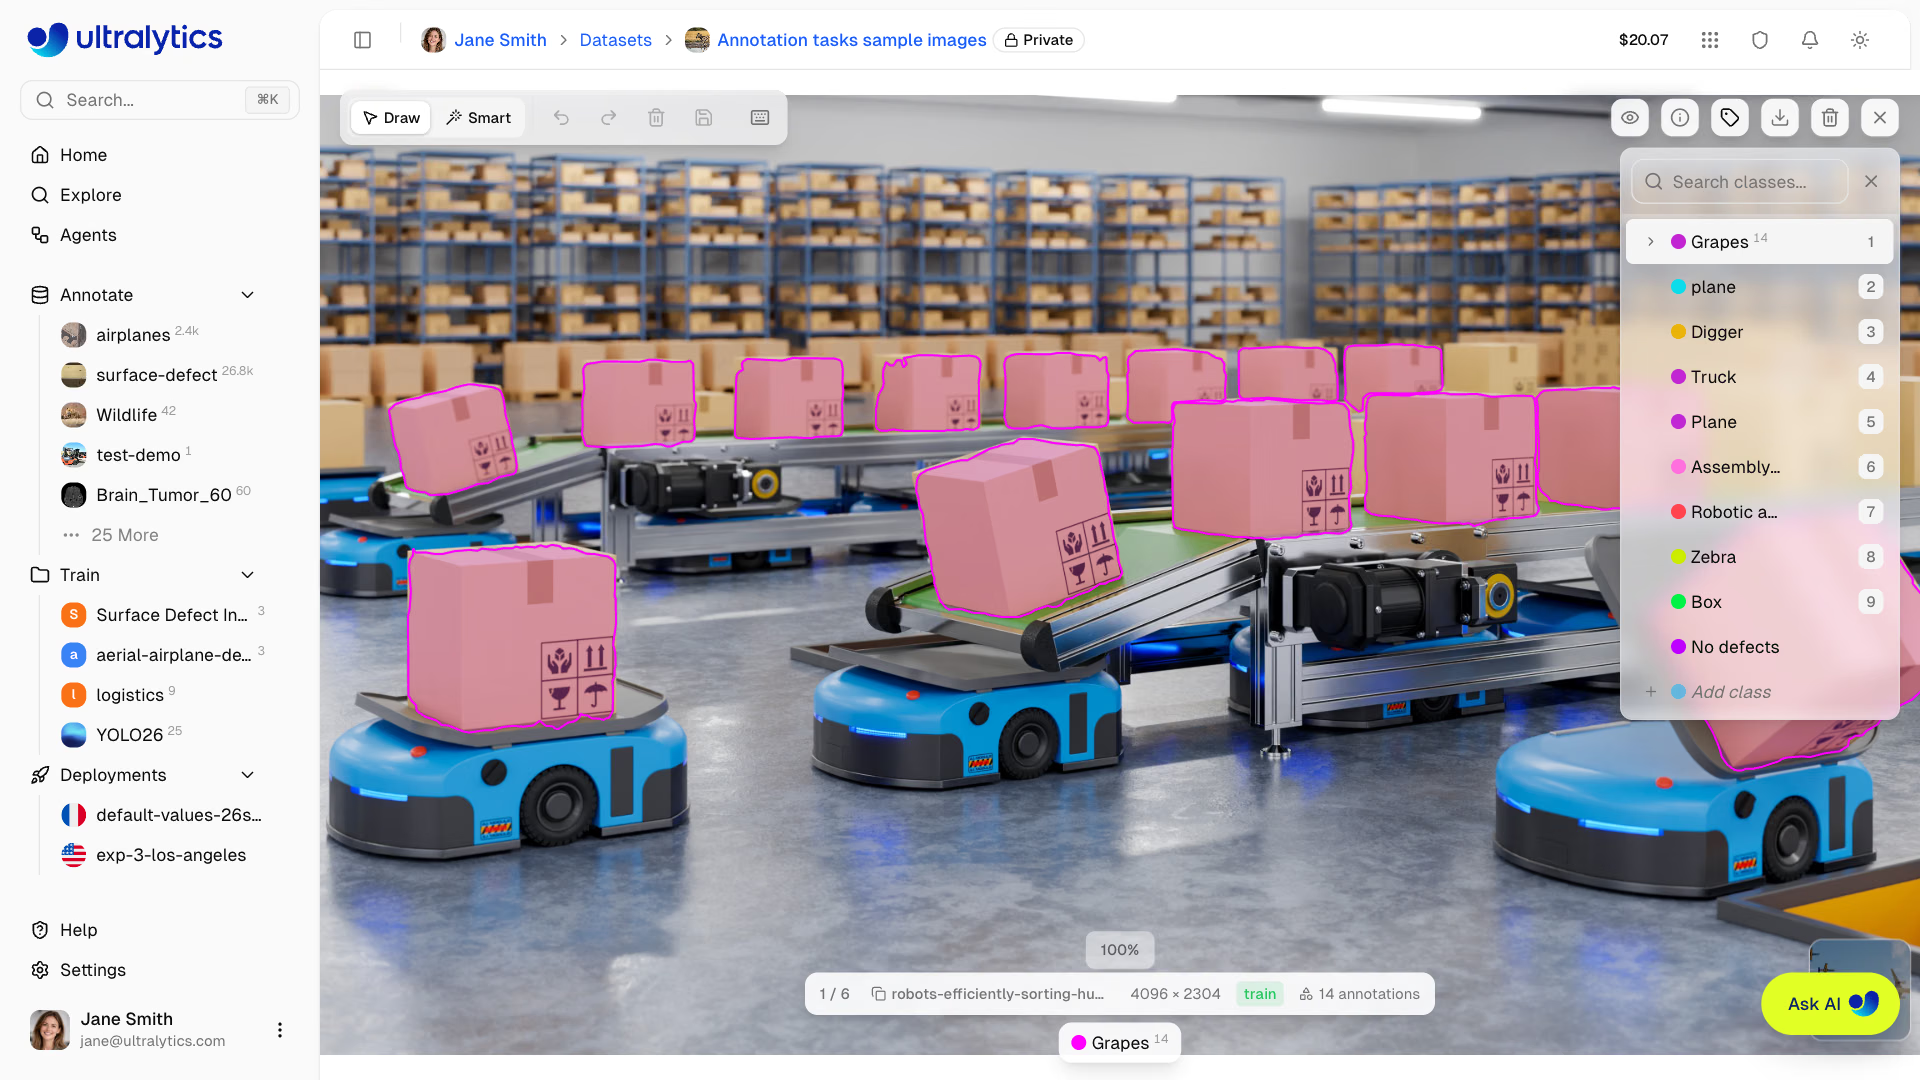
Для конвейера «сегментация, затем измерение» нужна разметка в виде одного полигона для каждого объекта, как на примере этих посылок на складских роботах в редакторе Ultralytics Platform:
Вторая модель увеличивает задержку инференса, требует разметки и поддержки второго датасета, а также мониторинга второй модели. Создавай цепочку моделей, только если одна задача не позволяет получить ответ: план с одной моделью, которую можно выпустить, лучше плана с тремя моделями, которые невозможно разметить.
Подводные камни#
Симптом: команда размечает полигоны, потому что маски эффектно выглядят в демо, а продукт в итоге использует только количество объектов. Решение: до разметки укажи строку кода, которая использует результат. Если никакой код не обращается к контуру, выпускай детектор: рамки размечать и обрабатывать быстрее.
Симптом: после месяца разметки кто-то замечает, что продукту нужно направление, а в датасете есть метки OBB, которые дают только ось. Решение: укажи в плане точный атрибут (result.masks.xy, result.keypoints.xy, result.obb.xywhr) и запусти tasks.py с выбранными весами до начала разметки.
Симптом: классификатор, показывающий точность 95% на чистых фотографиях товара, ошибается на большинстве обрезанных изображений детектора в рабочей среде. Решение: создай датасет для второй стадии из кропов самой первой стадии, сохранив реальное размытие и кадрирование; в уроке 9 показано как.
Показать решение
Для запроса о палетах:
| Строка | Выбор |
|---|---|
| Вопрос | Выступает ли какая-либо часть палеты за линию балки стеллажа? |
| Задача | segment — чтобы определить выступающую часть, нужен контур палеты; рамка также охватывает пространство под палетой и груз сверху |
| Веса | yolo26n-seg.pt, дообученная на кадрах со складских камер |
| Формат разметки | Один полигон для каждой палеты |
| Поле результата | result.masks.data с retina_masks=True (пиксели за линией балки) |
| Метрика для принятия решения | Mask mAP50-95 на камере, кадры с которой не использовались при обучении |
| Второй этап | Ничего — линия балки фиксирована для каждой камеры, поэтому это конфигурация, а не модель |
Правило свеса реализуется всего тремя строками кода: один раз для каждой камеры нарисуй линию балки, подсчитай пиксели маски по неправильную сторону от неё и подавай сигнал, если их число превышает порог, откалиброванный по нескольким известным свесам. В уроке 3 показан именно такой тест маски относительно области.