Семантическая сегментация: разметка каждого пикселя
Предсказывай карту классов для каждого пикселя с помощью yolo26n-sem.pt, преобразуй её в показатели покрытия, создавай наборы данных с картами классов PNG и анализируй mIoU, не поддаваясь обманчивым значениям точности по пикселям.
На некоторые вопросы нельзя ответить подсчётом объектов: насколько перекрыт тротуар, сколько сорняков на поле, где заканчивается проезжая часть. Семантическая сегментация отвечает на них, присваивая каждому пикселю один ID класса. Однако её ключевую метрику легко неверно истолковать: модель, которую ты обучишь в этом уроке, показывает точность по пикселям 91%, но не находит ни одного человека.
Практические занятия
Экземплярная или семантическая?#
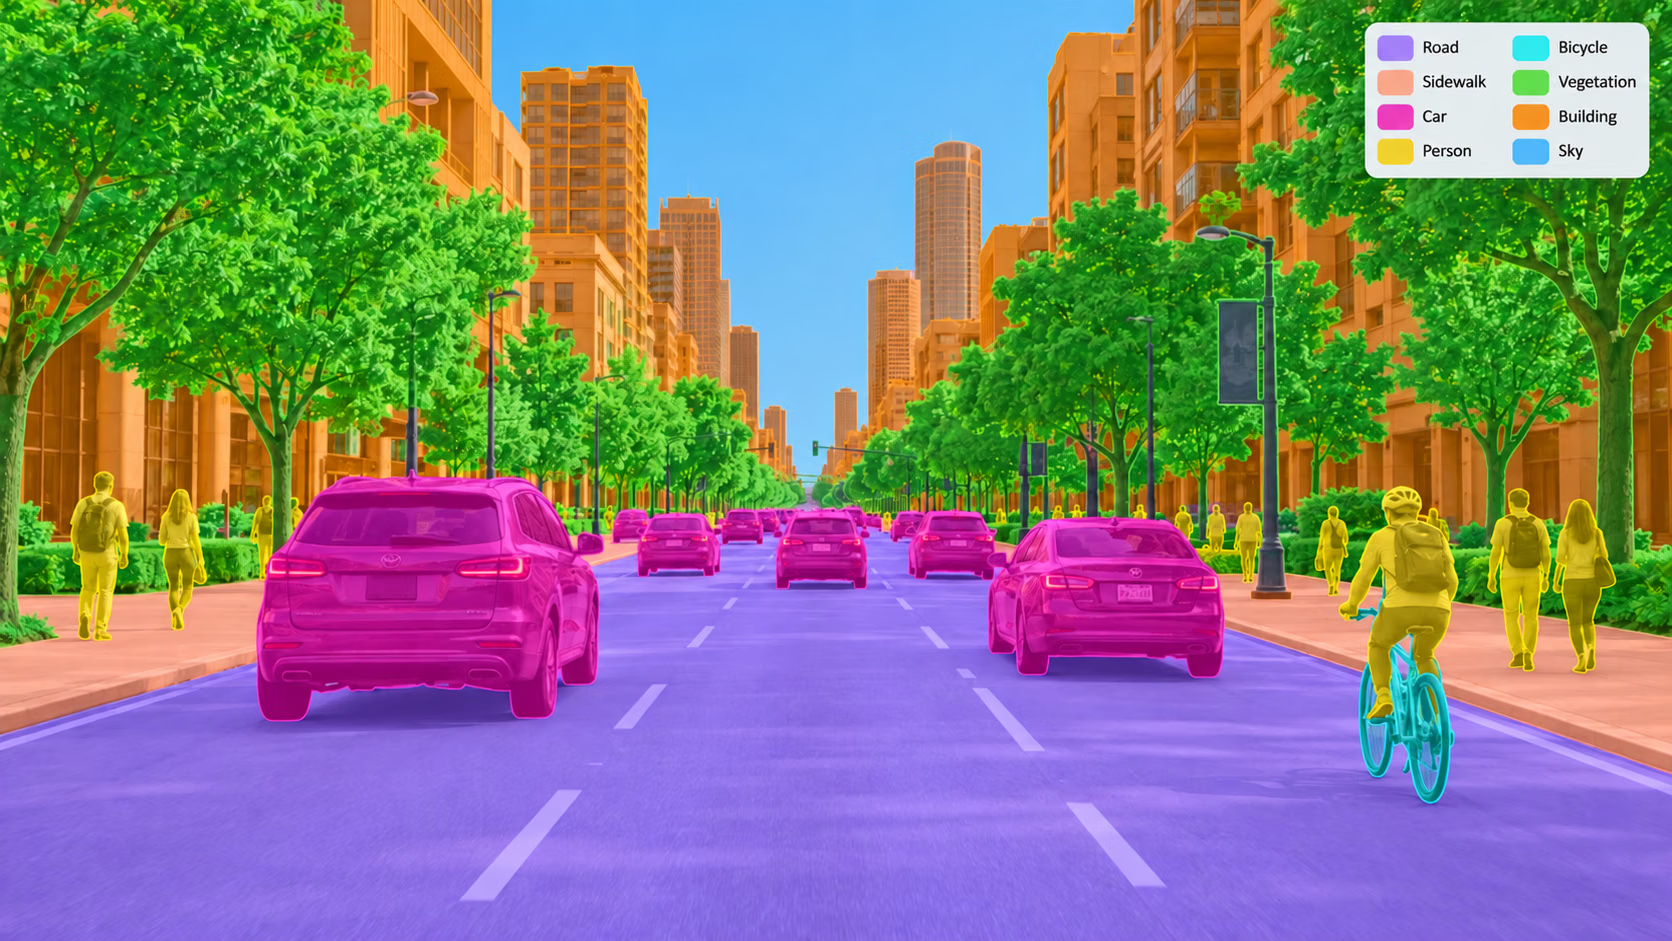
Экземплярная сегментация (segment) | Семантическая сегментация (semantic) | |
|---|---|---|
| Результат | одна маска на объект и рамка | один ID класса на пиксель |
| Подсчитывает объекты | да | нет — две соприкасающиеся машины образуют одну область класса «автомобиль» |
| Работает с «фоновыми» классами (дорога, небо, трава) | плохо — у них нет естественных экземпляров | да |
| Разметка | полигоны | карты классов PNG или полигоны |
| Метрика для принятия решения | mask mAP50-95 | mIoU |
| Предобученные веса | yolo26n-seg.pt (COCO, 80 классов) | yolo26n-sem.pt (Cityscapes, 19 классов) |
Если следующий этап должен ответить на вопрос «сколько?», используй сегментацию экземпляров. Если вопрос звучит как «сколько?» о площади или «где?», семантическую сегментацию проще размечать и использовать. На странице задачи семантической сегментации есть таблица моделей.
Предсказание карты классов#
result.semantic_mask.data — это тензор H × W в исходном размере изображения; каждое значение — ID класса, а 255 означает «игнорировать». result.summary() преобразует его в доли пикселей для каждого класса:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Посмотри на последнюю строку. В Cityscapes есть класс bus, но модель определяет автобус как train. Модель обучалась на кадрах с автомобильных камер, снятых преимущественно на улицах Германии, а автобус, снятый с тротуара крупным планом, не соответствует этому распределению данных. Семантические модели сильнее детекторов зависят от ракурсов и определений классов в обучающем наборе — это смещение набора данных. Поэтому, прежде чем доверять карте, дообучи модель на данных с собственной камеры.
Преврати карту классов в ответ#
Карта классов превращается в числовой показатель продукта с помощью обычных сравнений тензоров. Вот ответ на вопрос: «какая часть области, по которой пойдёт пешеход, приходится на дорогу или тротуар, а какая — на людей?»:
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personЧтобы этим числам можно было доверять, придерживайся трёх правил:
- Получай ID по названию из
result.names, а не из жёстко заданного числа: модель, обученная на собственных классах, присвоит им другие номера. - Ограничивайся нужной областью. Доли для всего кадра включают небо и здания; сначала вырежи область из карты классов или умножь её на маску области.
- Открой наложение.
semantic_overlay.jpgсразу показывает, действительно ли «дорога», которую учитывает показатель, является дорогой.
Формат набора данных#
В семантических наборах данных каждому изображению соответствует одноканальная маска, пиксели которой содержат ID классов. Справочник — руководство по семантическим наборам данных; структура повторяет images/ файл за файлом:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
В YAML добавляется masks_dir, а если ID в твоих масках отличаются от ID классов для обучения, ещё и блок label_mapping:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
В масках Cityscapes хранятся исходные ID меток от -1 до 33; при сопоставлении сохраняются 19 из них, а остальные переводятся в ignore_label, который хранится как 255. Пиксели со значением 255 исключаются и из функции потерь, и из метрик — используй то же значение для областей, разметку которых аннотаторы не смогли определить.
Если у тебя уже есть разметка полигонами, но нет masks_dir, загрузчик самостоятельно растеризует полигоны и добавит класс background для незаполненных пикселей.
Сжатие с потерями смешивает значения соседних пикселей, из-за чего граница между классами 7 и 8 превращается в смесь значений 7, 8 и несуществующих ID. Сохраняй каждую маску в PNG или TIFF.
Обучение и анализ mIoU#
Cityscapes8 содержит 8 изображений городских сцен: 4 для обучения и 4 для валидации. Этого достаточно для быстрой проверки на CPU:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Строки для отдельных классов опущены.) Точность по пикселям показывает 91%; mIoU — 42%; строки по отдельным классам показывают, что модель не нашла ни одного человека. Все три утверждения верны. Дорога, здание и растительность занимают большую часть пикселей — на одну только дорогу приходится 78,529 из 192,315. Поэтому модель, которая хорошо распознаёт эти классы, показывает высокую точность по пикселям, даже если пропускает все небольшие классы. mIoU усредняет IoU классов с одинаковым весом, поэтому каждый пропущенный класс снижает показатель.

Оценивай и mIoU, и IoU классов, на действия с которыми опирается твой продукт. Если IoU класса «пешеход» равен 0, функция обеспечения безопасности пешеходов не работает — независимо от точности по пикселям.
Показать решение
В нашем запуске: mIoU 0.415, точность по пикселям 0.906, IoU 0 для стены, человека, велосипедиста, мотоцикла и велосипеда, а также для каждого класса, отсутствующего в четырёх валидационных изображениях.
Точность по пикселям выше, потому что при её расчёте учитываются пиксели, а дорога, здания, растительность и небо занимают большую часть каждого кадра Cityscapes. При расчёте mIoU все классы имеют одинаковый вес, поэтому пять пропущенных небольших классов снижают среднее значение, хотя на них приходится всего несколько сотен пикселей. Для продукта, который должен реагировать на людей, эта модель не проходит проверку уже по одному IoU класса «человек».