Обучи классификатор изображений
Подготовь датасет в виде папок, обучи yolo26n-cls.pt на MNIST160, считай вероятности и точность top-1, а предсказания с низкой уверенностью направляй на проверку человеком.
Классификация изображений отвечает на один вопрос для каждого изображения: что на нём? Для неё нужны самые простые метки среди всех задач — названия папок, — и она работает быстрее всего. Поэтому это стандартный второй этап после детектора и подходящая первая модель для станции контроля, которая видит одну деталь в кадре. В датасете не нужен YAML: его роль выполняет структура папок. Классификатор всегда выдаёт ответ, даже для изображений, на которые он никогда раньше не смотрел. Понимание того, когда ему не стоит доверять, — половина задачи.
Практические занятия
Структура папок датасета#
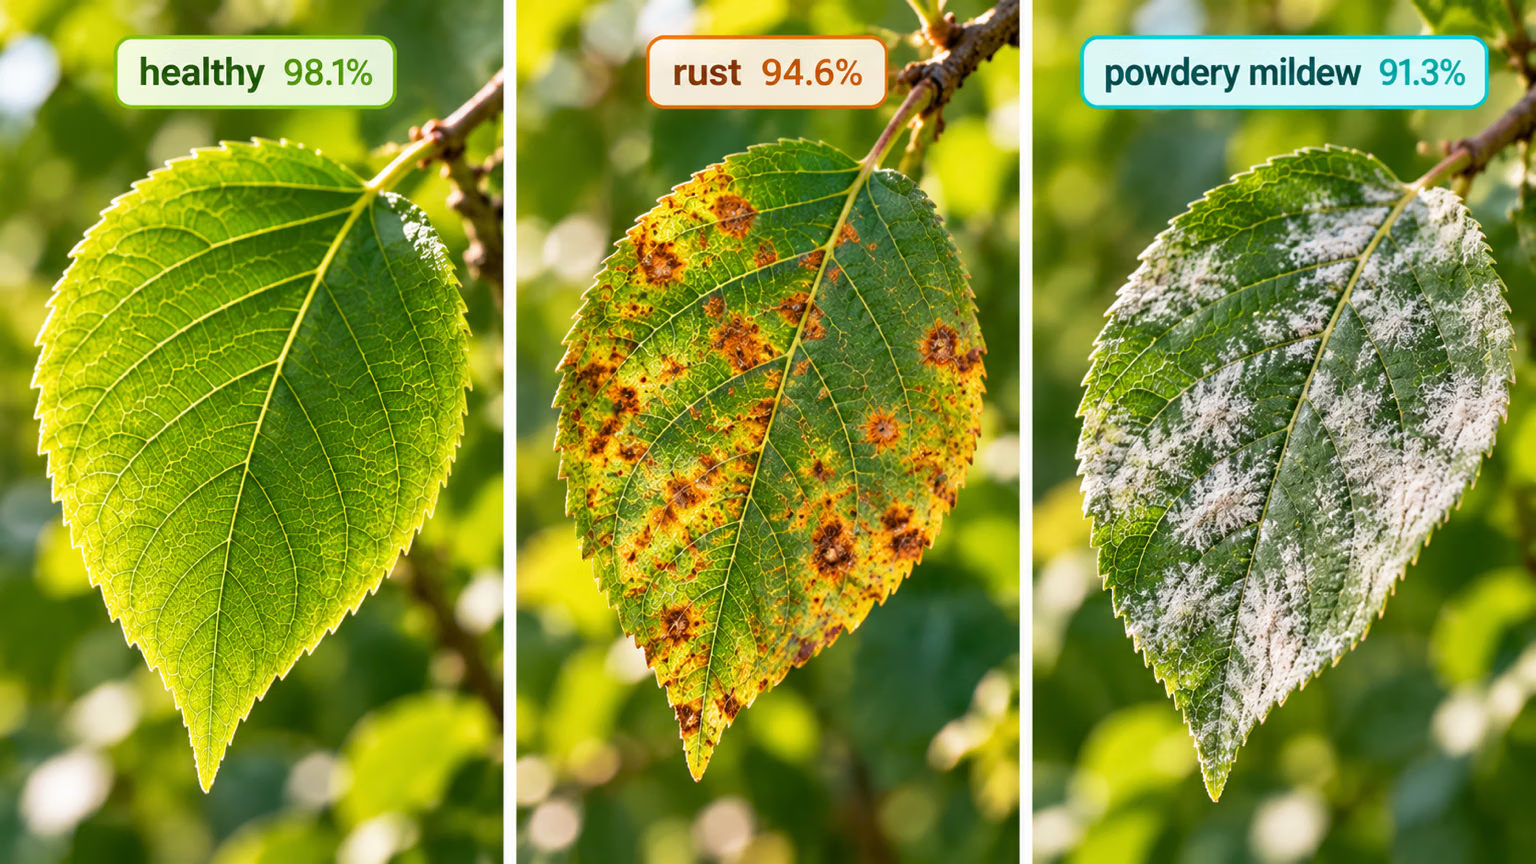
Датасеты для классификации — это каталоги, а не YAML-файлы. Укажи в data= путь к корневой папке:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Что загрузчик с ней делает — согласно установленному исходному коду и руководству по датасетам для классификации:
| Ситуация | Поведение |
|---|---|
| Индексы классов | названия папок в train/, отсортированные по алфавиту → dent=0, good=1, scratch=2 |
| Папка для валидации | val/, затем validation/, затем valid/; если они отсутствуют, используется test/ с предупреждением |
Папки train/ нет, есть только папки классов | автоматически делит данные в пропорции 80/20 на train/ и val/ |
На платформе Ultralytics датасет для классификации содержит одну метку на уровне изображения для каждого изображения, а не фигуры:
Симптом: после добавления класса старая интеграция сообщает, что части good — это dent. Причина: добавление папки с именем bent ставит её первой при сортировке и сдвигает все последующие индексы. Решение: всегда сопоставляй индексы с именами с помощью model.names (или result.names); никогда не задавай индекс жёстко.
Обучение на MNIST160#
MNIST160 содержит 160 рукописных цифр: 80 в train/ и 80 в test/; они распределены по десяти папкам с цифрами — этого достаточно для быстрой проверки на CPU. Папки val/ нет, поэтому обрати внимание на предупреждение загрузчика и переход к test/:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Одна эпоха почти не меняет новую голову для десяти классов. В нашем запуске epochs=10 достигла top-1 0.55 и top-5 0.95 примерно за десять секунд на CPU ноутбука — цикл работает, просто ему нужно больше эпох. В руководстве по задаче классификации перечислены размеры предварительно обученных моделей.
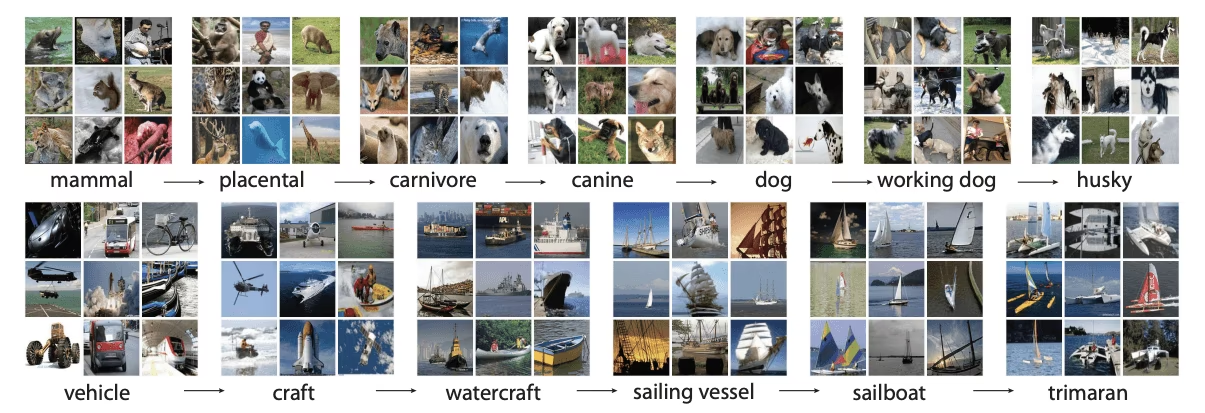
Top-1 — доля изображений, для которых класс с наибольшей вероятностью указан правильно. Top-5 засчитывает правильный ответ, если нужный класс входит в пятёрку классов с наибольшими вероятностями. Top-5 полезна для ImageNet с 1 000 классов, от общих до очень узких категорий; при пяти классах или меньше её значение всегда равно 1.0, а при десяти она малоинформативна. Ориентируйся на точность top-1 и матрицу ошибок по классам.
Считывание вероятностей в коде#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 — это индекс, probs.top5 — список индексов, а probs.data — полный вектор вероятностей. Обрати внимание на уверенность top-1: значение 0.52 лишь немного выше шанса угадать, подбросив монету между minibus и police_van. Именно на основе этого числа ты выбираешь маршрут.
Направляй сомнительные предсказания человеку#
Классификатору в рабочей системе редко нужно правильно классифицировать каждое изображение; важно, чтобы он правильно классифицировал изображения, по которым принимает решение самостоятельно. Этот скрипт обучает модель 10 эпох, а затем оценивает, как разные пороги уверенности повлияют на 80 отложенных изображений цифр:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Каждая строка отражает компромисс: повышение порога увеличивает точность принятых предсказаний и отправляет больше изображений человеку. При пороге 0.6 эта модель самостоятельно обрабатывает только 10 из 80 цифр — она ещё не готова что-либо автоматизировать; поможет дополнительное обучение, а не более хитрый порог. Повторяй ту же проверку после каждого цикла обучения: она покажет и ожидаемую точность, и точный объём работы на проверке при каждом пороге.
Выбери самый низкий порог, при котором точность на принимаемых изображениях соответствует твоим требованиям, измерив её на отложенных данных. Затем проверь, справится ли команда с объёмом проверки, который он создаёт; если нет — улучши модель.
Подводные камни#
Симптом: пустая рабочая станция, неподходящая деталь или рука перед объективом получают уверенную метку класса. Причина: вероятности softmax всегда в сумме дают 1, поэтому классификатор неизменно выбирает один из своих классов. Решение: добавь папку other/, содержащую только такие изображения, и отправляй предсказания с низким top1conf на проверку.
Симптом: до обучения предобученная модель почти не набирает баллов на твоём датасете. Причина: yolo26n-cls.pt предсказывает 1 000 индексов ImageNet, а в твоих папках индексам 0–9 соответствуют другие значения: в MNIST160 папка 0 имеет индекс 0, которому предобученная голова присваивает значение tench. В таком случае мы измерили top-1 0.000. Решение: сначала выполни дообучение, затем проводи валидацию.
Симптом: top-1 при валидации близок к 1.0, а в рабочей среде результат намного хуже. Причина: почти одинаковые фотографии одной и той же детали есть и в train/, и в val/. Решение: раздели данные по деталям или сеансам, как описано в статье Как правильно разделить датасет.
Классификаторы предварительно обучены для размера imgsz=224, а не 640. Если на большом кадре есть маленькие объекты, лучше использовать детекцию с последующей классификацией (следующий урок), чем увеличивать imgsz.
Показать решение
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Результаты наших запусков: 1 эпоха → top-1 0.162, top-5 0.463; 10 эпох → top-1 0.550, top-5 0.950. При пяти классах правильный ответ всегда входит в топ-5, поэтому top-5 по определению равна 1.0 и ничего не говорит о качестве модели.
Для точности 75% на принятых изображениях route.py рекомендует порог 0.6 (точность 80% на 10 принятых изображениях); при этом 70 из 80 цифр отправляются на проверку. Вот честный ответ: порог соответствует требованию к точности, но модель пока бесполезна. Прежде чем выбирать порог для реальной задачи, обучи модель дольше и повтори проверку.