Правильно раздели датасет
Оцени, насколько случайное разделение приводит к утечке данных, разделяй целые группы — например, клипы, камеры или дни — с помощью скрипта, проверяй наличие всех классов и зафиксируй тестовую выборку.
Неаккуратное разделение даёт метрику, которой ты доверяешь, хотя она не отражает реальность. Если соседние кадры видео попадают и в train, и в val, mAP на val измеряет запоминание, а не способность к обобщению; разрыв проявляется только в продакшене. Каждое сообщаемое тобой число о модели зависит от этого разделения, поэтому выбери его осознанно один раз и больше не меняй.
Практические занятия
Три выборки — три задачи#
| Выборка | Типичная доля | Назначение |
|---|---|---|
| Train | 70% | На этой выборке модель обучает веса |
| Val | 15% | Выбрать лучшую эпоху, сравнить запуски, настроить параметры |
| Test | 15% | Единственная итоговая проверка go/no-go по критериям приёмочного тестирования |
В руководствах Ultralytics рекомендуется выделять 70–80% на train и по 10–20% на val и test: этапы проекта компьютерного зрения предлагают по 10–15% на каждую, а в руководстве по предобработке используется пропорция 70/20/10. Считай доли не только в объектах, но и в изображениях: на одном изображении с большим количеством объектов может быть больше меток, чем на десяти разреженных. Точные проценты гораздо менее важны, чем назначение каждой выборки.
Случайное разделение приводит к утечке данных при коррелирующих данных#
Кадры 124 и 125 одного клипа почти идентичны. Если один попадёт в train, а другой — в val, оценка val будет учитывать изображения, которые модель фактически уже видела. Проверь это на тренировочной выборке из раздела Собери качественные и репрезентативные данные; имена файлов должны начинаться с ключа группы «камера-день»:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in trainКаждая группа «камера-день» из val также представлена в train. На реальных видеозаписях это означает, что кадры val имеют то же освещение и фон, что и кадры train, а часто содержат и те же объекты. Поэтому mAP на val выглядит отлично, а в продакшене — нет.
Выбери единицу разделения#
Выбери группу, соответствующую требованиям к обобщению в целевой среде:
Если сомневаешься, разделяй по наиболее общей единице, которую можешь себе позволить: так ты получишь наиболее честную оценку. Случайное разделение по изображениям безопасно, только когда каждое изображение получено независимо, например фотографии товаров, сделанные с интервалом в несколько недель.
Раздели данные по группам с помощью кода#
Этот скрипт назначает целые группы выборкам, пока каждая не достигнет своей доли 70/15/15, записывает списки файлов, которые принимает YAML-файл данных, и сообщает о представленности классов:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missingКак это читать:
- Ни одна группа не пересекает границы выборок — это обеспечено самим способом разделения. Утечка устранена.
- В val всего 2 группы, и в ней отсутствуют 36 классов, поэтому AP для них нельзя измерить. При 71 классе на 128 изображениях никакое начальное значение не решит проблему; нужно собрать больше групп (снять на большем количестве камер или в дополнительные дни). Именно это и обеспечивает производственный датасет, содержащий более 1 500 изображений на класс.
- В train отсутствуют 5 классов, которые представлены только в val или test. Модель не сможет обучиться распознавать их на этой выборке.
Правило принятия решения: если в выборке отсутствует класс, добавь или перемести целые группы, в которых он представлен, но не отдельные кадры — иначе утечка данных появится снова. Укажи в YAML-файле данных пути к трём файлам .txt в ключах train, val и test; в разделе Создай YAML-файл датасета описаны остальные поля файла.
Сбалансируй классы в выборках#
Для классификации train_test_split(..., stratify=labels) из scikit-learn выравнивает доли классов в выборках одним аргументом. На изображениях для детекции часто встречаются сразу несколько классов, поэтому балансируй данные на уровне групп: после group_split.py сравни количество объектов каждого класса в выборках и меняй целые группы местами, пока доля каждого класса не окажется в пределах примерно ±20% от ожидаемой.

В Ultralytics Platform функция Redistribute Splits случайно перераспределяет изображения, а кнопка Auto задаёт рекомендуемое разделение 80/20 для train/val (документация по разделению). При этом удаляются точные дубликаты изображений, но функция не учитывает группы. Поэтому используй её для независимых снимков, а данные с группировкой загружай уже разделёнными, если работаешь с видео или данными с нескольких камер.
Веди учёт двух наборов val отдельно#
Часто нужны два набора val: стабильный, тщательно отобранный набор для регрессионных проверок и набор, отражающий реальные условия продакшена и обновляемый новыми кадрами. YAML-файл данных принимает список папок val, но объединяет их в один набор с одной оценкой:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
Чтобы видеть оценку для каждого набора, создай отдельный YAML-файл данных для каждого набора val (одинаковые train и names, разные val) и оцени обученные веса на каждом из них:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
Снижение оценки на тщательно отобранном наборе означает регрессию; снижение оценки на наборе, отражающем условия продакшена, — сдвиг домена.
Зафиксируй тестовую выборку#
Самая дорогая ошибка при разбиении данных — сравнить на тестовой выборке десять вариантов модели. Как только тест повлиял на любое решение, итоговый показатель становится завышенным. Настраивай модели и сравнивай запуски на val, а приёмочное тестирование на test проводи один раз в самом конце.
Каждая опубликованная метрика привязана к этому разбиению. Если позже перемешать данные заново, изменятся все показатели, и старые и новые запуски будет нельзя сравнить. Храни вместе с набором данных единицу разбиения, начальное значение генератора и списки файлов для всех трёх частей.
К-кратная кросс-валидация для небольших датасетов#
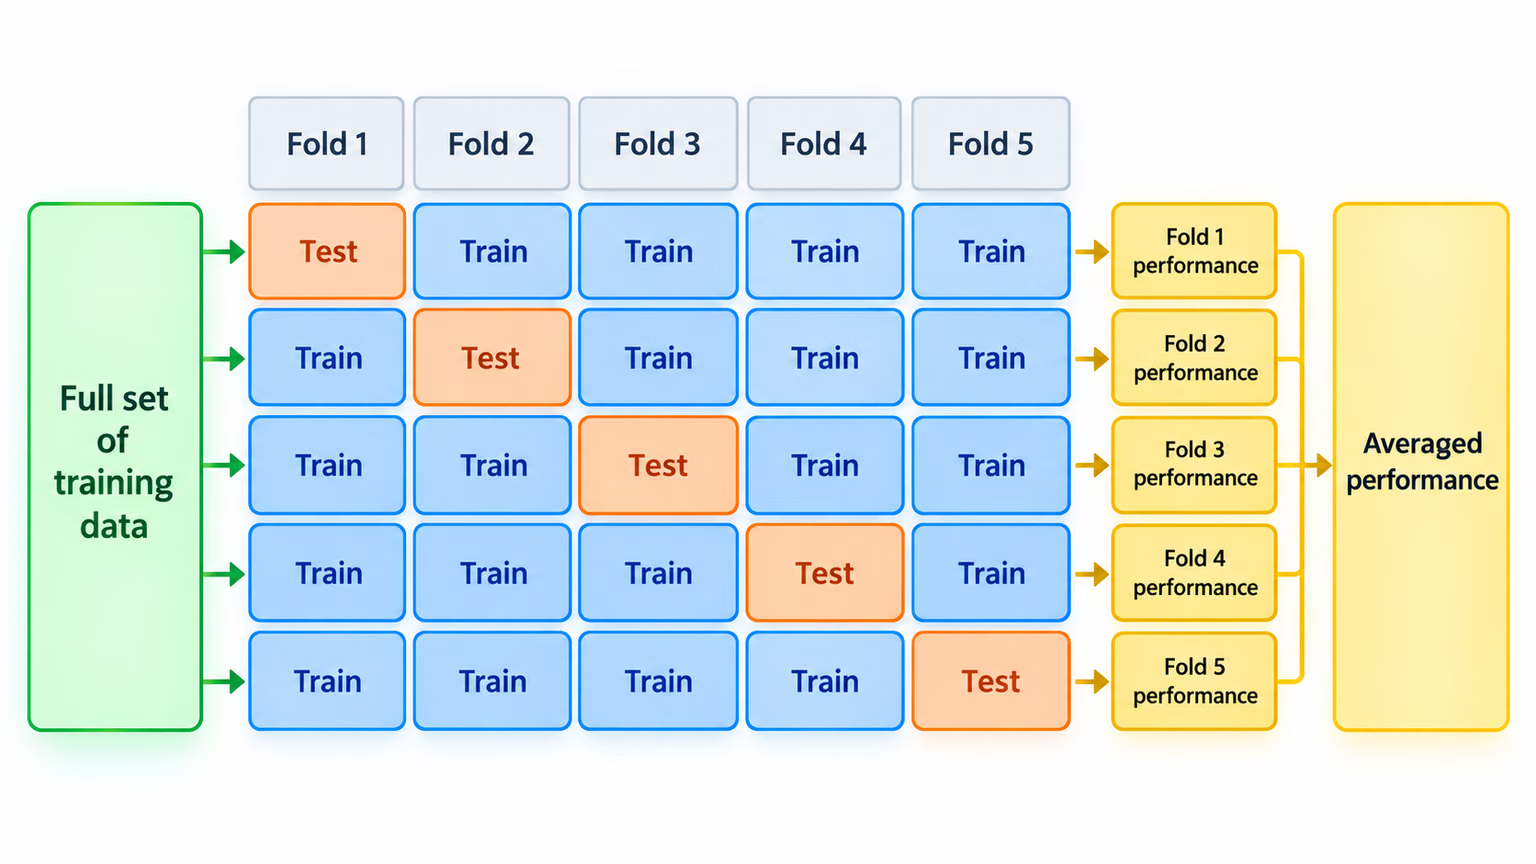
Если датасет небольшой (менее примерно 500 изображений на класс) и одно разделение кажется статистически ненадёжным, K-кратная кросс-валидация обучает k моделей на чередующихся разделениях и усредняет результат: вычислений потребуется в k раз больше, зато оценка будет гораздо стабильнее. Сформируй части по группам тем же способом, иначе утечка возникнет в каждой части.
Показать решение
Для стационарных складских камер, которые должны исправно работать в новые дни, разделяй данные по группам «камера-день»: cam2_2026-05-01. После group_split.py убедись, что ни одна группа не пересекает границы выборок:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: noneПробное разделение проходит проверку на утечку данных, но не проходит проверку представленности классов: в val отсутствуют 36 из 71 класса. Решение — план сбора данных, а не перераспределение. Сними материал ещё как минимум в два дня на камерах для val и test; в каждый день должны быть представлены классы, наиболее важные согласно спецификации. Затем запусти оба скрипта снова.