Первое дообучение и цикл итераций
Дообучи предобученные веса YOLO26 с настройками по умолчанию, ранжируй классы по AP с подсчётом пропусков и путаницы, а затем преврати самый слабый класс в следующую задачу по исправлению датасета.
В этом уроке учебный запуск показывает 0.66 mAP50, что похоже на проблему с темпом обучения. Но таблица по классам говорит об обратном: в val у cup есть 14 размеченных объектов, и модель не находит ни одного. Это проблема с данными, и никакая настройка гиперпараметров её бы не решила. Используй первый запуск как диагностику, которая подскажет, какой класс исправлять следующим.
Практические занятия
Начни с предобученных весов#
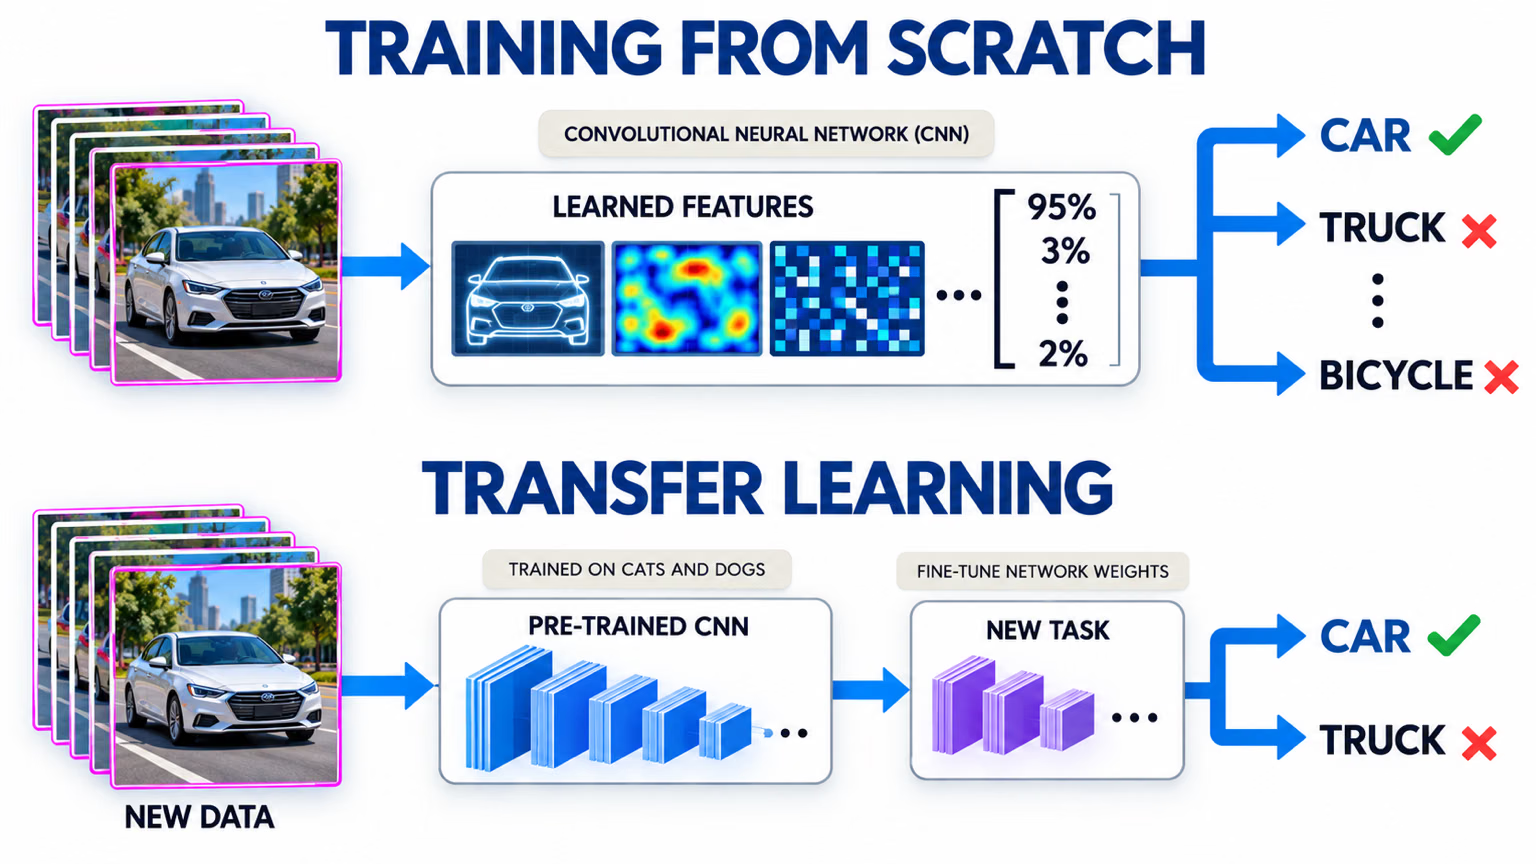
Дообучение начинается с весов, которые уже распознают границы, текстуры и формы, поэтому модель сходится быстрее и требует гораздо меньше данных, чем при обучении со случайными весами. Выбери чекпойнт YOLO26, подходящий для твоей задачи:
| Задача | Предобученный чекпойнт | На чём предобучена модель |
|---|---|---|
| Обнаружение | yolo26n.pt | COCO |
| Сегментация | yolo26n-seg.pt | COCO |
| Семантическая сегментация | yolo26n-sem.pt | Cityscapes |
| Поза | yolo26n-pose.pt | Ключевые точки COCO |
| OBB | yolo26n-obb.pt | DOTAv1 |
| Классификация | yolo26n-cls.pt | ImageNet |
| Оценка глубины | yolo26n-depth.pt | Большой набор данных о глубине для помещений и улицы |
Backbone и neck переносятся без изменений; голова задачи частично переинициализируется в соответствии с количеством классов. Обучение с нуля имеет смысл только для очень больших датасетов из необычных предметных областей. Начни с модели nano (n), чтобы быстро получить базовый результат, и переходи к более крупным моделям, только если цикл работы с данными перестанет приносить улучшения. В руководстве по дообучению описано, что происходит внутри модели.
Запусти базовое обучение#
Используй настройки по умолчанию: цель первого запуска — получить базовый результат, а не рекорд. Модель обучается на разбиении учебного набора из раздела Как правильно разделить датасет; сначала создай YAML-файл с данными:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # в учебном наборе сохранены названия классов COCO
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # предобучена на COCO; используй чекпойнт для своей задачи
model.train(data="practice.yaml", epochs=3, imgsz=320)  # реальный запуск: epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486В папке запуска (runs/detect/train/) теперь находится weights/best.pt. Для первого запуска стоит рассмотреть только три аргумента:
| Аргумент | По умолчанию | Когда менять |
|---|---|---|
epochs | 100 | Меньше — для крошечных датасетов; 200–300 — для очень больших |
imgsz | 640 | 1024 или 1280, если в кадре много мелких объектов |
batch | 16 | -1 для автоматического выбора размера батча; уменьши значение при нехватке памяти |
В разделе Обучи свою первую модель подробно описаны вызов обучения и его текущий лог.
Ранжируй классы и анализируй пропуски#
Общее значение mAP скрывает источник проблемы. Ранжируй классы по AP50-95 и используй матрицу ошибок, чтобы разделить ошибки для каждого класса на объекты, которые модель вообще не заметила, и объекты, которым она присвоила другой класс:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another classКаждый тип ошибки указывает на своё исправление датасета:
- Слишком мало экземпляров в val (
fork,handbag,sink— по 1 экземпляру): AP — это шум. Не принимай решений по классу, пока в val не будет хотя бы нескольких десятков его экземпляров; сначала собери больше групп для val. - Пропуски (
car: 4 из 4,cup: 10 из 14): модель вообще не видит объект. Проверь, представлен ли этот сценарий в train, и найди отсутствующие метки с помощьюsuspect_labels.py. - Отнесены к другому классу (
cup: 4 из 14): определения классов пересекаются. Открой эти изображения, уточни определения и укажи в руководстве похожий класс.
Здесь важен вывод по cup: 14 размеченных экземпляров, ни один не найден.
Используй папку запуска для анализа данных#

Каждый запуск обучения сохраняет эти файлы, а на платформе Ultralytics во время облачного обучения в реальном времени отображаются те же графики:
| Файл | Что файл говорит о данных |
|---|---|
confusion_matrix_normalized.png | Какие классы путаются друг с другом или не распознаются на фоне |
BoxPR_curve.png | Точность и полнота по каждому классу; низкая кривая указывает на слабый класс |
val_batch0_pred.jpg | Предсказания на реальных изображениях val; ищи систематические пропуски |
labels.jpg | Количество классов и размеры рамок, на которых обучалась модель |
results.png | Кривые функции потерь и метрик; если функция потерь на val растёт, а на train падает, это сигнал о переобучении |
В разделе Валидация и диагностика разобраны все графики; здесь всегда нужно выяснить, каких данных не хватает.
Цикл с приоритетом данных#
Типичная итерация: выбери самый слабый класс с достаточным количеством экземпляров в val, проверь около 50 изображений с этим классом, исправь данные, переобучи модель с теми же настройками и разбиением, а затем сравни AP по классам. После этого переходи к следующему по слабости классу.
Если при одном и том же переобучении добавить 300 изображений и увеличить imgsz, ты не поймёшь, какое изменение повлияло на показатель. При работе с данными сохраняй настройки и разбиение без изменений, чтобы каждое сравнение отражало только одно изменение данных.
Когда переходить к настройке гиперпараметров#
После двух или трёх итераций по данным, когда оставшиеся слабые классы уже не связаны с охватом данных, разметкой или определениями, настройка может дать последние несколько пунктов прироста. В руководстве по дообучению описаны заморозка слоёв, темпы обучения и выбор оптимизатора. Но если настраивать модель до исправления данных, ты потратишь недели на оптимизацию модели для неправильного датасета.
Когда модель проходит acceptance_test.py на закрытом тестовом наборе, в Ultralytics YOLO в продакшене рассматриваются экспорт и развёртывание, а в разделах Мониторинг состояния и точности и Автоматизация цикла переобучения из Создание решений на платформе Ultralytics — цикл переобучения.
Показать решение
По результатам пробного запуска работать нужно с классом cup: в val размечено 14 объектов, 0 обнаружено, 10 пропущено, 4 отнесено к другому классу. План с конкретными объёмами:
| Результат | Действие с датасетом | Объём |
|---|---|---|
| 10 из 14 чашек пропущены | Проверь покрытие в train: посчитай изображения с чашками по камерам и дням съёмки; собери изображения с чашками в группах, где их нет | 40 новых изображений с чашками за 4 дня съёмки |
| 4 из 14 отнесены к другому классу | Открой их в val_batch0_pred.jpg и матрицу ошибок; если они отнесены к wine glass или bowl, добавь оба похожих класса в описание cup | Переразметь около 30 изображений из train по новым правилам |
| Классы с 1 экземпляром | Пока ничего не предпринимай; добавь группы val, в которых они встречаются | Следующий этап сбора данных |
Затем переобучи модель с epochs, imgsz и тем же разбиением, повторно запусти rank_classes.py и сравни AP для cup до и после. Если показатель вырос, узким местом были данные; если нет, проверь следующие 50 изображений, прежде чем менять гиперпараметр.