Валидация и диагностика
Проверь best.pt на фоне базового результата, изучи матрицу ошибок, показатели по классам и изображения с предсказаниями, а затем составь список конкретных исправлений.
Одно число mAP показывает, насколько ошибается модель, но не в чём именно. Пропуск небольших объектов, путаница между двумя классами и неточные рамки снижают mAP, но для каждой проблемы требуется своё решение. Если ошибиться с диагнозом, можно неделю собирать не те данные.
В этом уроке ты запустишь режим Val на best.pt, сравнишь результат с базовым и изучишь матрицу ошибок и изображения с предсказаниями, чтобы составить список исправлений для следующего цикла. Руководство по метрикам производительности — подробное дополнение к этому уроку.
Практические занятия
Пример: валидация best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
Реальный вывод val.py:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
Графики сохраняются в новую папку runs/detect/val (затем val-2 и т. д.). Сравни эти значения с базовыми:
| Модель | mAP50 | mAP50-95 |
|---|---|---|
Предварительно обученная yolo26n.pt (без класса таблеток) | 0.001 | 0.0002 |
pills_v1 (10 эпох, imgsz 320, CPU) | 0.977 | 0.659 |
Что говорят цифры:
- Точность 0.970, полнота 0.957: баланс соблюдён. Ложных срабатываний мало, пропусков тоже.
- mAP50 0.977: при невысоких требованиях к перекрытию модель находит почти все таблетки.
- mAP50-95 0.659: при строгих требованиях к перекрытию многие рамки недостаточно точны. Такой большой разрыв указывает на проблему локализации — стоит увеличить число эпох, взять более крупный
imgszили точнее разметить данные, а не искать недостающие данные.
О компромиссе между точностью, полнотой и mAP читай в статье Как объективно оценивать метрики детекции.
Какой файл отвечает на какой вопрос#
| Вопрос | Файл |
|---|---|
| Какие классы путаются и какие пропускаются? | confusion_matrix_normalized.png |
| Как для каждого класса меняется точность при повышении полноты? | BoxPR_curve.png |
| Какой порог уверенности выбрать для развёртывания? | BoxF1_curve.png: его максимум — хорошая отправная точка для conf |
| Как выглядят ошибки? | val_batch0_labels.jpg и val_batch0_pred.jpg |
| Модель переобучается? | results.png в папке обучения |
Как читать матрицу ошибок#
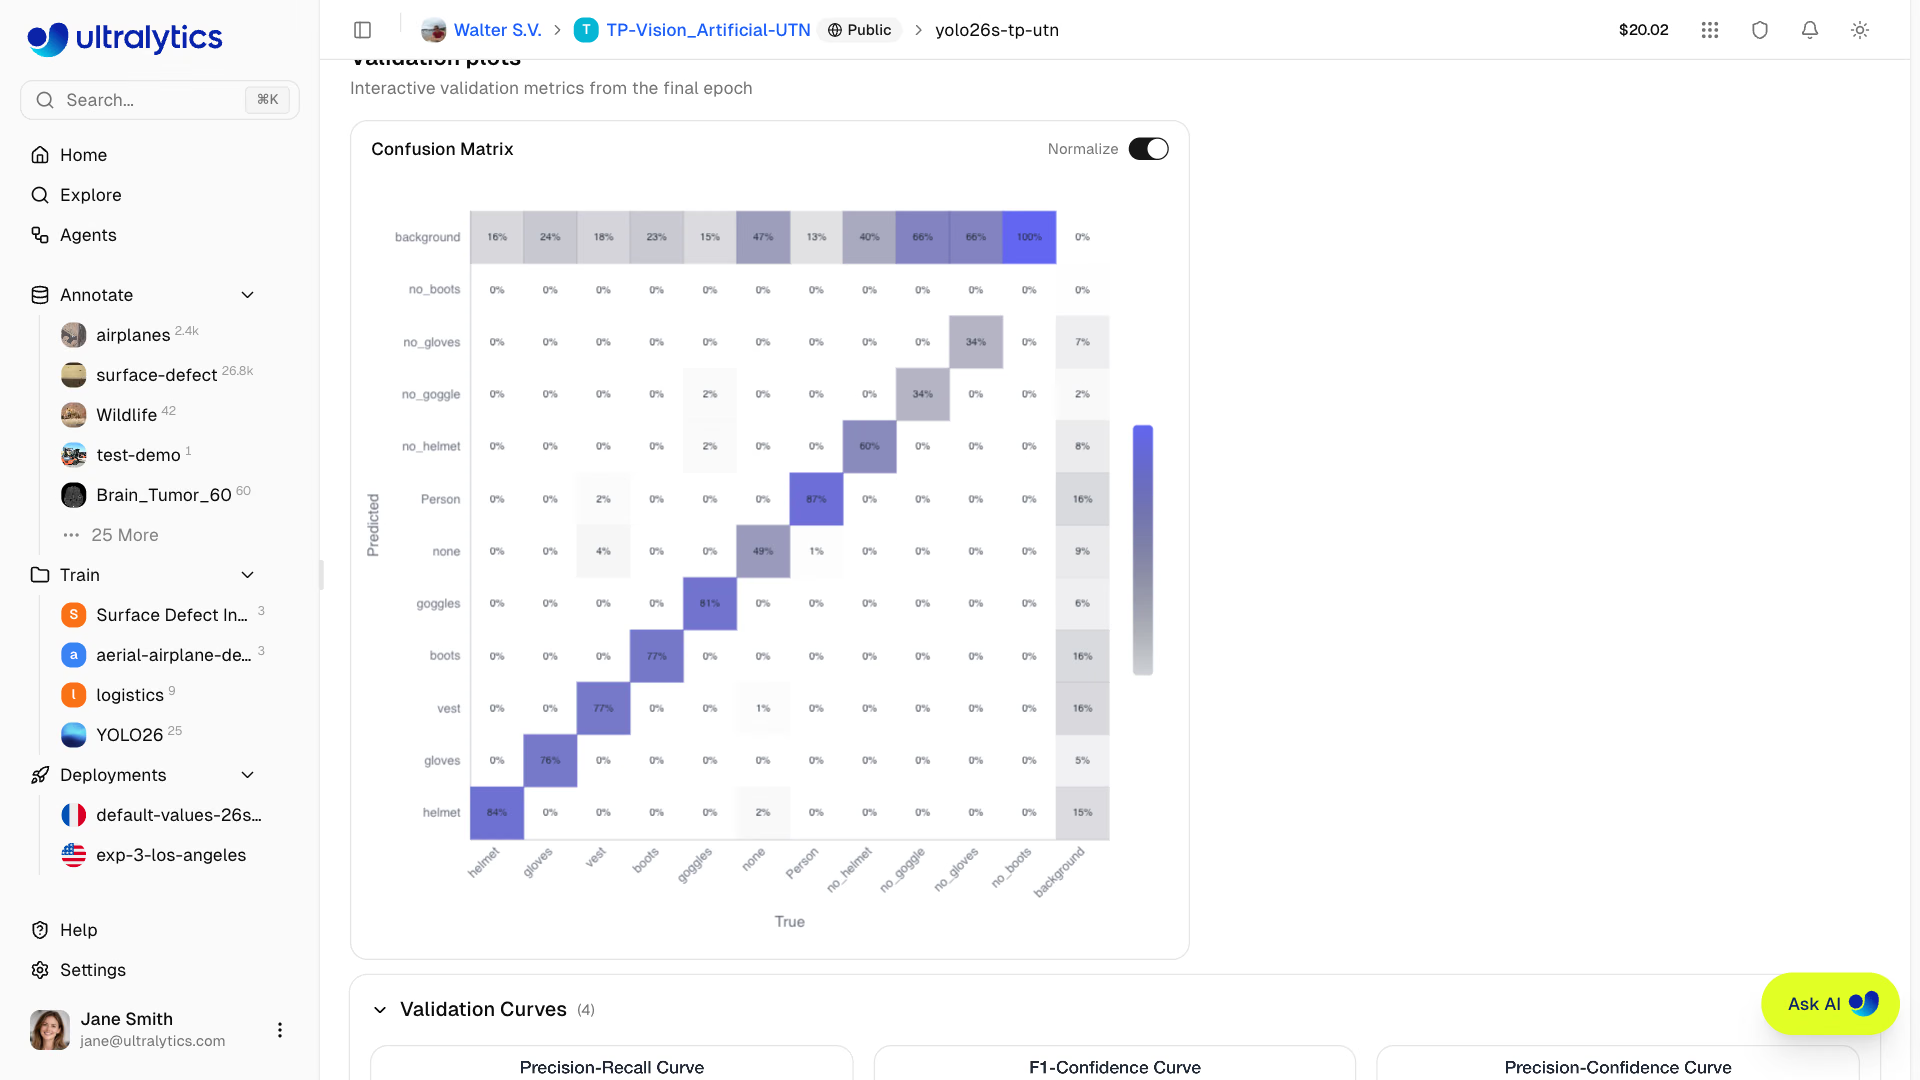
Матрица ошибок — самый полезный диагностический инструмент. На графиках Ultralytics столбцы соответствуют истинным классам, а строки — предсказанным, плюс есть дополнительная строка и столбец background. В нормализованной матрице каждый столбец делится на сумму своих значений, поэтому видно, куда попали объекты каждого класса. В наборе Pills только один класс, поэтому потренируемся на этом примере со складом и тремя классами (цифры для иллюстрации):
| Предсказанный ↓ / Истинный → | погрузчик | человек | поддон | Фон |
|---|---|---|---|---|
| погрузчик | 0.78 | 0.03 | 0.18 | 0.45 |
| человек | 0.04 | 0.91 | 0.00 | 0.20 |
| поддон | 0.10 | 0.00 | 0.65 | 0.35 |
| фон | 0.08 | 0.06 | 0.17 | — |
- Диагональ: доля объектов каждого класса, распознанных верно. Поддоны — слабый класс с показателем 0.65.
- Вне диагонали: ошибки классификации. 18% настоящих поддонов модель предсказала как погрузчики, а 10% погрузчиков — как поддоны.
- Строка фона: пропуски. 17% поддонов вообще не были обнаружены.
- Столбец фона: ложноположительные срабатывания — рамки на пустом месте. В 45% таких случаев модель предсказала погрузчик.
Для каждого типа ячейки есть своё решение:
| Сценарий | Решение |
|---|---|
| Два класса путаются друг с другом | Добавь примеры, которые помогут их различить: погрузчики с поддонами и поддоны, сложенные рядом с погрузчиками |
| Много значений в строке фона (пропуски) | Добавь больше примеров этого класса в условиях, где модель его пропускает |
| Много значений в столбце фона (ложные срабатывания) | Добавь фоновые изображения сцен, которые провоцируют такие срабатывания, например пустых проходов |
Как читать показатели по классам#
При наличии нескольких классов валидационный журнал выводит отдельную строку для каждого класса, а в metrics.box.maps хранятся значения mAP50-95 по классам для работы с кодом. Продолжим пример со складом:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
Показатель pallet намного ниже остальных, а в валидационной выборке всего 7 экземпляров этого класса. Возможно, модель плохо распознаёт поддоны, а возможно, данных для валидации слишком мало, чтобы это определить. В обоих случаях нужно сделать одно и то же: собрать больше изображений поддонов для обучения и валидации.
Изучи ошибки#
Открой рядом val_batch0_labels.jpg и val_batch0_pred.jpg. Разница между ними покажет ошибки в виде изображений, а закономерности в этих ошибках помогут поставить диагноз: пропуски у края изображения, мелкие объекты, определённое освещение или похожие объекты, которые легко спутать. Такие закономерности в наборе данных почти всегда важнее настройки гиперпараметров.
На валидационных изображениях модели для таблеток хорошо видимые таблетки получают оценку около 1.0. Рамки с низкой уверенностью, около 0.3–0.5, группируются вокруг таблеток, частично закрытых другой блистерной упаковкой, и таблеток, обрезанных краем изображения. Это не исправить настройкой conf — здесь нужно определить правила разметки. Считать ли таблетку, видимую наполовину? Реши, зафиксируй правило и размечай все изображения одинаково.
Затем открой results.png. Потери на обучении и валидации должны снижаться вместе. Если потери на обучении продолжают снижаться, а на валидации растут, модель переобучается; если оба показателя остаются высокими, модель недообучается. В обоих случаях поможет разобраться компромисс между смещением и разбросом.
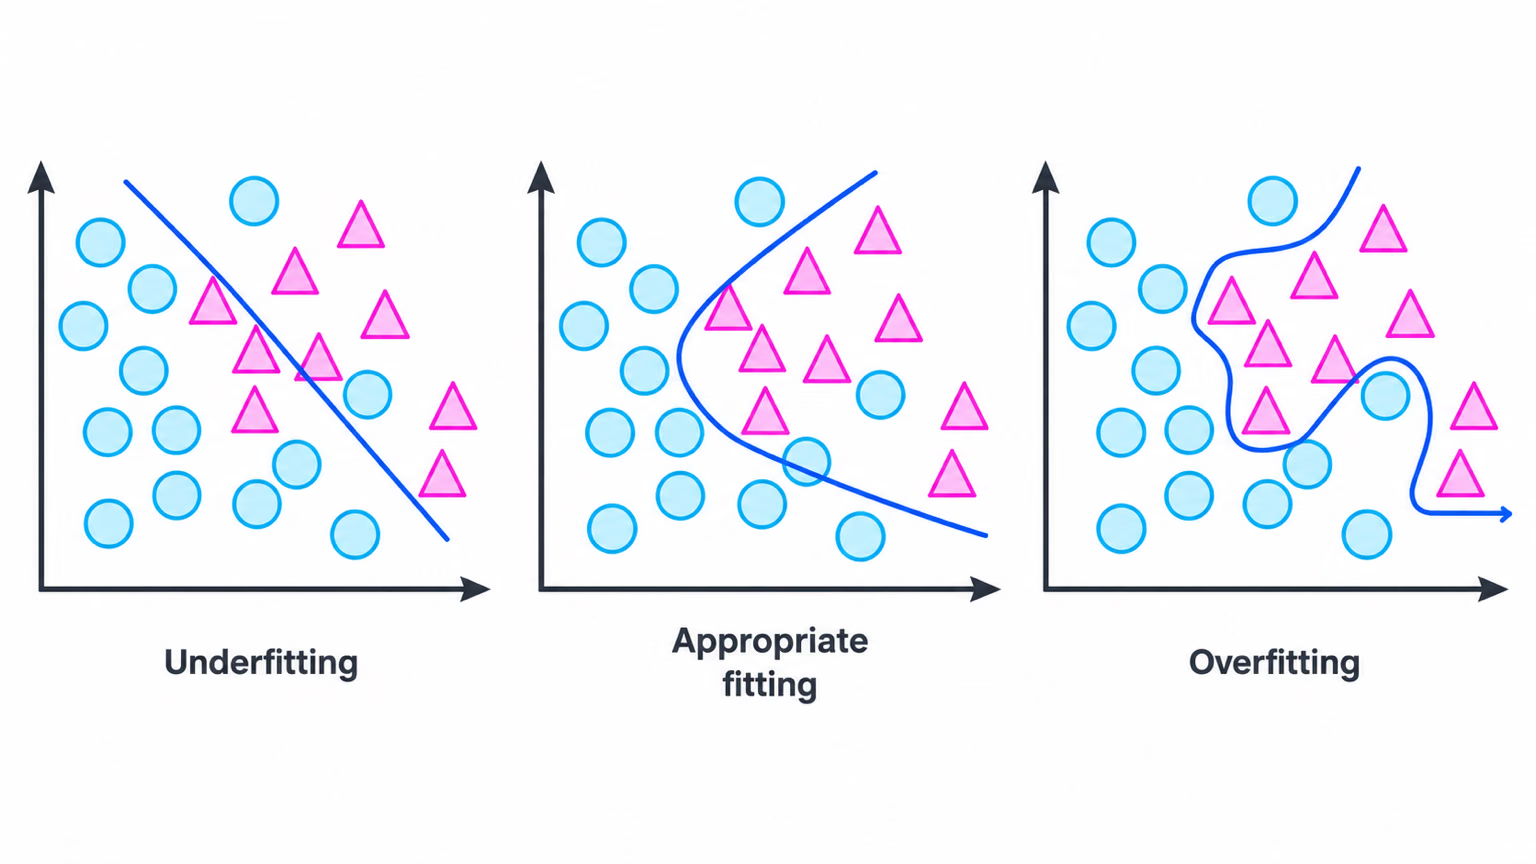
При переобучении исправления по убыванию эффективности: разнообразить данные; уменьшить число эпох или использовать более строгий patience; добавить аугментацию данных (hsv_h, degrees, translate, scale, fliplr, mosaic, ...). Параметры аугментации по умолчанию уже хорошо подобраны; меняй их только при наличии причины, например отключи fliplr, если важны различия между левой и правой сторонами.
Преврати выводы в список исправлений#
Сначала исправь данные, а потом настраивай гиперпараметры; меняй по одному параметру за раз, чтобы понимать, что помогло. Работа с набором данных в этом цикле описана в статье Первая тонкая настройка и цикл итераций.
Избегай этих ошибок#
Симптом: модель, получившая 0.659 mAP50-95, внезапно показывает 0.403. Причина: pills_v1 обучалась при imgsz=320, а проверялась при imgsz=640; объекты выглядят вдвое крупнее всего, чему она обучалась. Решение: проводи валидацию и развёртывание при обучающем imgsz и сравнивай запуски только при одинаковом размере.
Валидация выполняется при conf=0.001, чтобы построить полную кривую precision-recall, поэтому в val_batch0_pred.jpg видны рамки, которые приложение никогда бы не показало. Выбери порог для развёртывания на основе BoxF1_curve.png, а затем проверь его с помощью predict.
На 23 изображениях precision за одну эпоху изменился с 0.93 до 0.80 и обратно. Оценивай тенденции на нескольких эпохах и запусках, а прежде чем доверять разнице в один-два пункта, увеличь валидационный набор.
Показать решение
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.